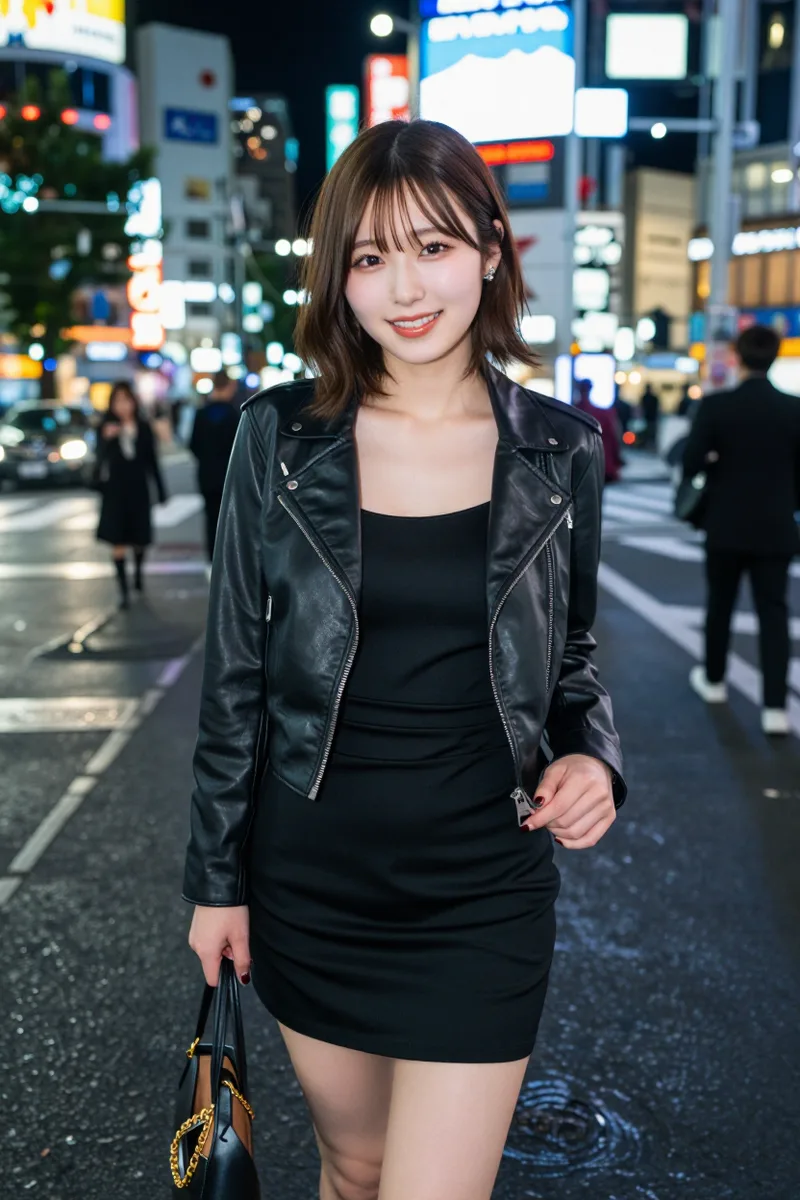
AI美女を同じ顔で何枚も作る|ChatGPT・ComfyUI・Kling・Higgsfieldで顔をそろえてみた

公開日
生成例
91枚
カテゴリ
やってみた
AI美女を同じ顔で何枚も作る|ChatGPT・ComfyUI・Kling・Higgsfieldで顔をそろえてみた

AI美女を同じ顔のまま何枚も作るなら、いちばん簡単で、しかもしっかりそろったのは ChatGPT でした。元の1枚を渡して「この人のまま、服と場所だけ変えて」と頼むだけで、カフェと夜の渋谷の8枚とも同じ人に見えます。

ComfyUI は、元の1枚を渡せる画像編集のモデル(Qwen-Image-Edit-2511・FLUX.2 [klein])でも、場所や光まで変えると「似た別人」になりました。顔が残ったのは、背景も光もそのままで服だけ変えたときです。Higgsfield の Soul ID は、20枚で学習すると水着まで含めて12枚中10枚が本人でした。動画は Kling 3.0 が1本の中でよく顔を保ち、遠くで振り返る場面だけ崩れています。

先に結論:方法ごとの、そろった枚数

同じ元の1枚から、カフェ(腰から上)・夜の渋谷(全身)・プールの水着の3場面を作り、元の1枚と並べて「同じ人に見えるか」で数えました。動画は、1本の中で顔が変わらないかを見ています。

方法 そろった枚数(カフェ・夜・水着) お金 手間 安全審査
ChatGPT に元の1枚を渡す4・4・作れずChatGPT の契約の中いちばん少ない元の写真で水着に着替えさせる頼み方は、4回とも止められた
ComfyUI:説明文とシード値だけ1・1・11枚 約0.1セント少ない止められない
ComfyUI:Qwen-Image-Edit-2511 で服と場所を変える1・0・11枚 約0.2セントワークフローを組む止められない
ComfyUI:FLUX.2 [klein] で服と場所を変える0・0・01枚 約0.15セントワークフローを組む止められない
ComfyUI:背景も光もそのままで、服だけ変えるQwen 4・klein 4(スタジオのまま)同上ワークフローを組む止められない
Kling 3.0:本人の1枚を最初のコマにするカフェは最後まで本人。夜は遠くで振り返った顔が崩れた5秒 6.25クレジット少ない止められなかった
Kling 3.0:正面・斜め・横の3枚も渡す2本とも最後まで本人。ただし夜は背中を向ける動きをしなかった5秒 6.25クレジット3枚を用意する止められなかった
Higgsfield:Soul ID で学習して Soul 2.0 で作る4・3・3学習 25クレジット、1枚 約0.12クレジット20枚を用意して学習(10分ほど)水着も止められなかった
Higgsfield:Soul ID の人物で Seedance 2.0 の動画動きは頼んだとおり。顔は最初から少し大人びた似た人5秒 5クレジット(480p)少ない止められなかった

ComfyUI の画像編集のモデルは、4枚どうしはそっくりにそろいます。ただ、その顔が元の1枚とは別の人なんですよね。「そろう」と「元の人のまま」は別物、というのが今回いちばんの発見でした。

元にした1枚と、試し方

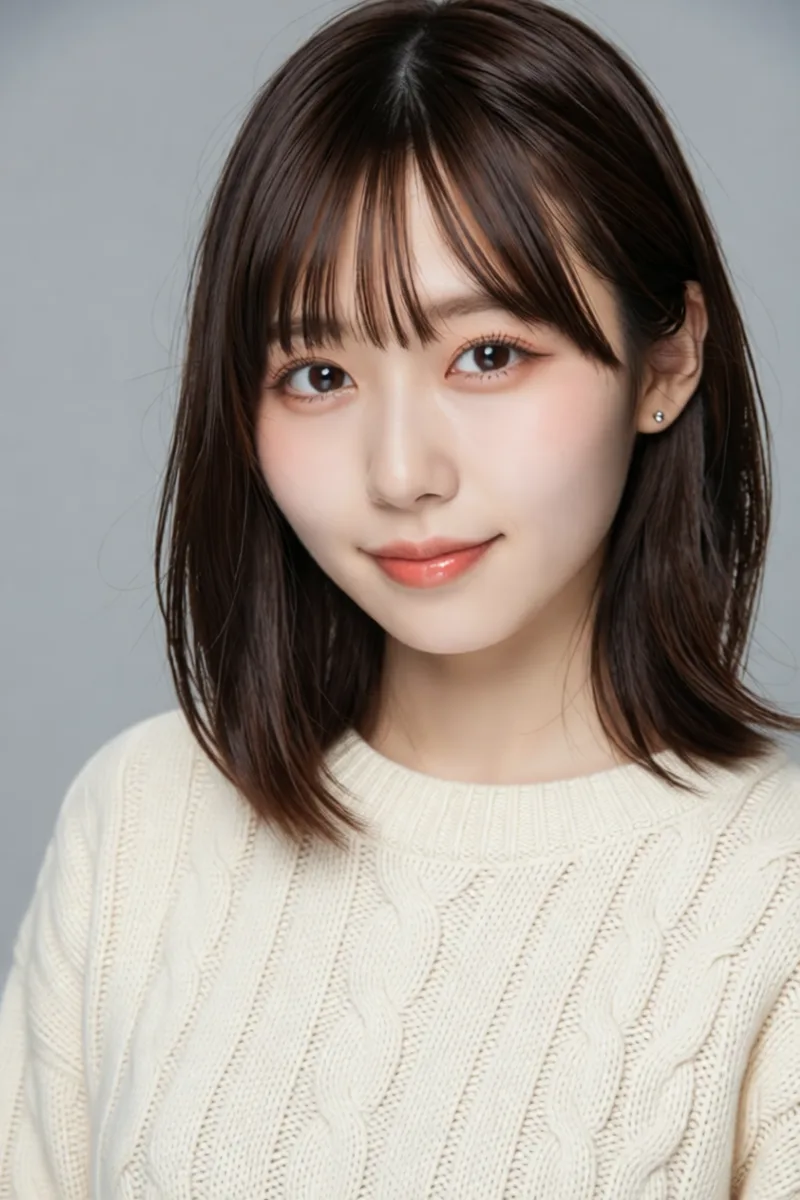
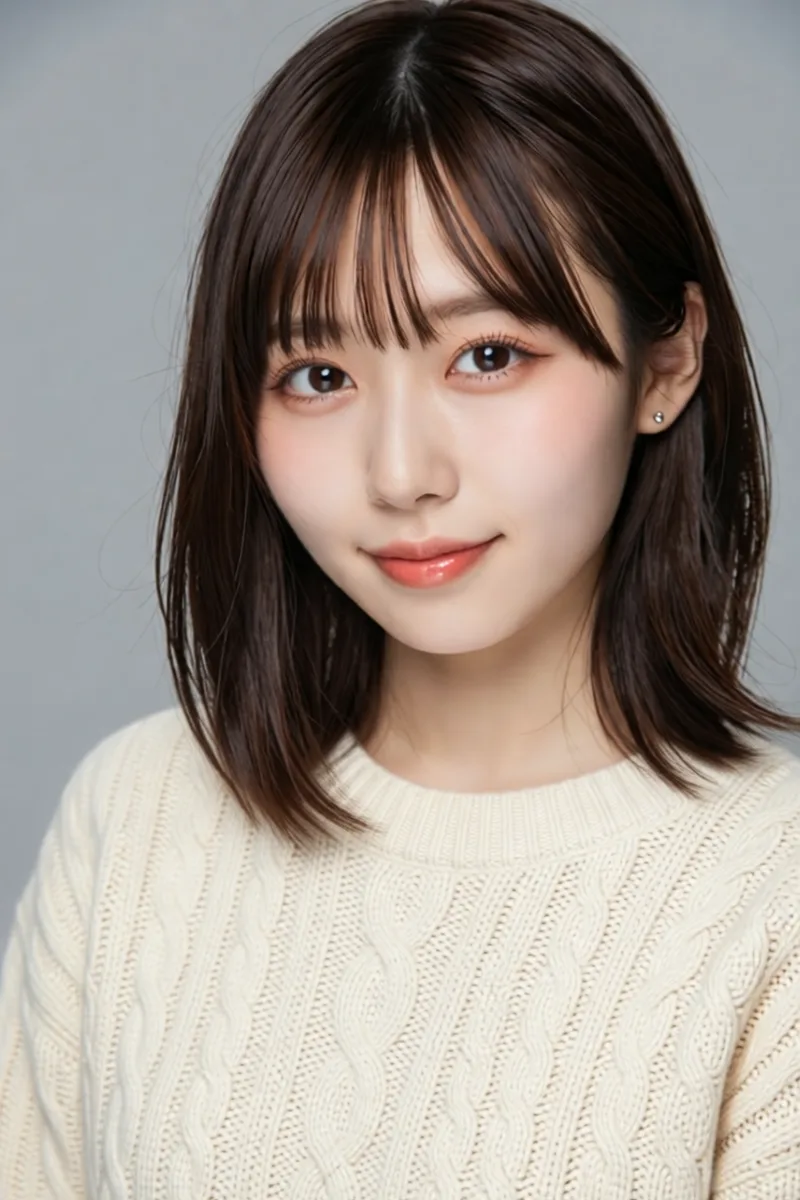
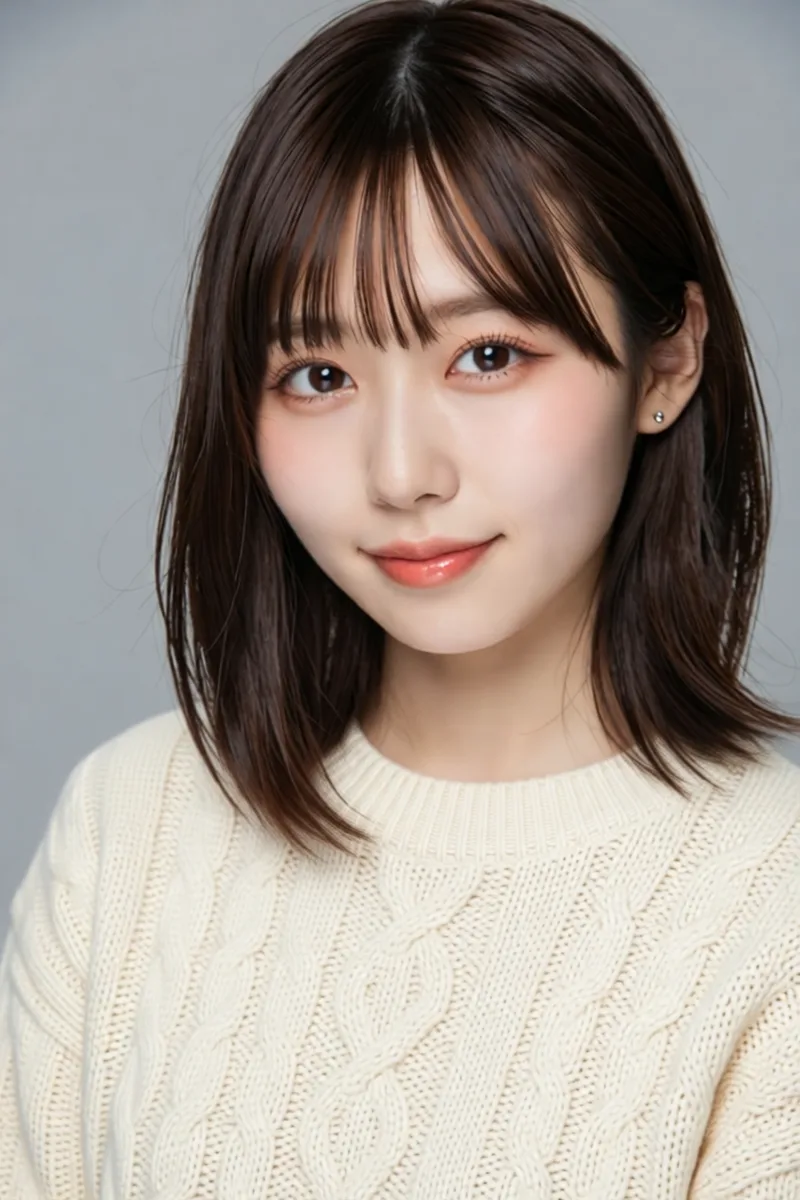
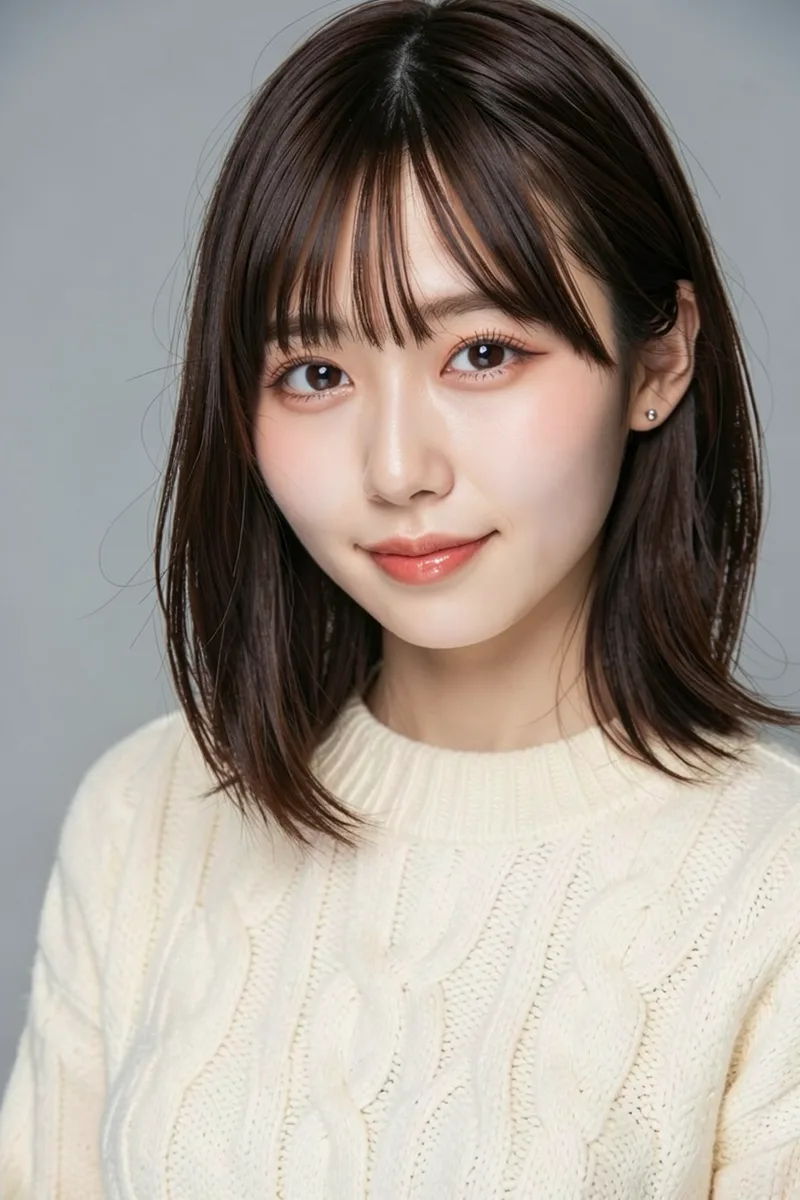
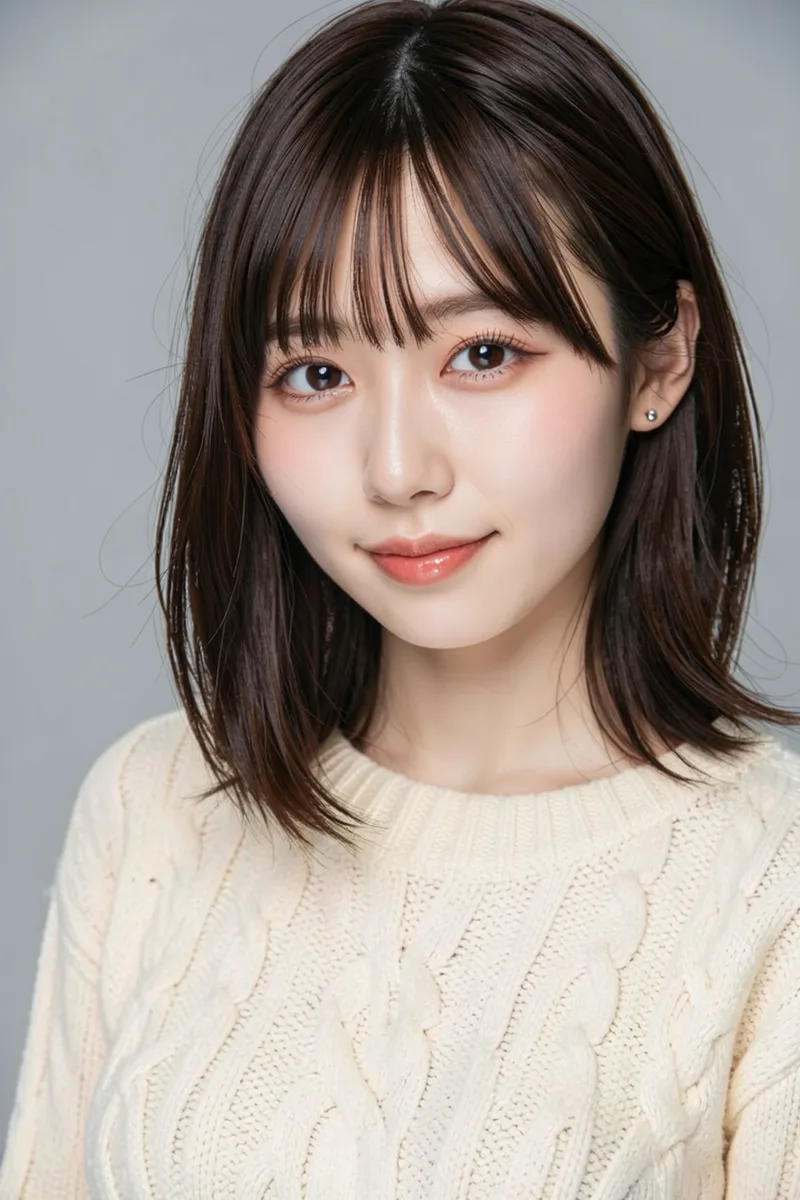
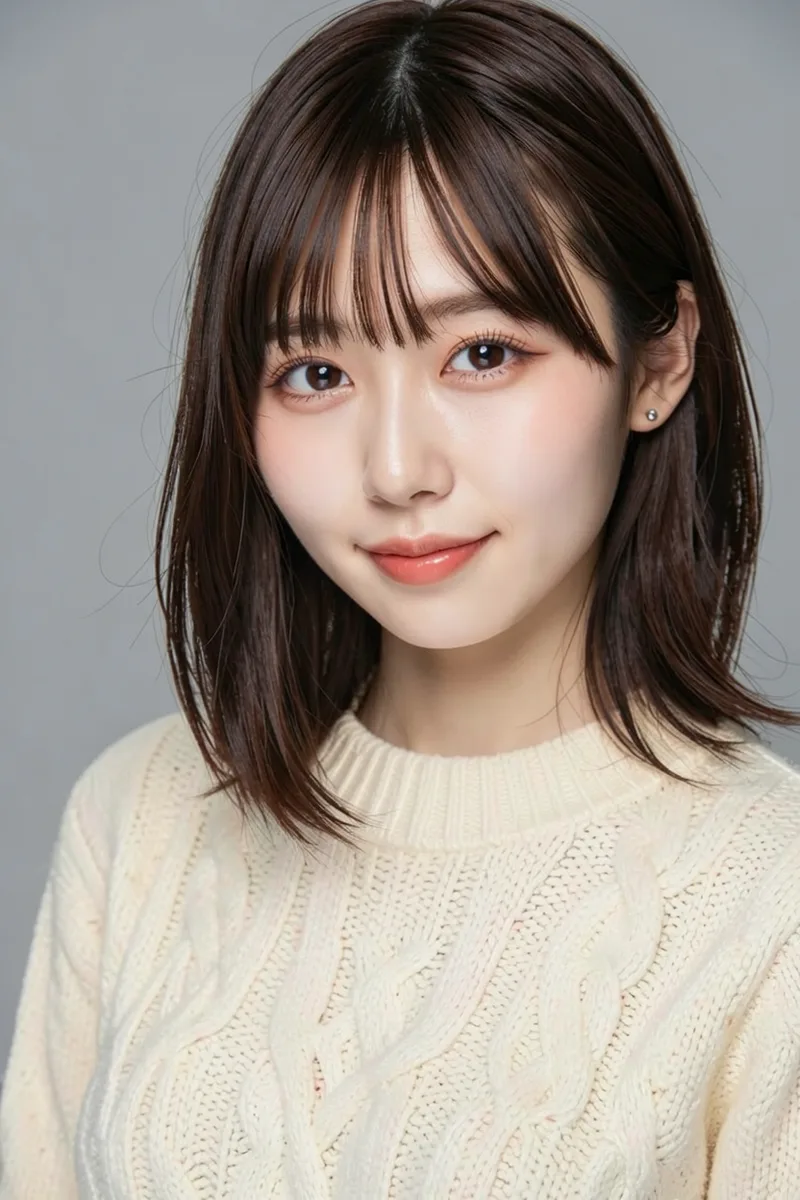
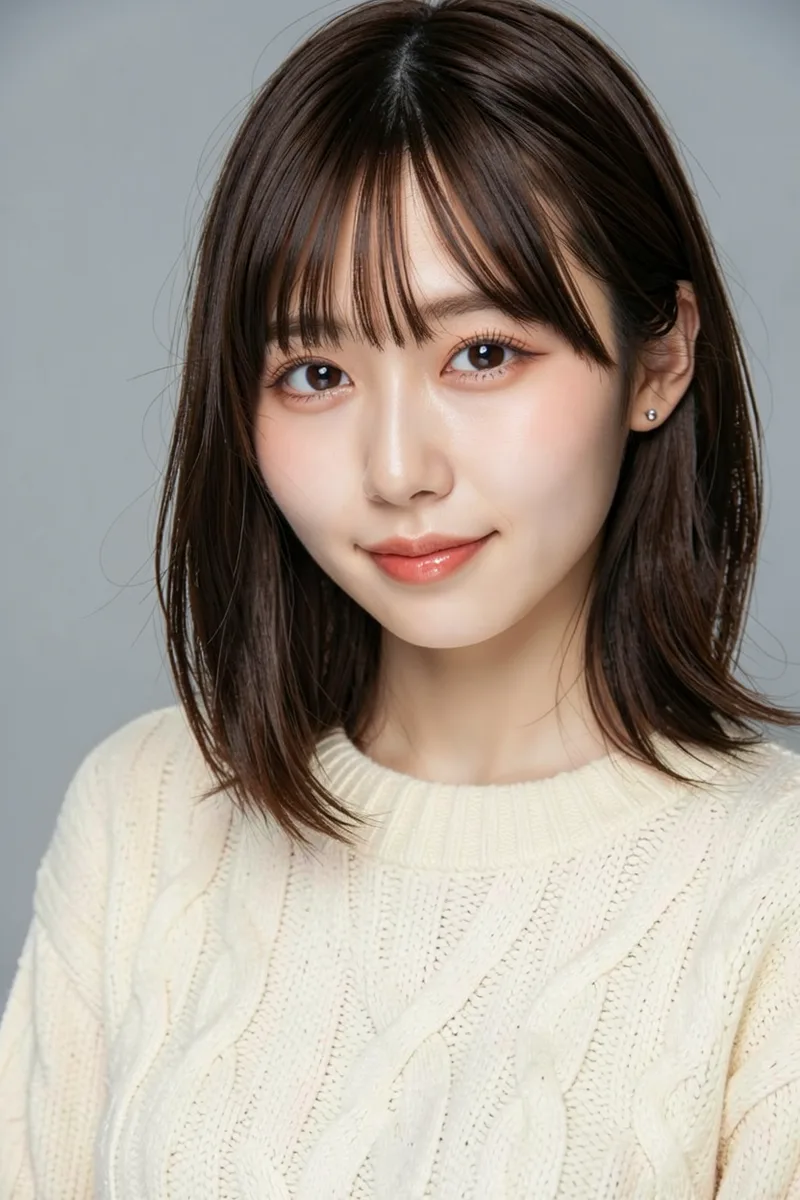
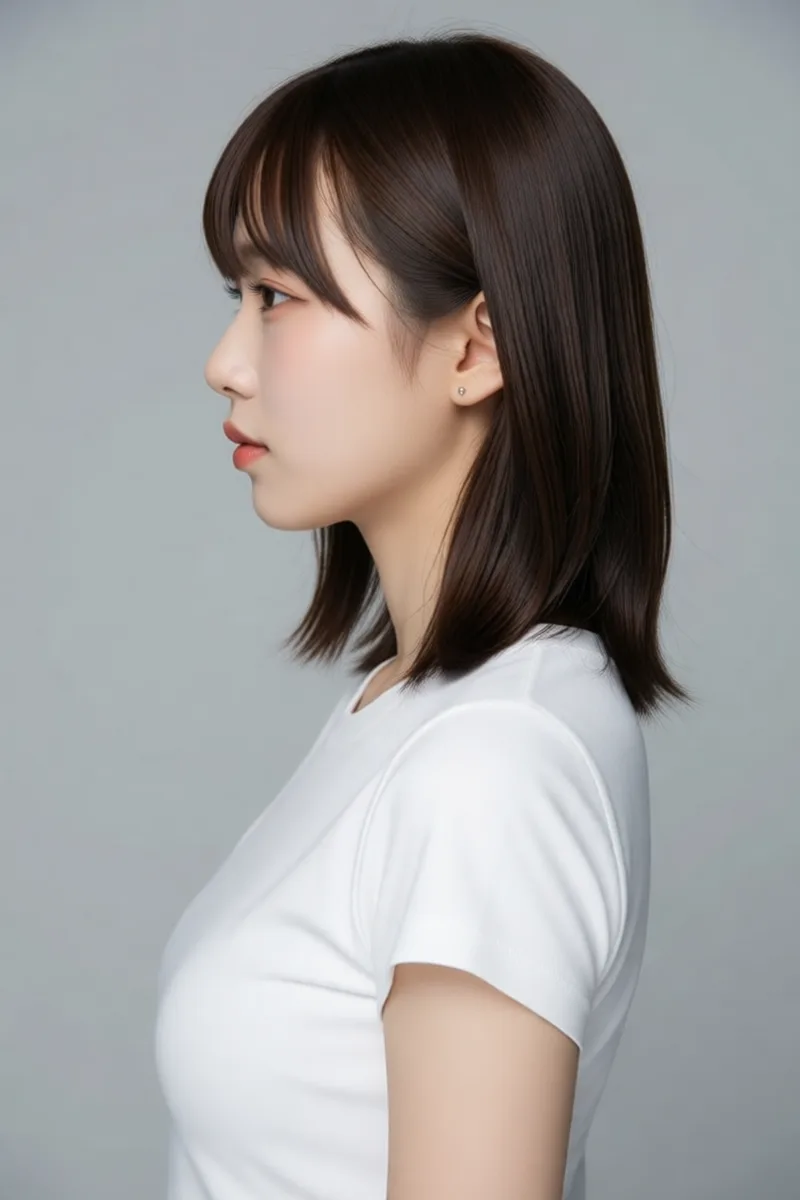
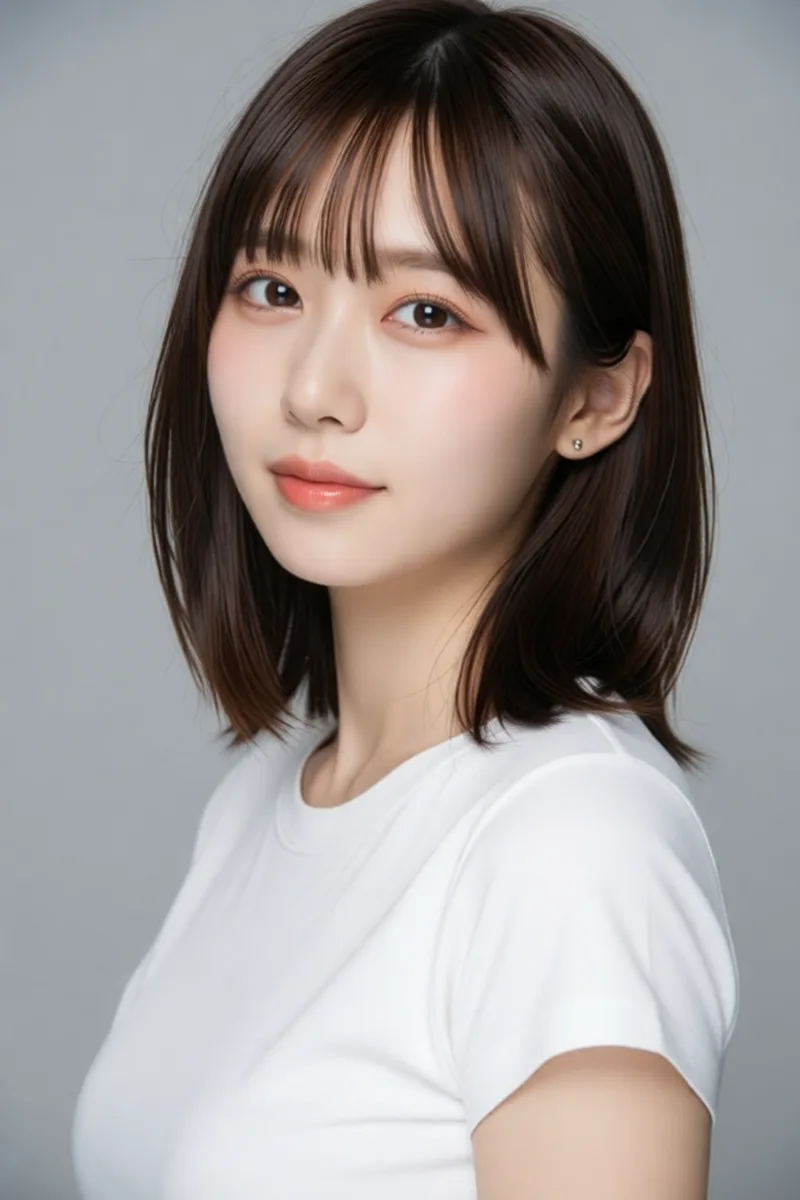
元の1枚は、ComfyUI(Comfy Cloud)の HARUKI_MIX で作った、肩までの髪にシースルーの前髪の20歳の女性です。白い T シャツで、グレーのスタジオで撮った胸から上の写真にしました。シード値は 2510。実在の人の写真は、どの方法でも一度も使っていません。
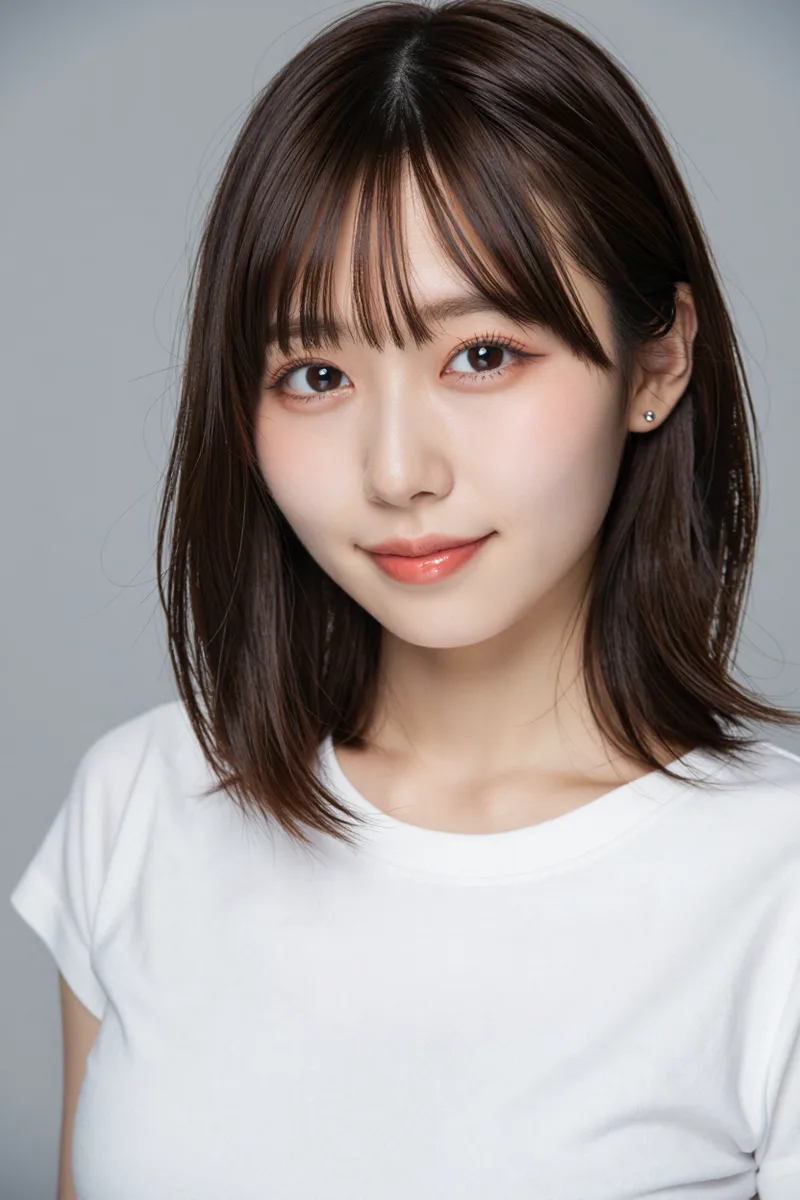
元にした1枚(ComfyUIのHARUKI_MIXで作った20歳の女性)
元の1枚のプロンプト
Photorealistic portrait photograph of a beautiful 20-year-old Japanese woman, stylish Tokyo fashion model look, defined eyes with soft brown eyeliner, glossy peach-pink lips, glossy dark brown hair in a chin-length bob with see-through bangs, one side tucked behind her ear, small silver stud earrings, wearing a plain white t-shirt, chest-up, facing the camera with a soft smile, plain light gray studio background, soft even light, shot on an 85mm lens

ComfyUI は、画像を作る手順を部品(ノード)でつないで組む画像生成のツールで、今回はクラウドで動く Comfy Cloud(Creator プラン)を使いました。HARUKI_MIX ZIT2606Real は、Z-Image Turbo をもとにした写真向けのモデル(9ステップ・cfg 1・res_multistep・simple)。1枚ごとにクレジットを使うので、残高の差で測ってみると、Z-Image が1枚約0.11セント、Qwen-Image-Edit-2511 が約0.22セント、FLUX.2 [klein] が約0.14セントでした。

場面は3つに決めて、どの方法でも同じ服・同じ場所を頼みました。大きさは全部 2:3 の縦長です(ChatGPT は 1024×1536、ComfyUI は 832×1248)。

場面 頼んだ服と場所(プロンプトの差し替え部分)
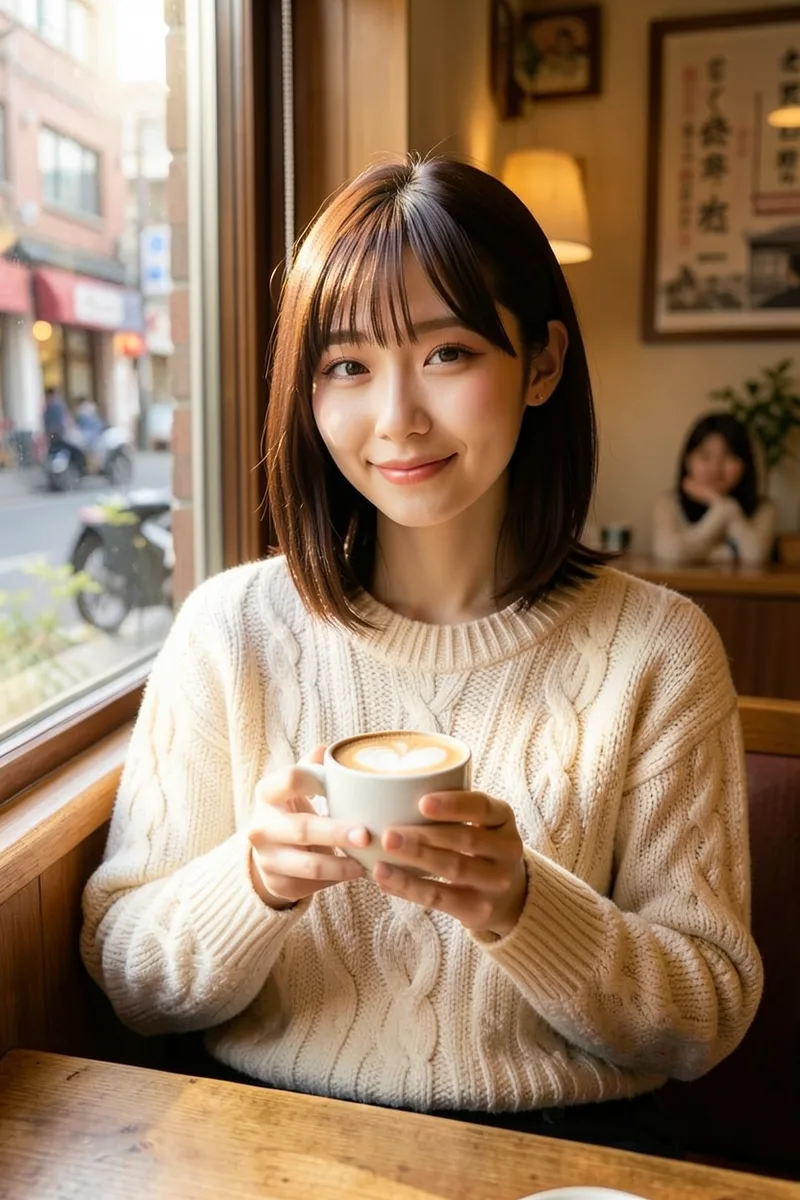
カフェ(腰から上)wearing a cream cable-knit sweater, waist-up, sitting at a window seat in a cozy Tokyo cafe holding a latte with both hands, soft smile, warm daylight from the window
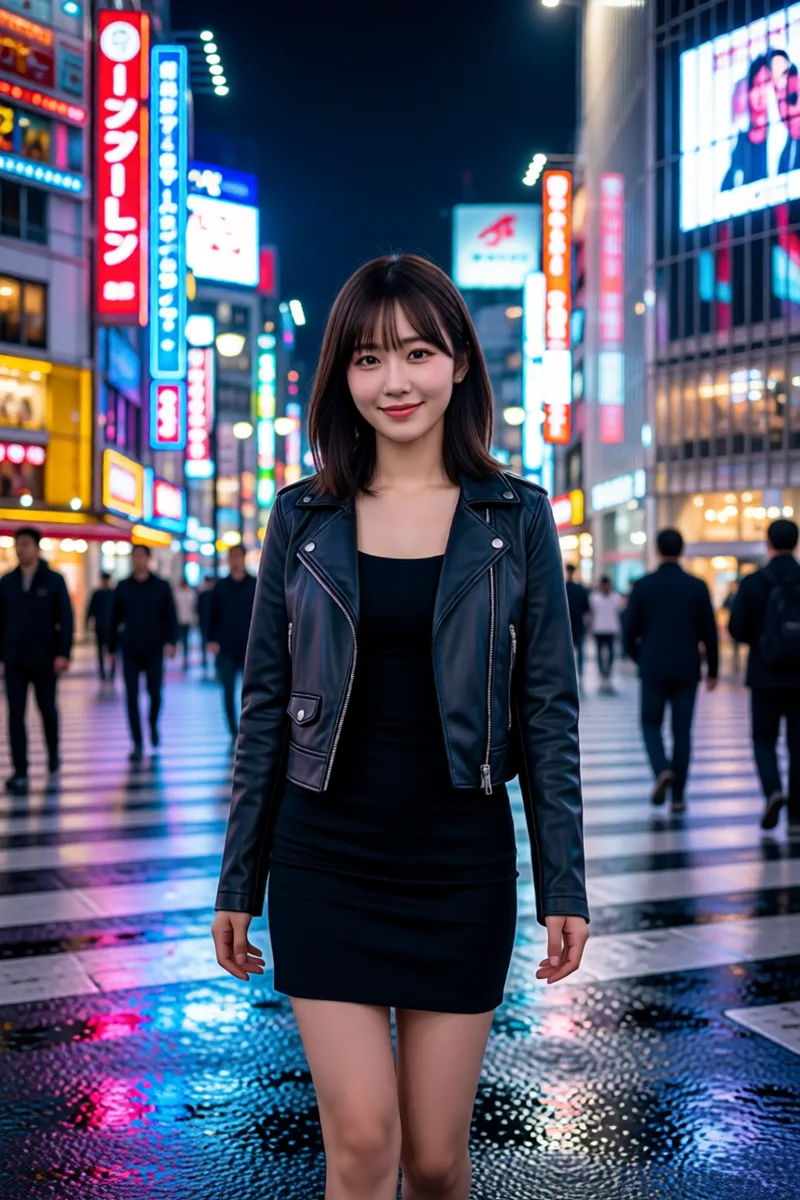
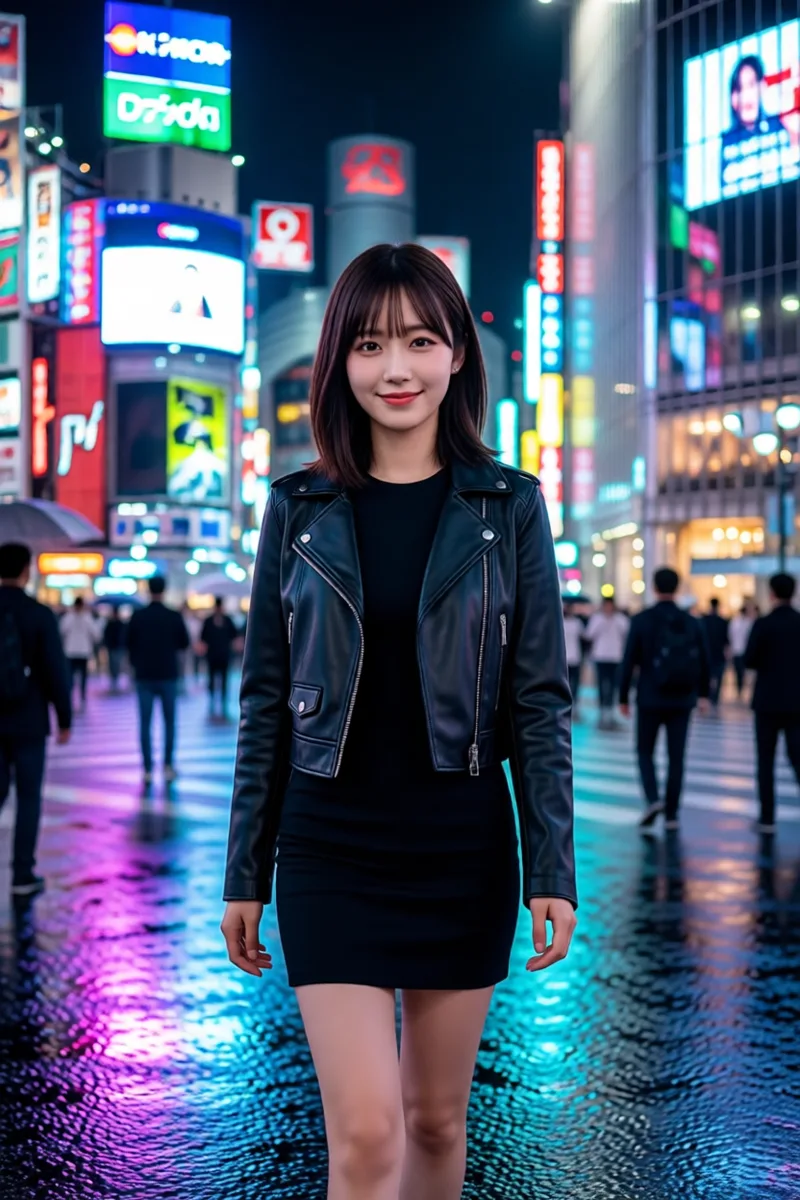
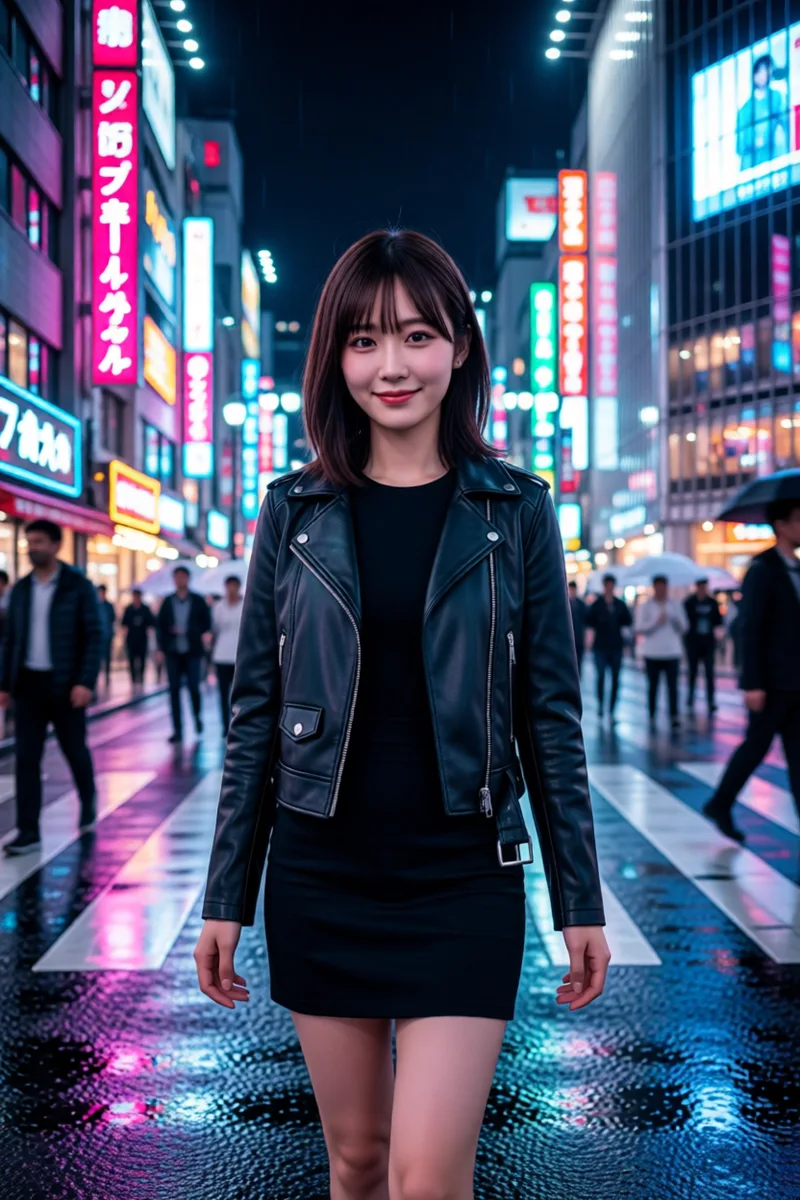
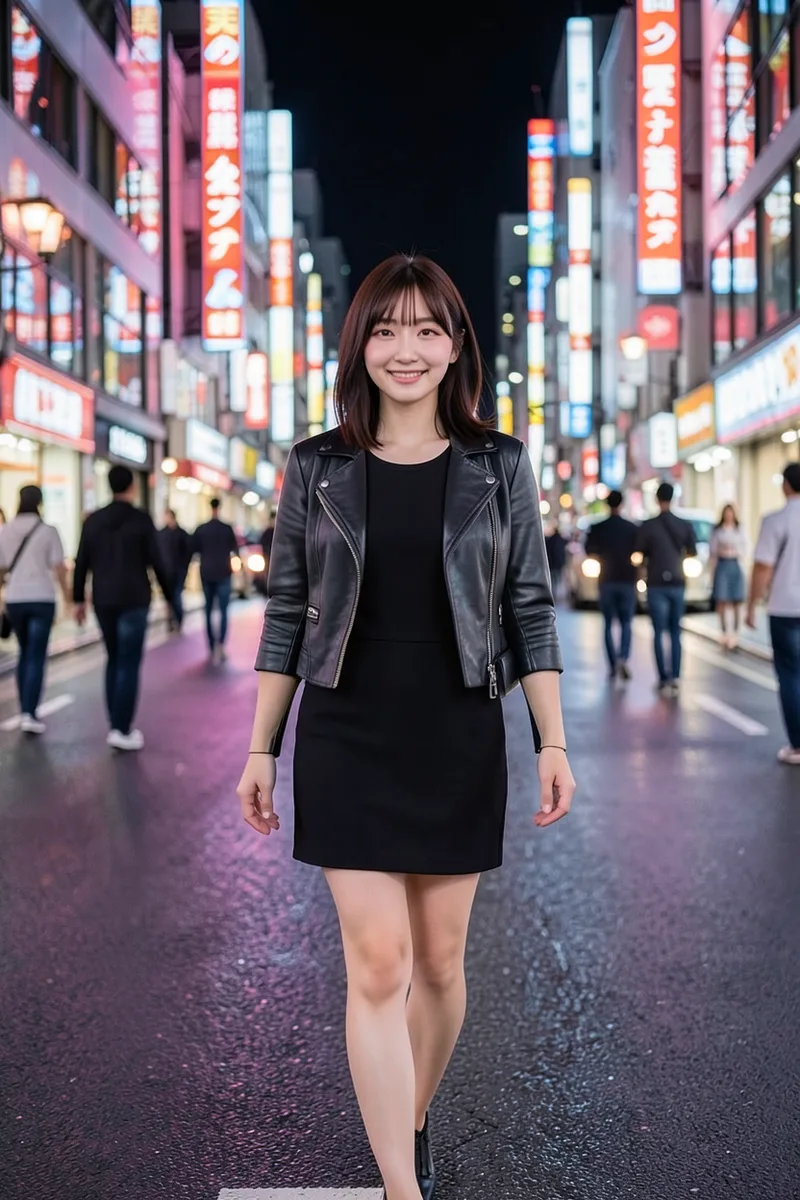
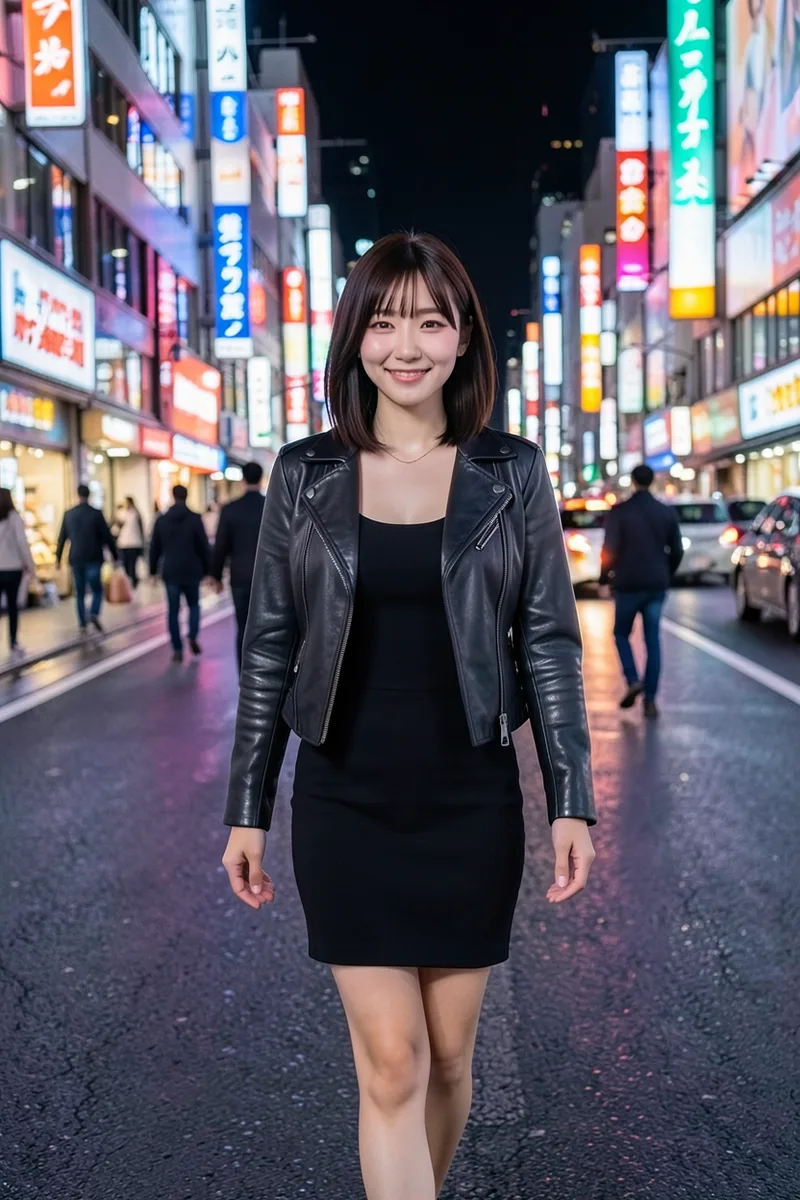
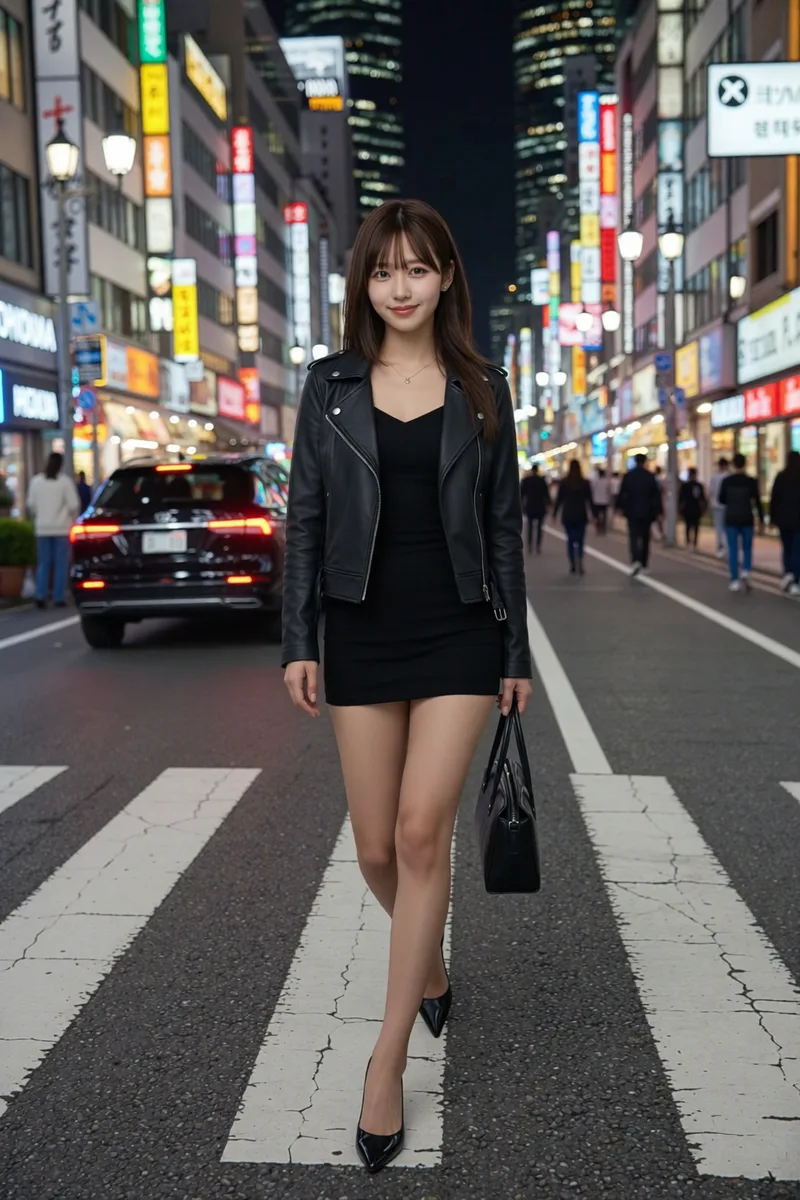
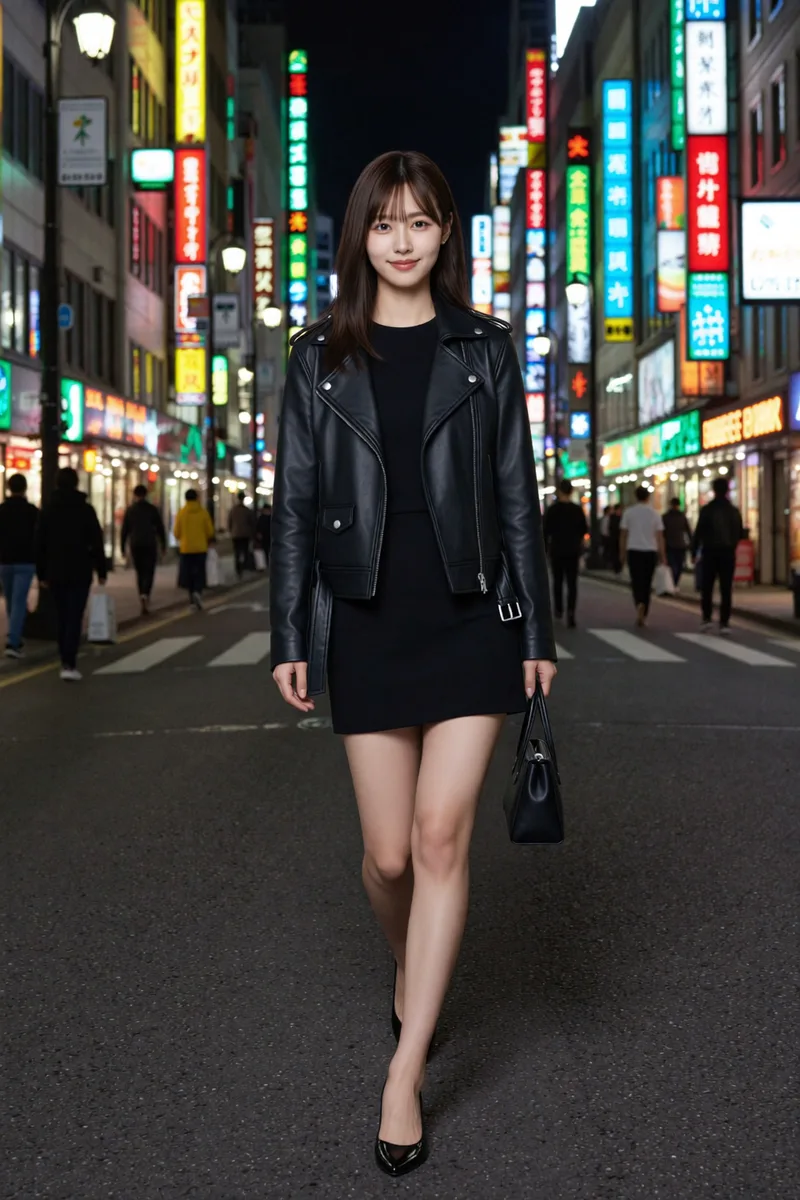
夜の渋谷(全身)wearing a black mini dress and a short black leather jacket, full-body shot walking on a neon-lit Shibuya street at night, soft smile, glowing city lights
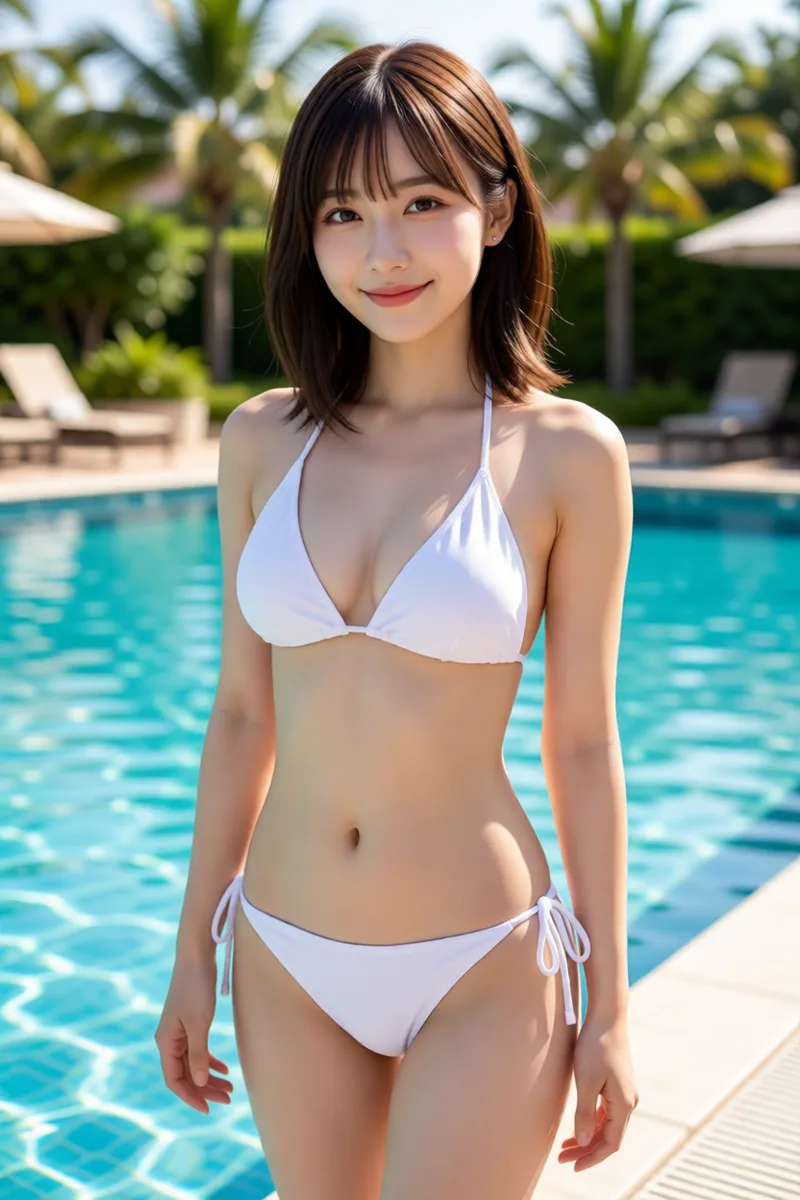
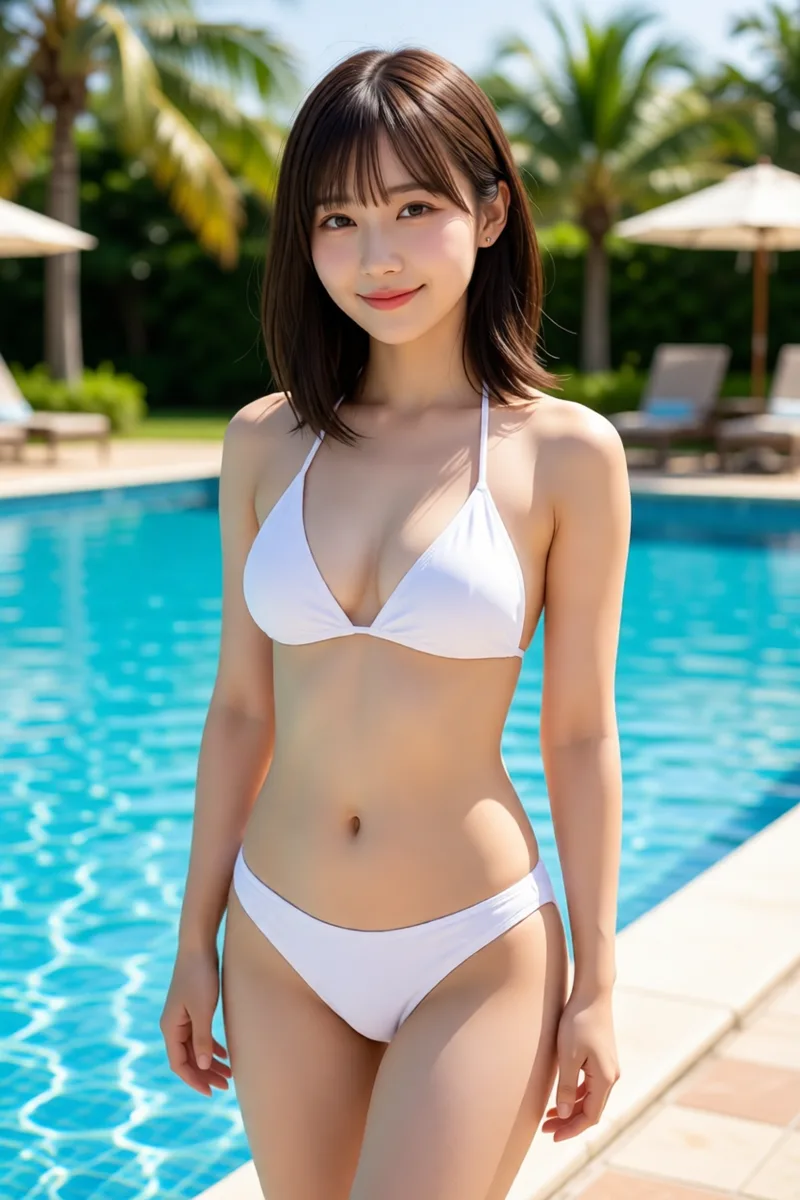
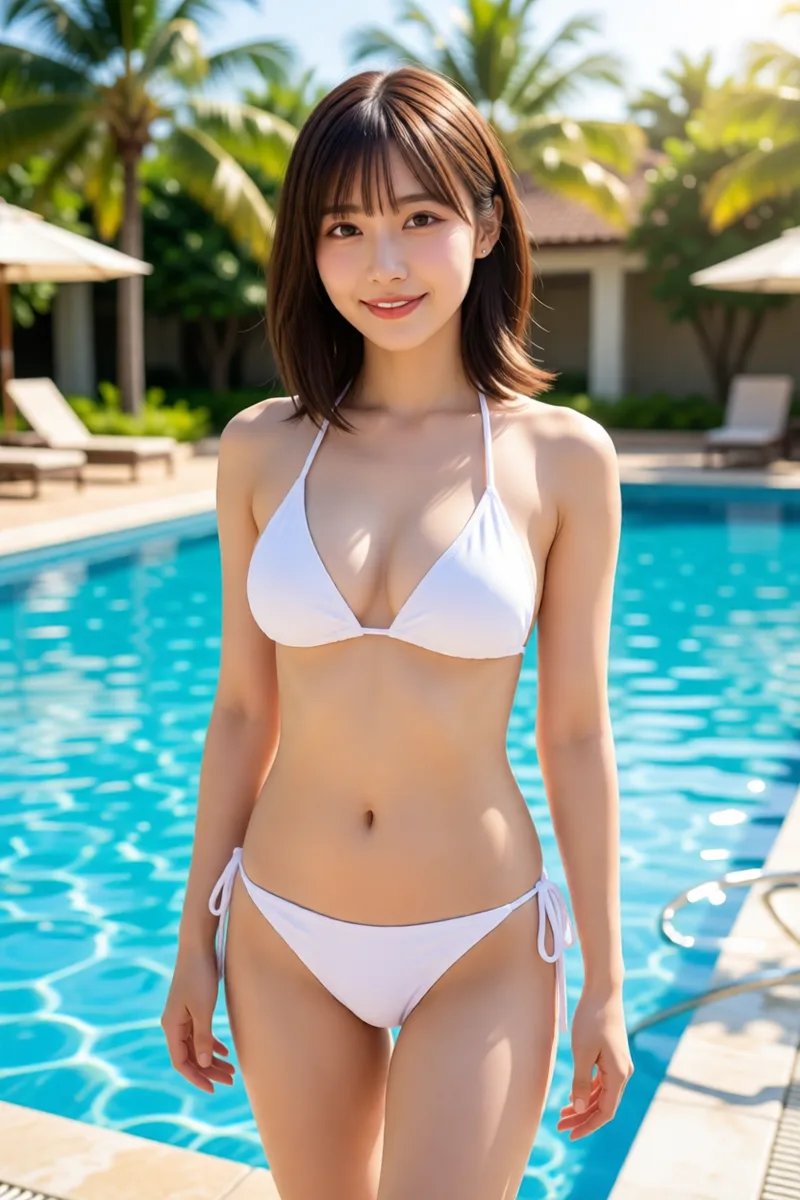
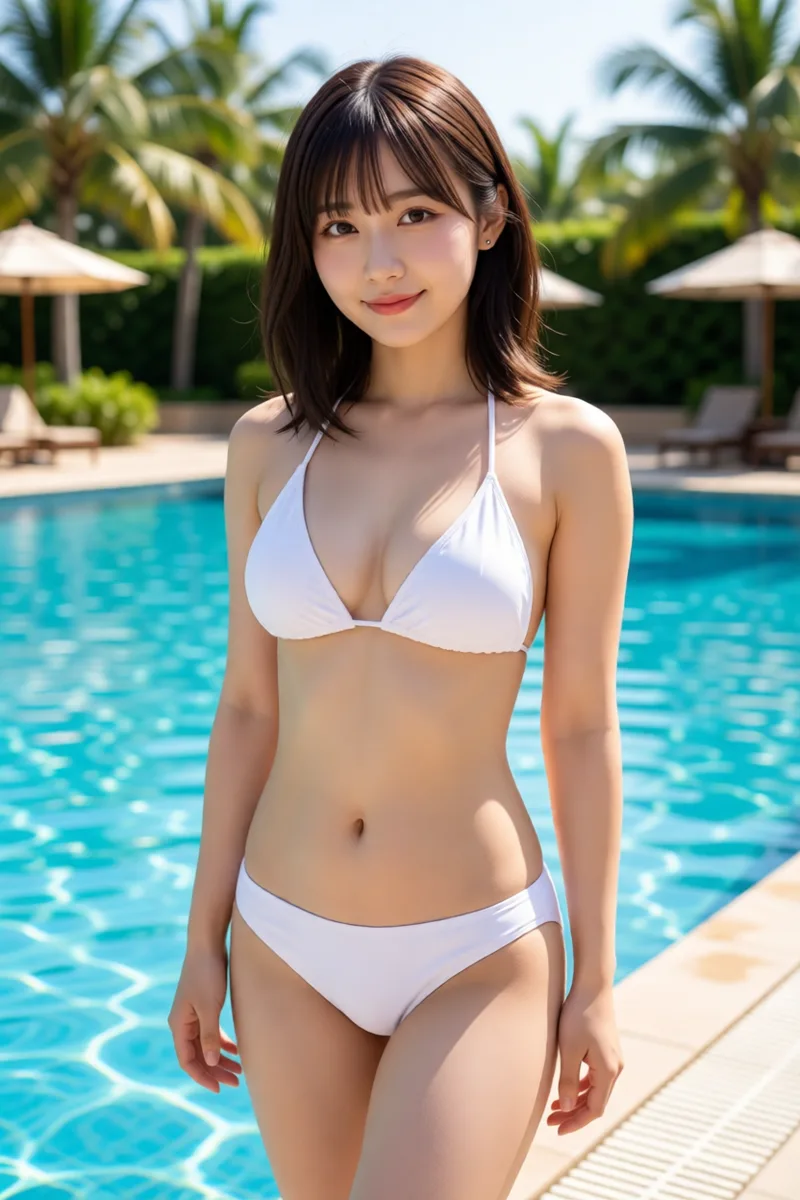
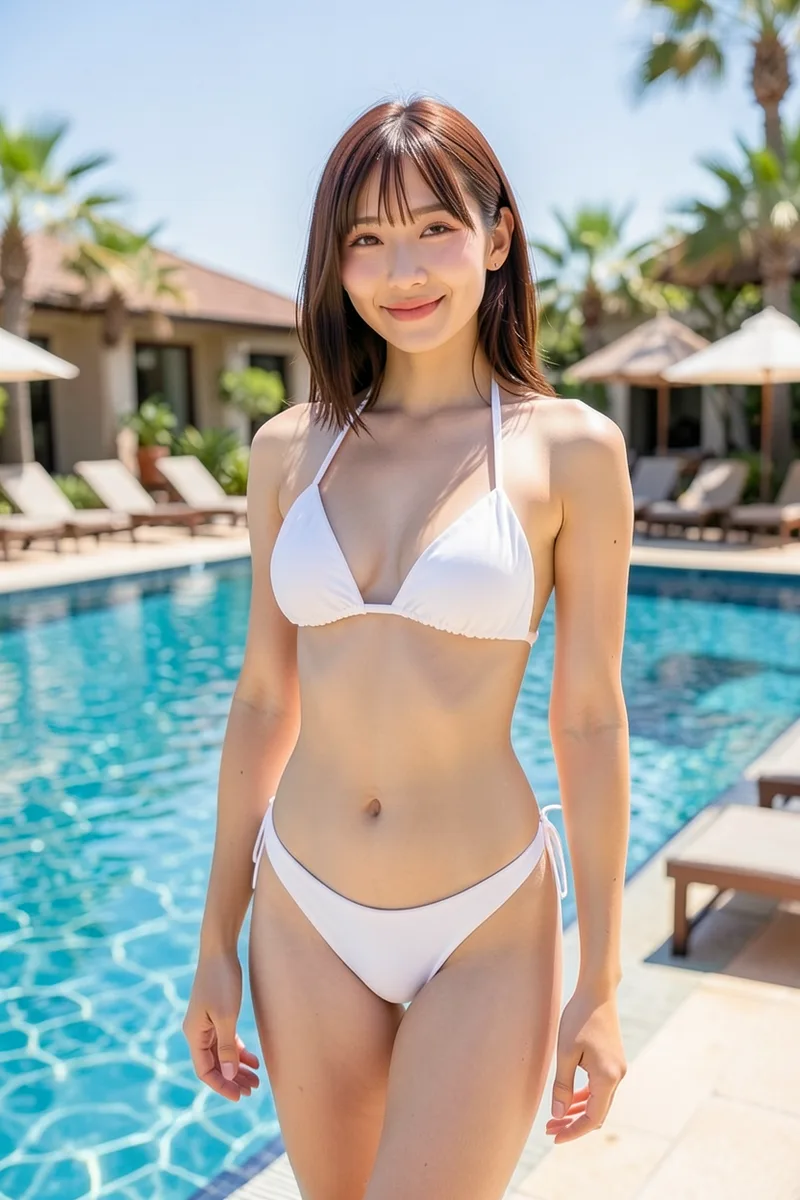
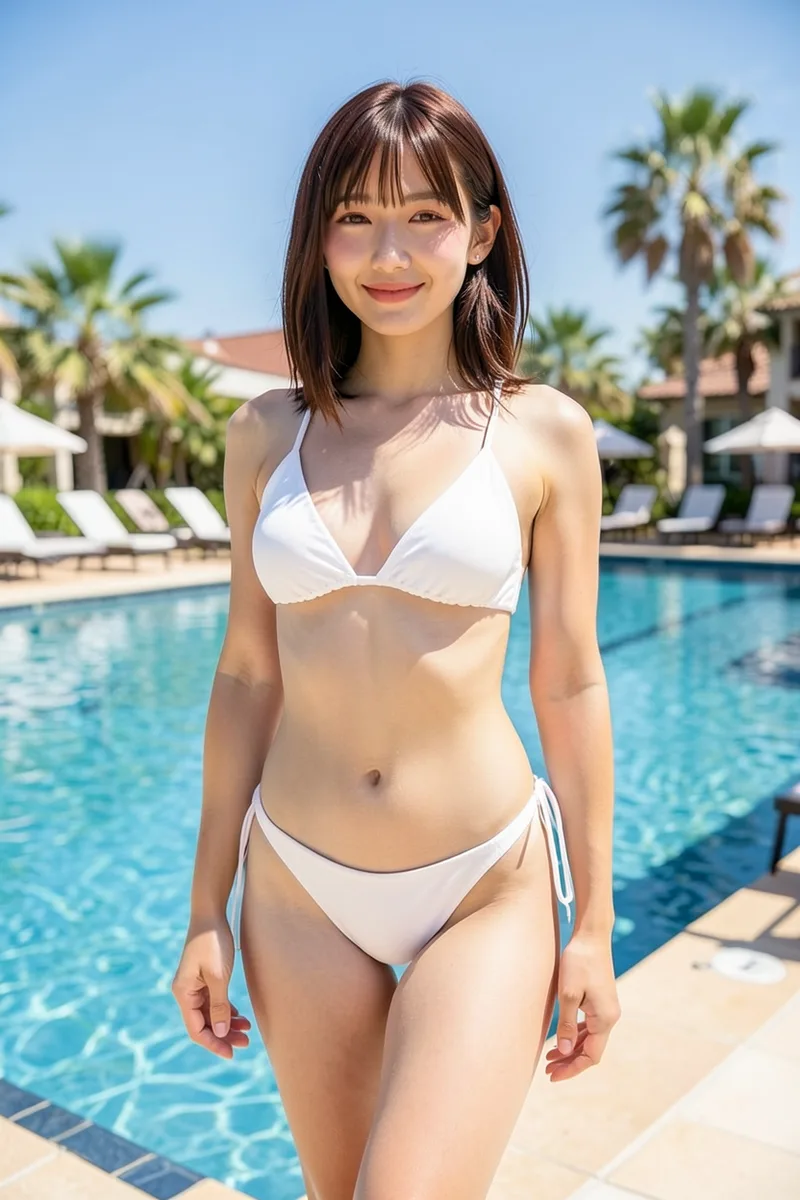
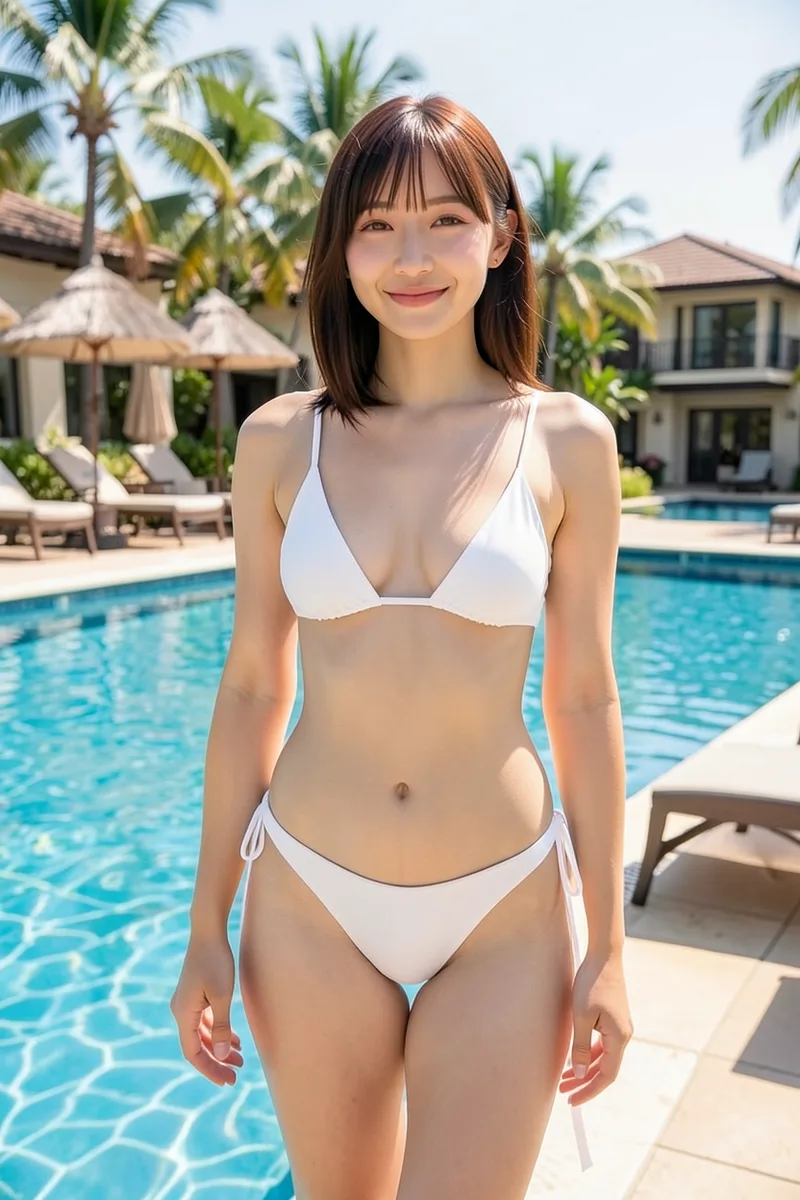
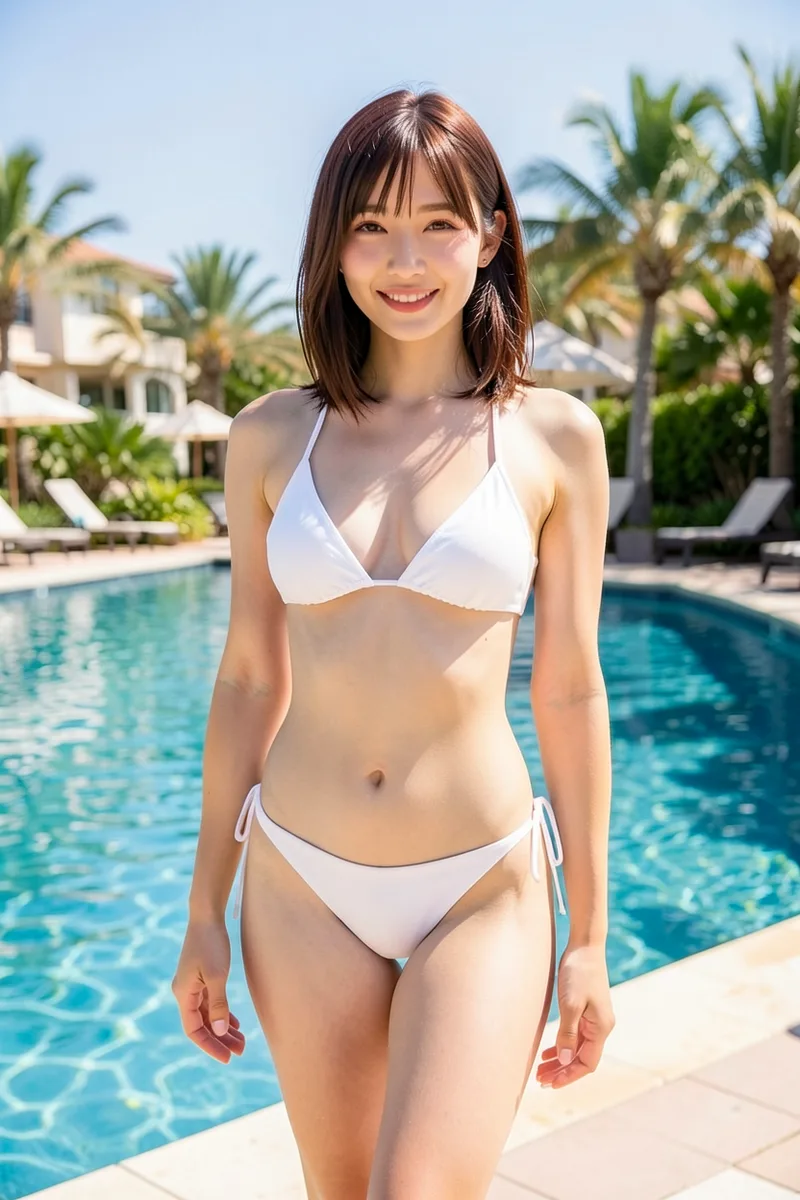
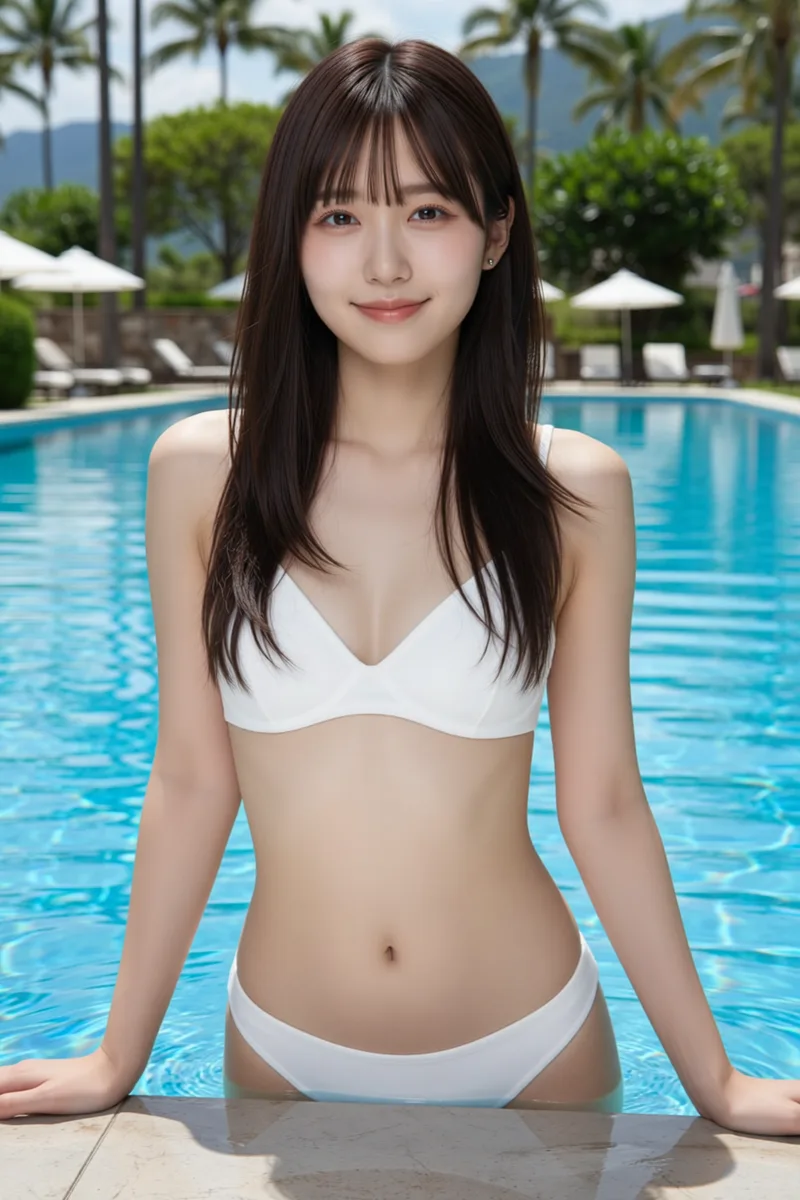
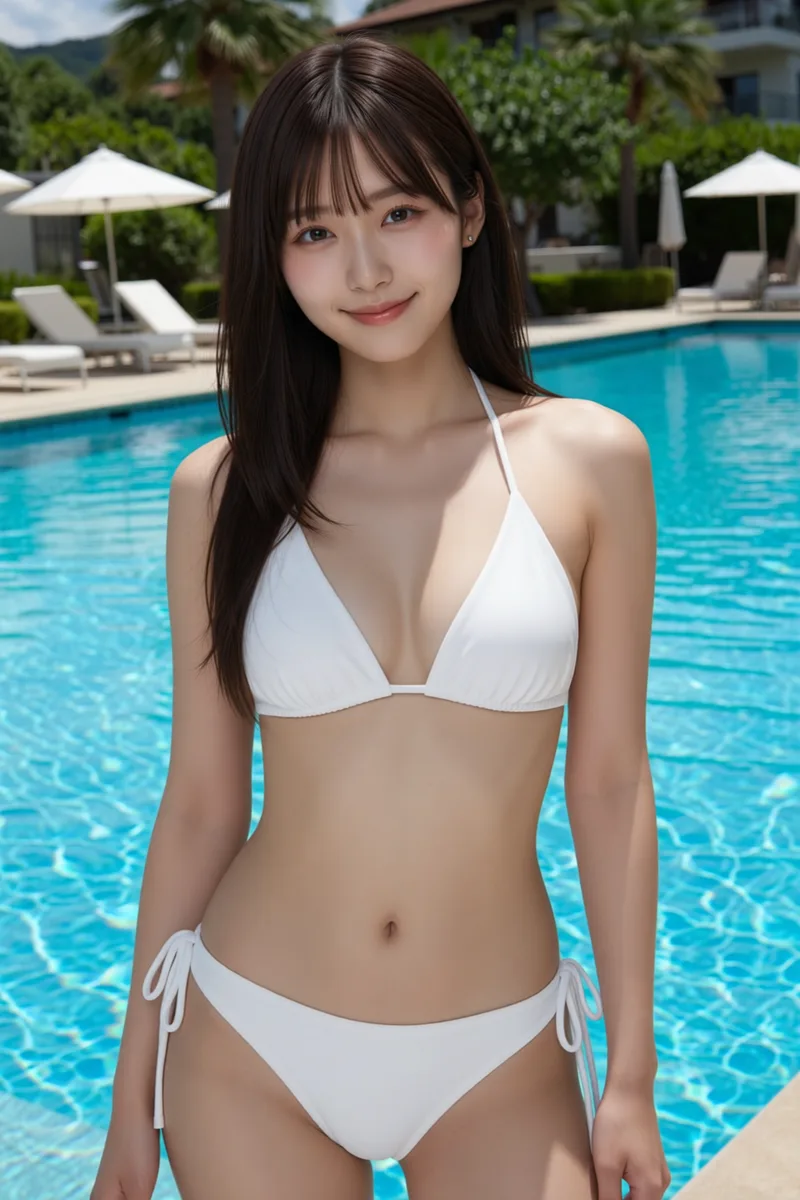
プールの水着wearing a white bikini, thigh-up, standing at the edge of a resort pool on a sunny day, soft smile, bright sunlight

作ったのは、試しに回した分も入れて画像が130枚あまり、動画が7本。そろったかどうかは、元の1枚と顔を並べて、目の形・まぶた・鼻・輪郭・メイクを見比べて、「同じ人と言われて疑わないか」で決めました。髪型と前髪が同じでも、顔が別人なら数えていません。

ChatGPT:元の1枚を渡すだけで、8枚とも本人だった

ChatGPT(Images 2.5)には、元の1枚を添付して「この人のまま、服と場所だけ変えて」と頼み、Codex の画像生成で同じ英文を4回ずつ使いました。

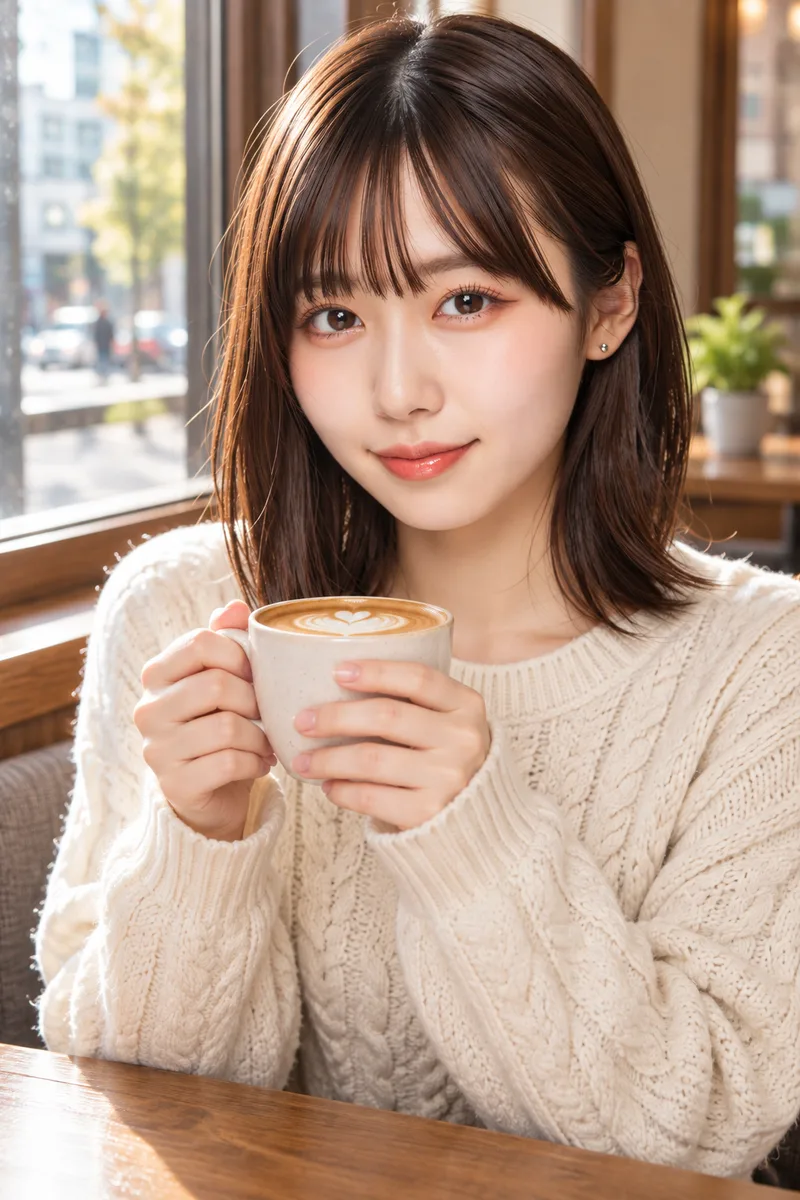
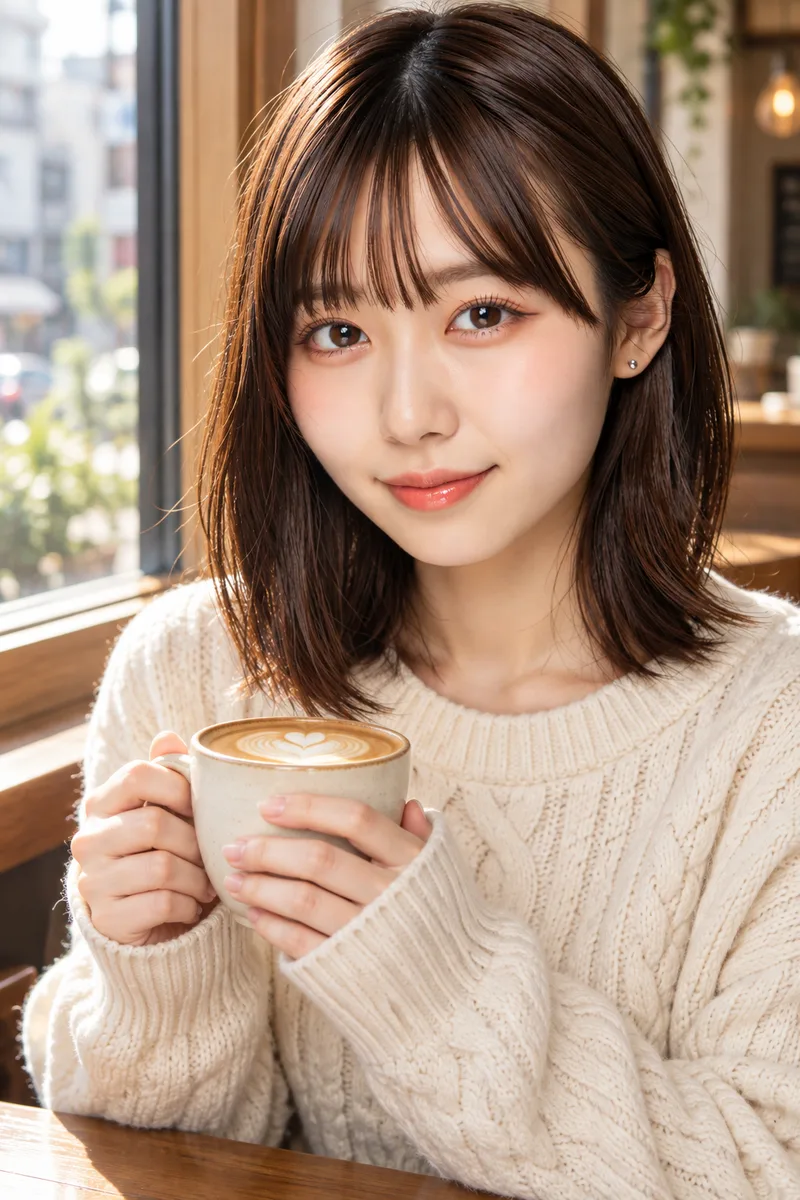
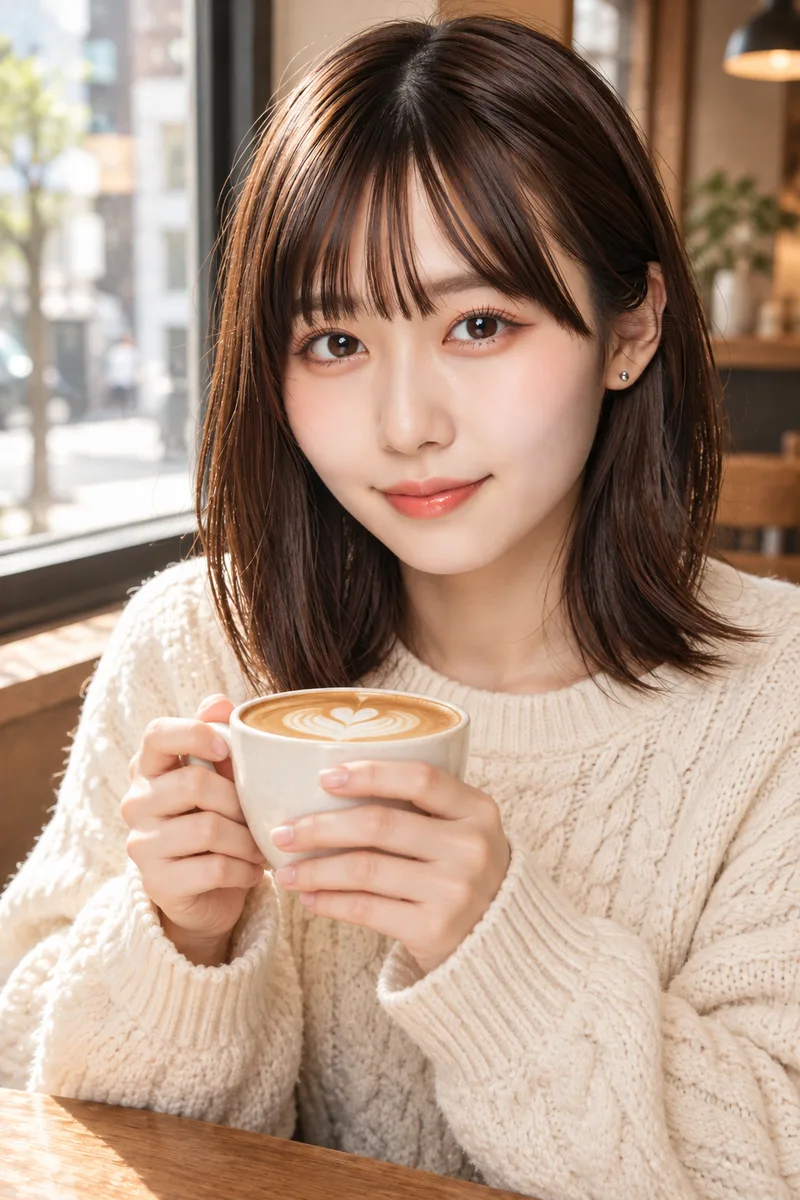
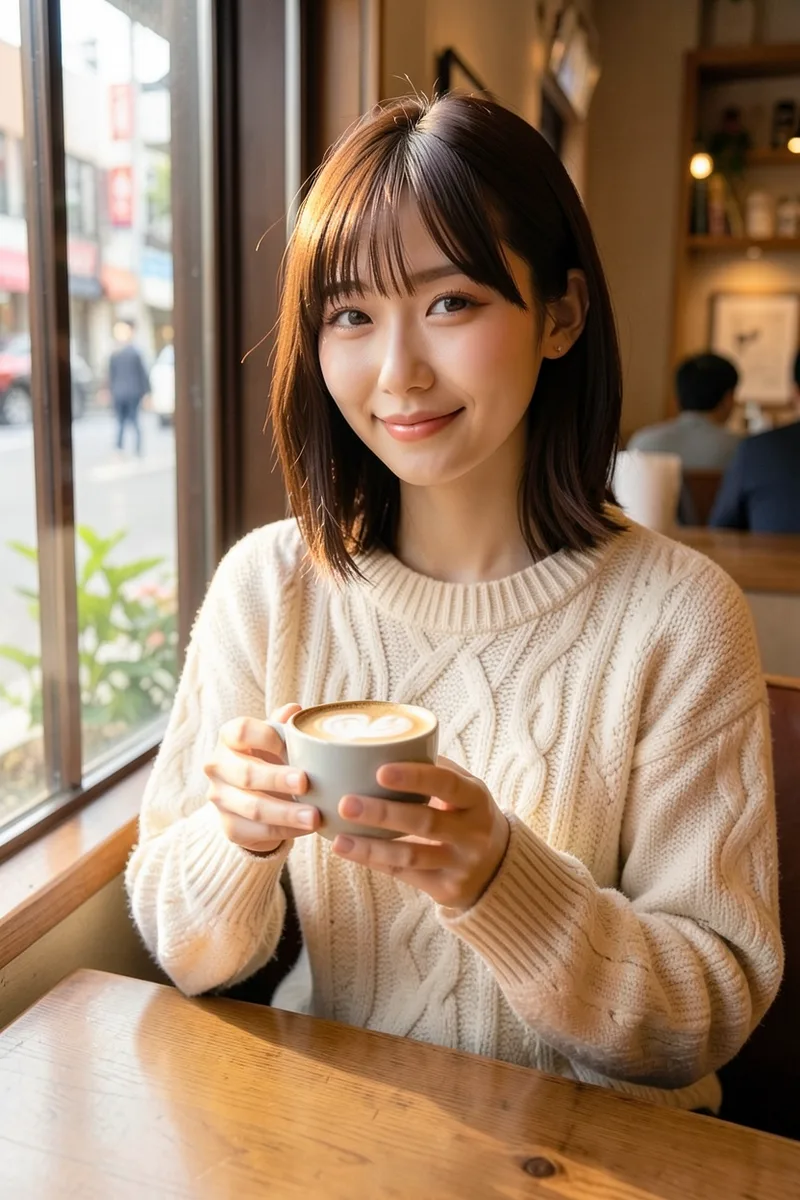
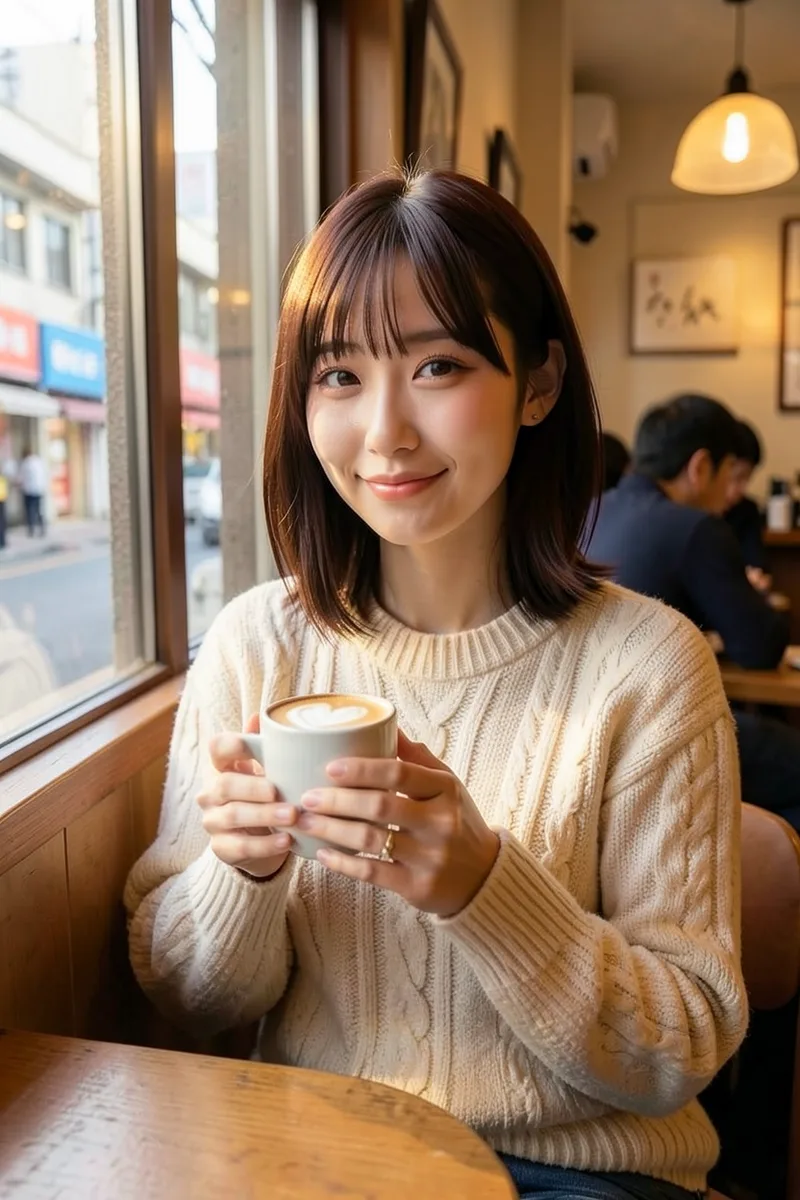
そろったChatGPT:カフェ(4枚中4枚)
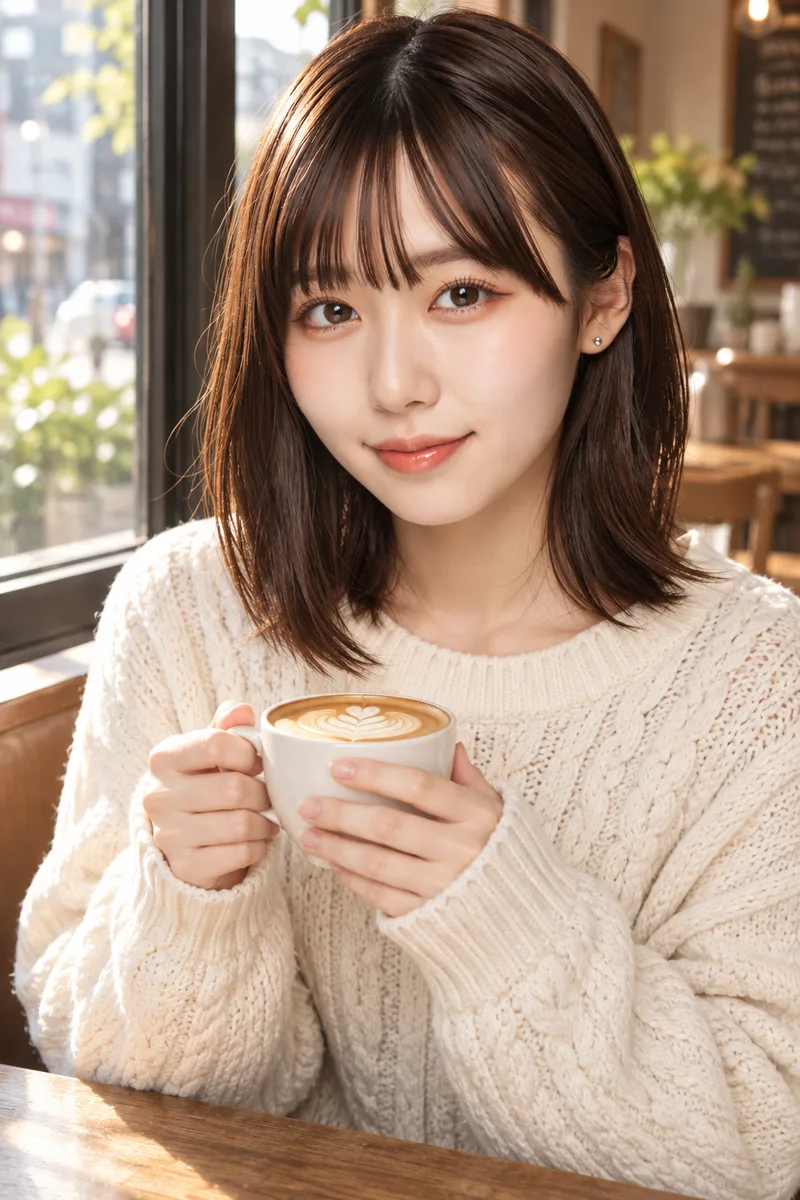
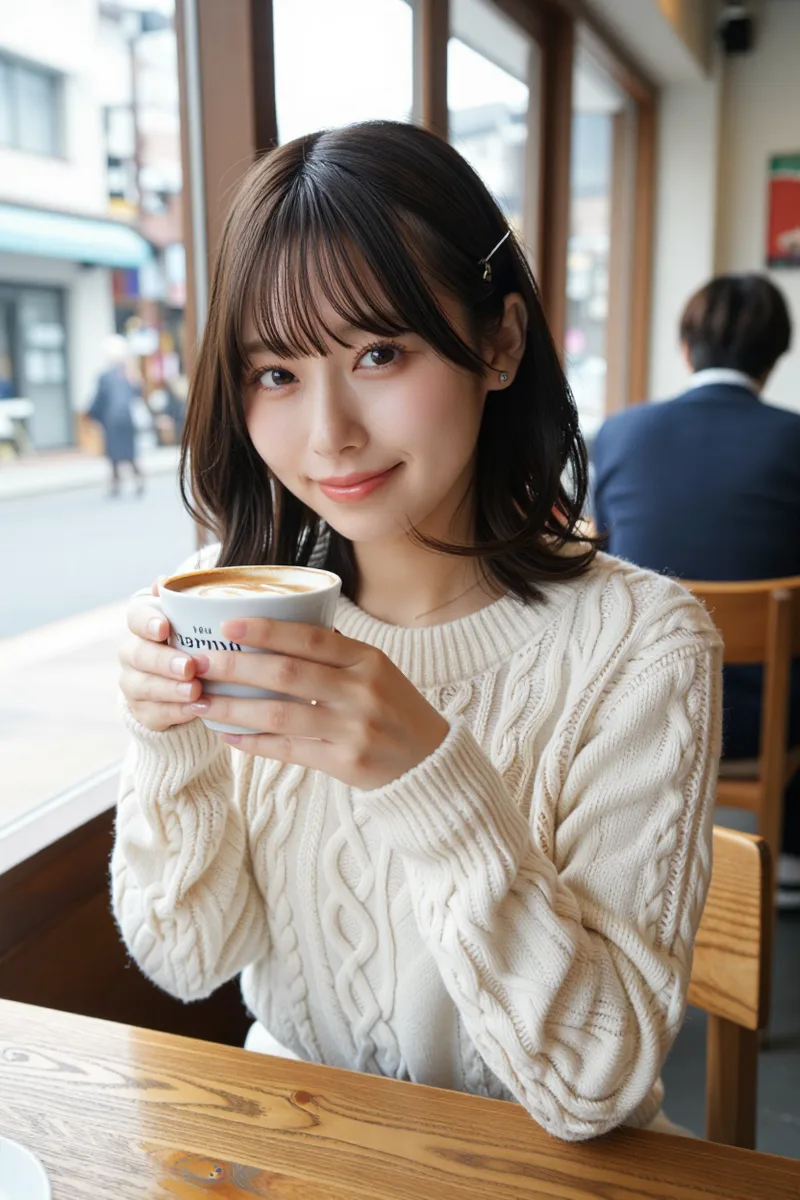
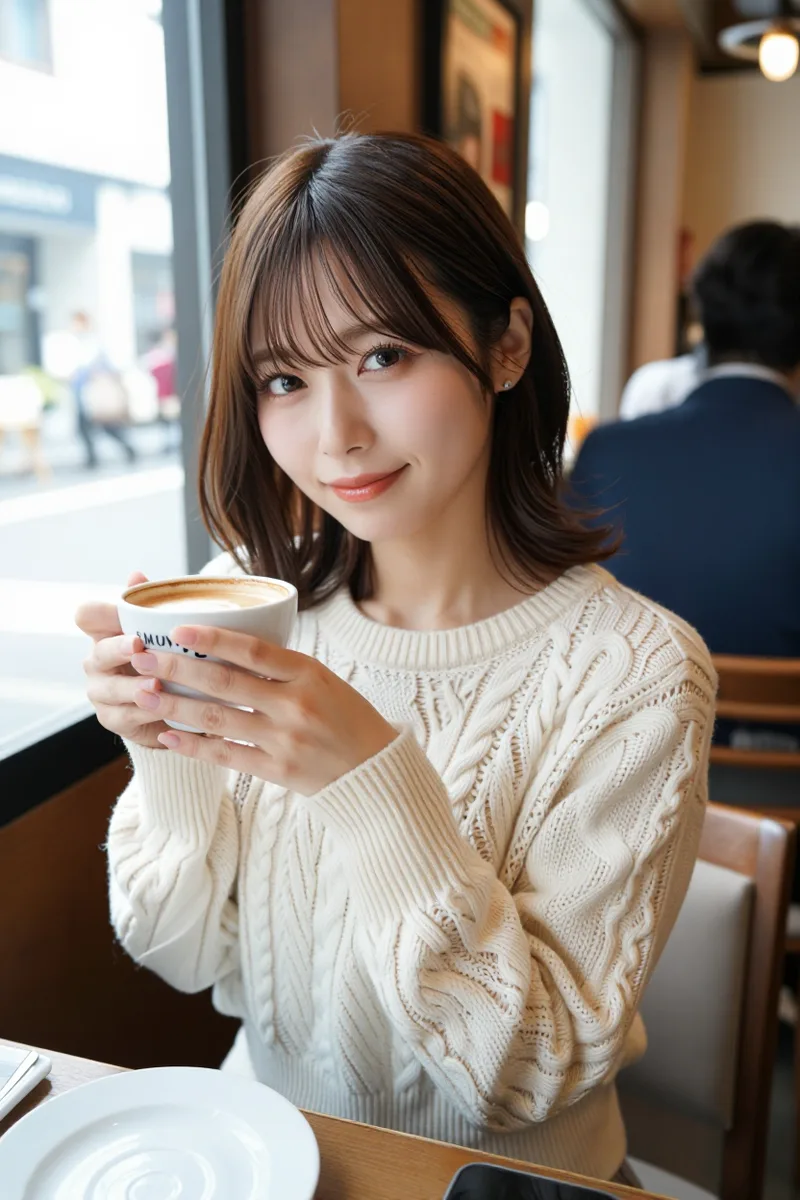
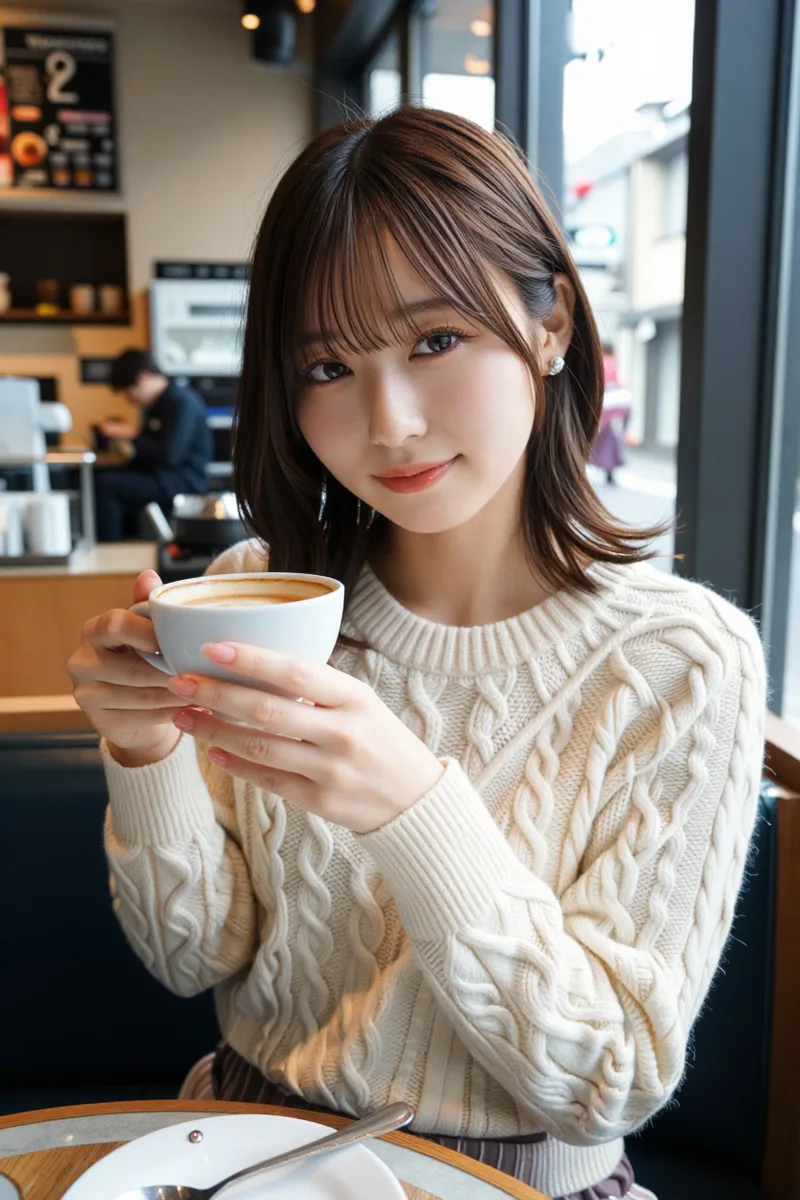
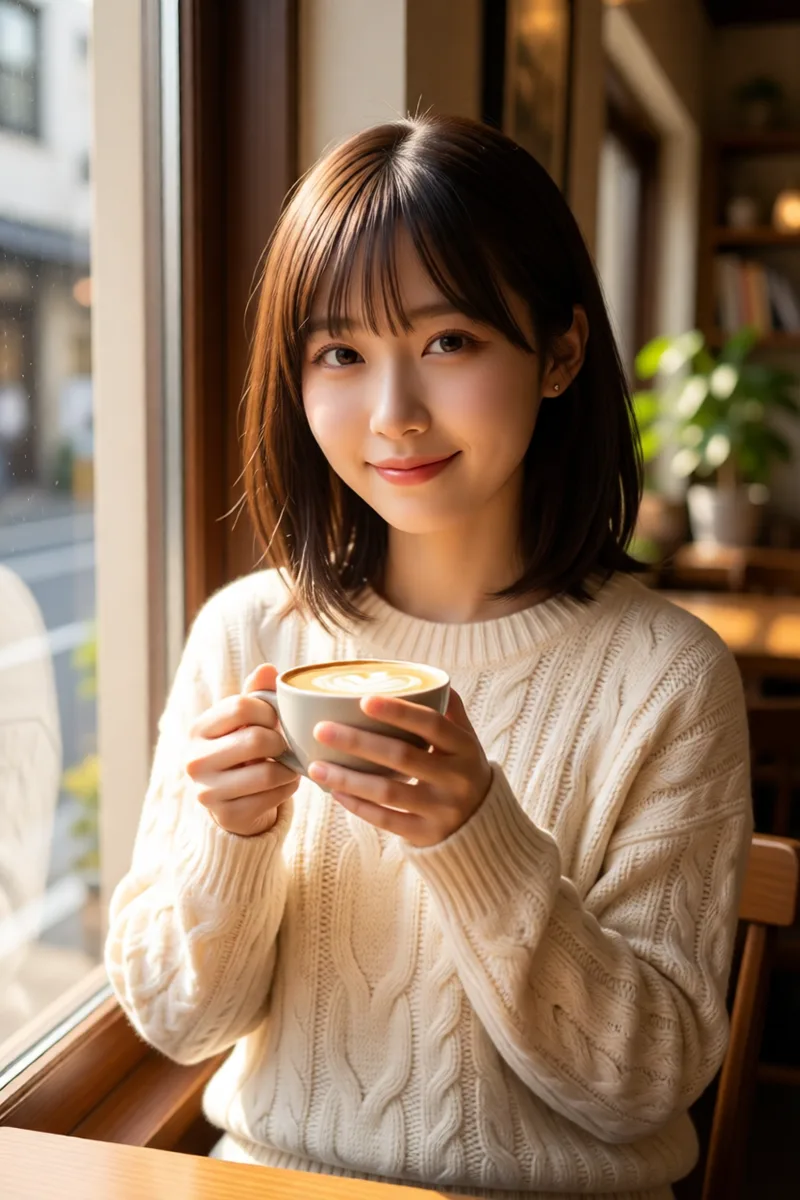
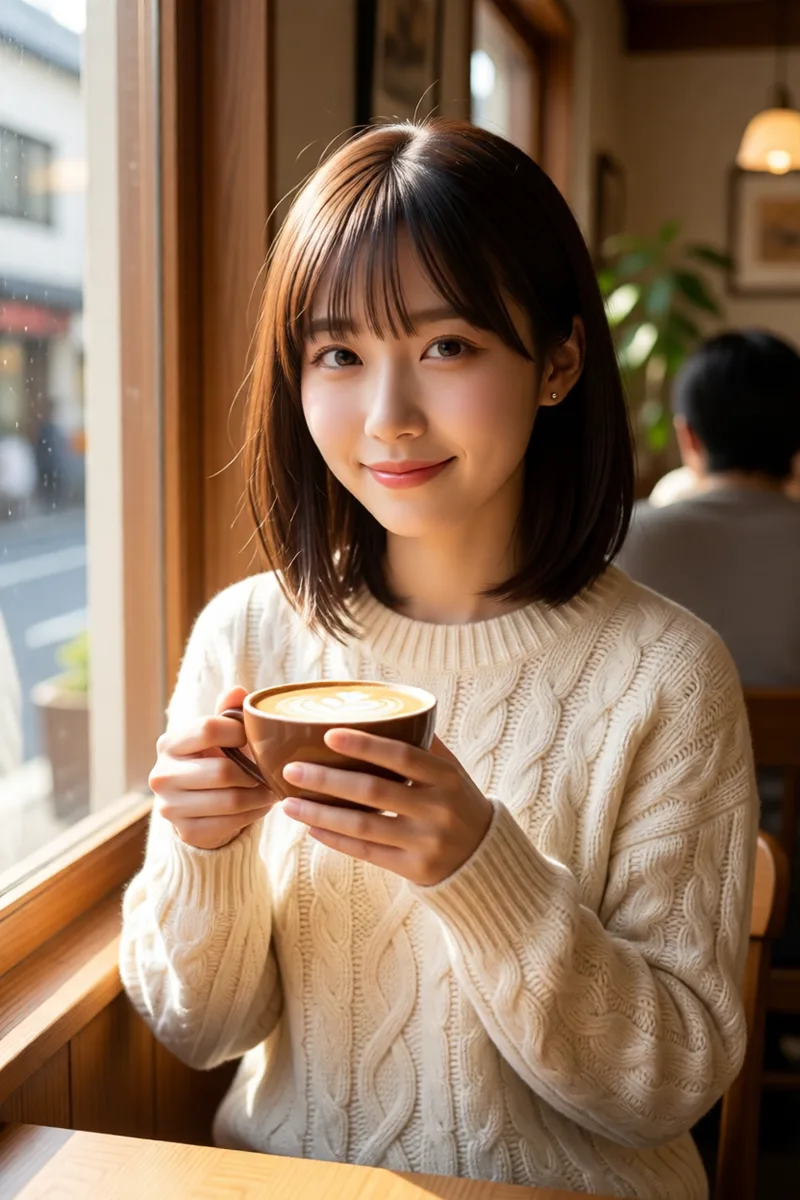
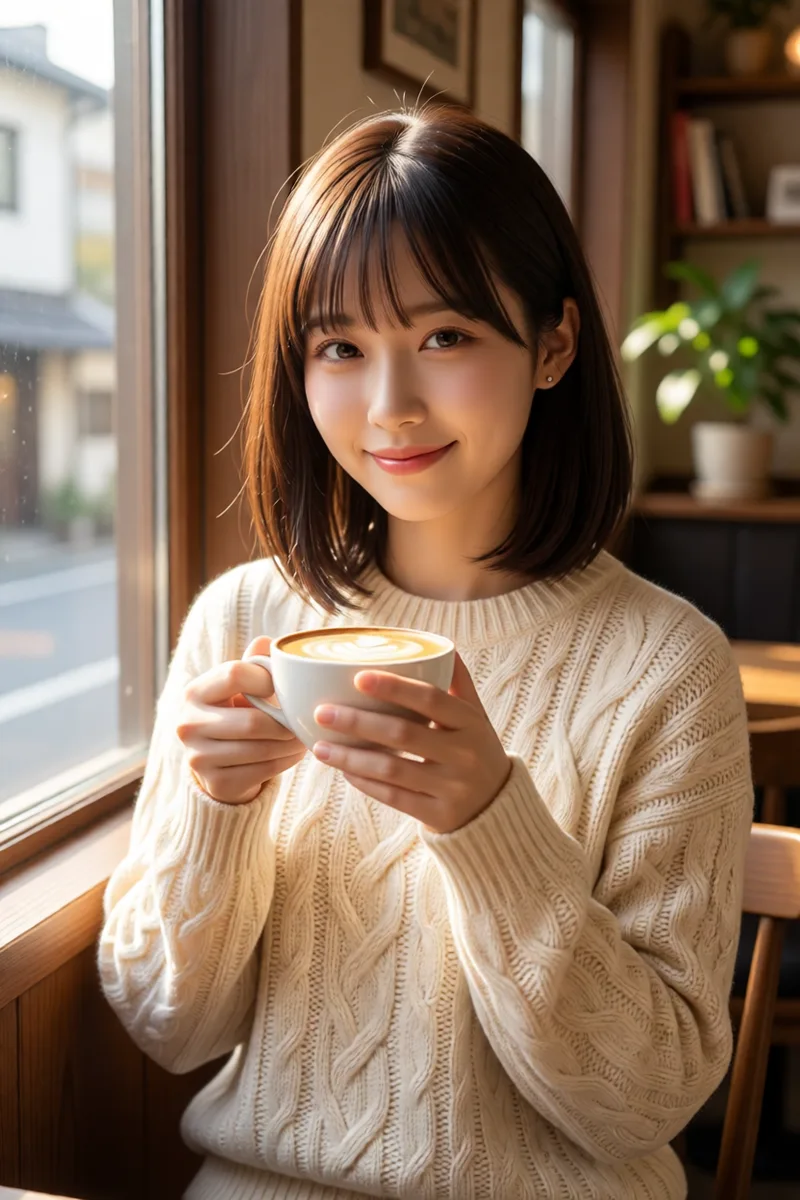
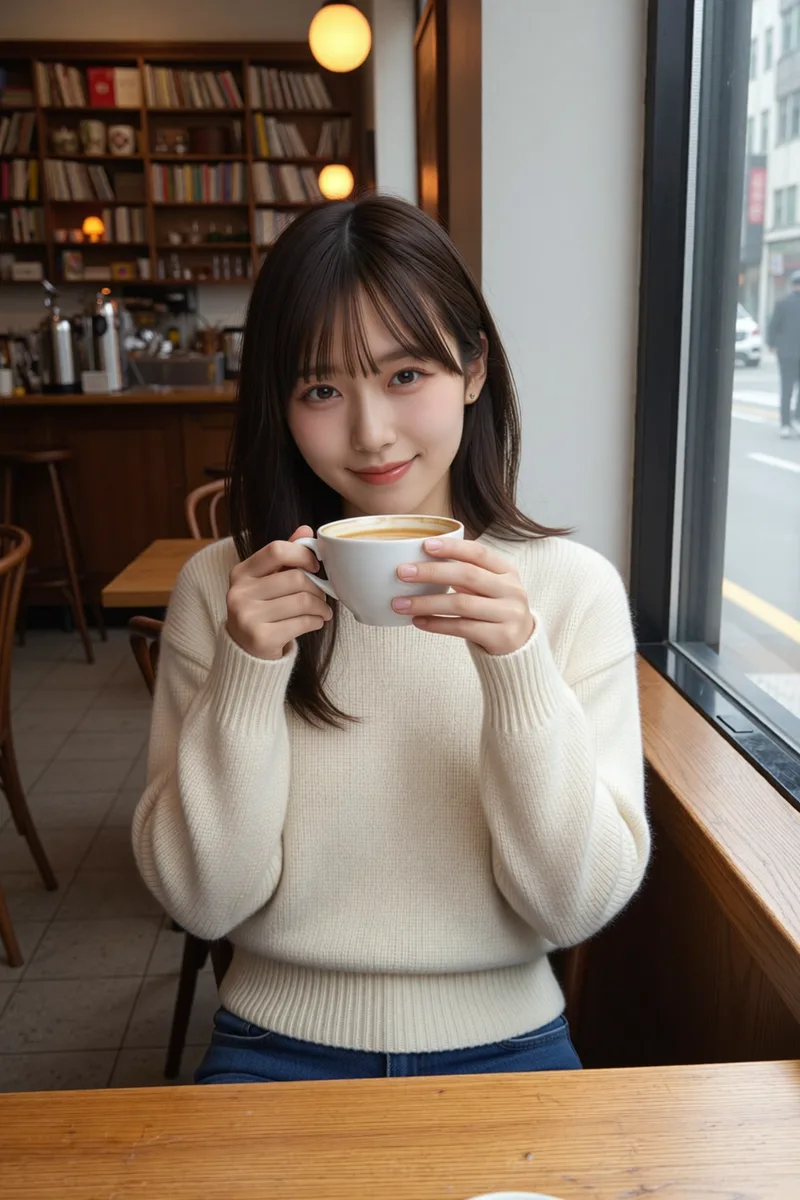
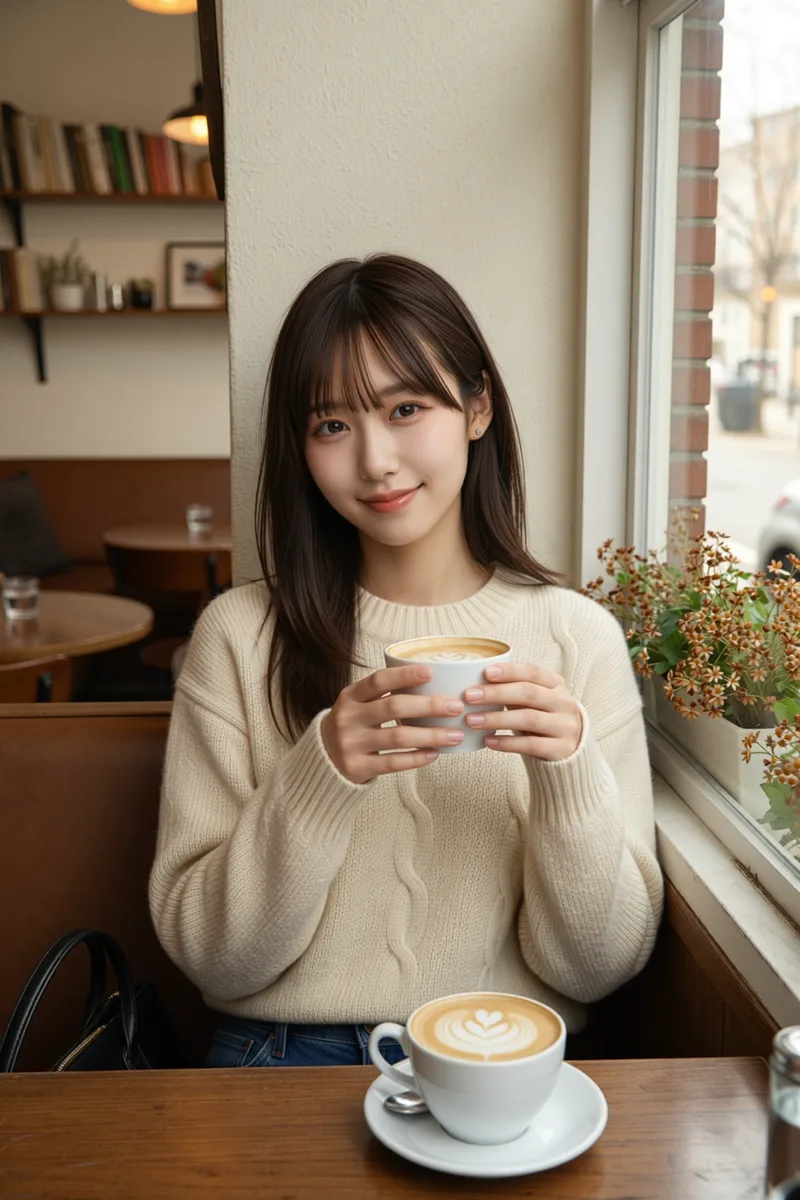
ChatGPTに元の1枚を渡してカフェで作った例(1枚目)ChatGPTに元の1枚を渡してカフェで作った例(2枚目)ChatGPTに元の1枚を渡してカフェで作った例(3枚目)ChatGPTに元の1枚を渡してカフェで作った例(4枚目)
この4枚のプロンプト(元の1枚を添付)
Keep the exact same woman from the attached reference photo: same face, same eyes, same makeup, the same glossy dark brown bob with see-through bangs and the same small silver stud earrings. Change only her outfit and the place: she is now wearing a cream cable-knit sweater, waist-up, sitting at a window seat in a cozy Tokyo cafe holding a latte with both hands, soft smile, warm daylight from the window. Photorealistic photo, vertical 2:3 portrait format

うん、本人。ピンクの目元のメイクも、前髪の流れ方も、口角の上げ方もそのままです。4枚並べても、同じ日に同じカフェで撮った写真にしか見えません。

全身で顔が小さくなる夜の渋谷は、崩れるならここだろうと思っていました。

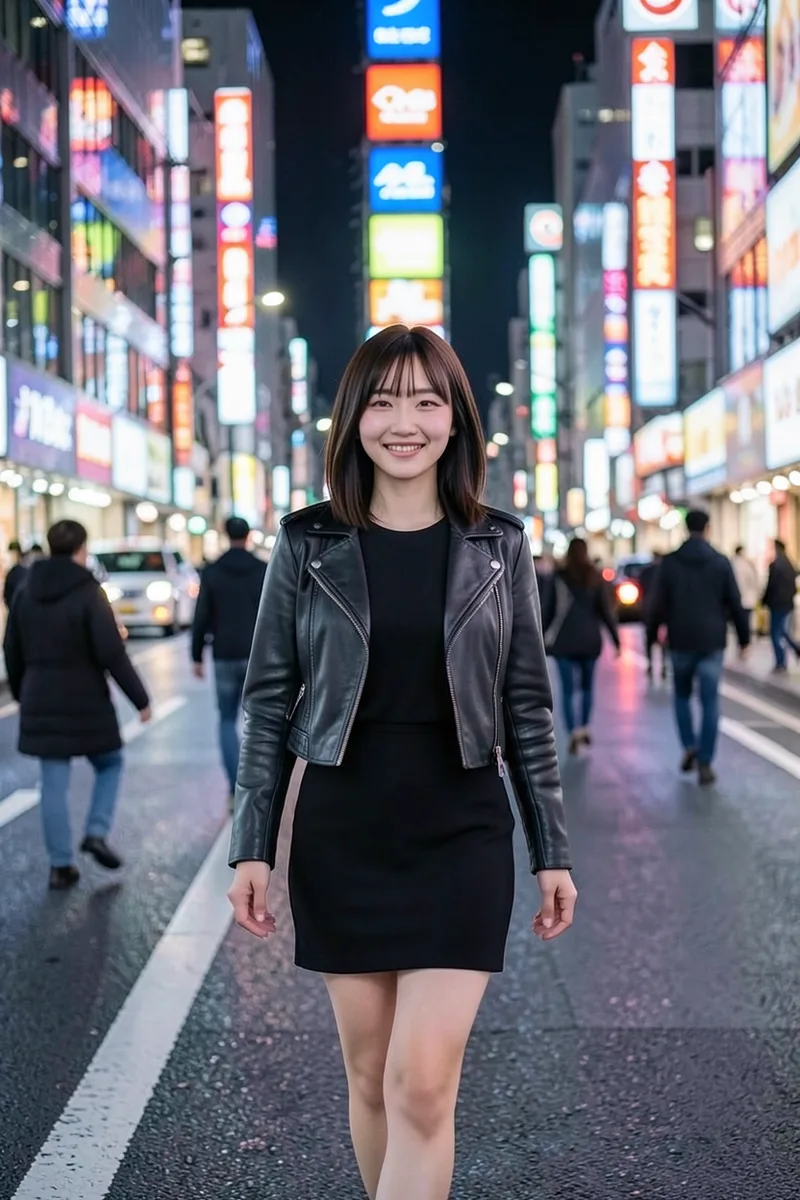
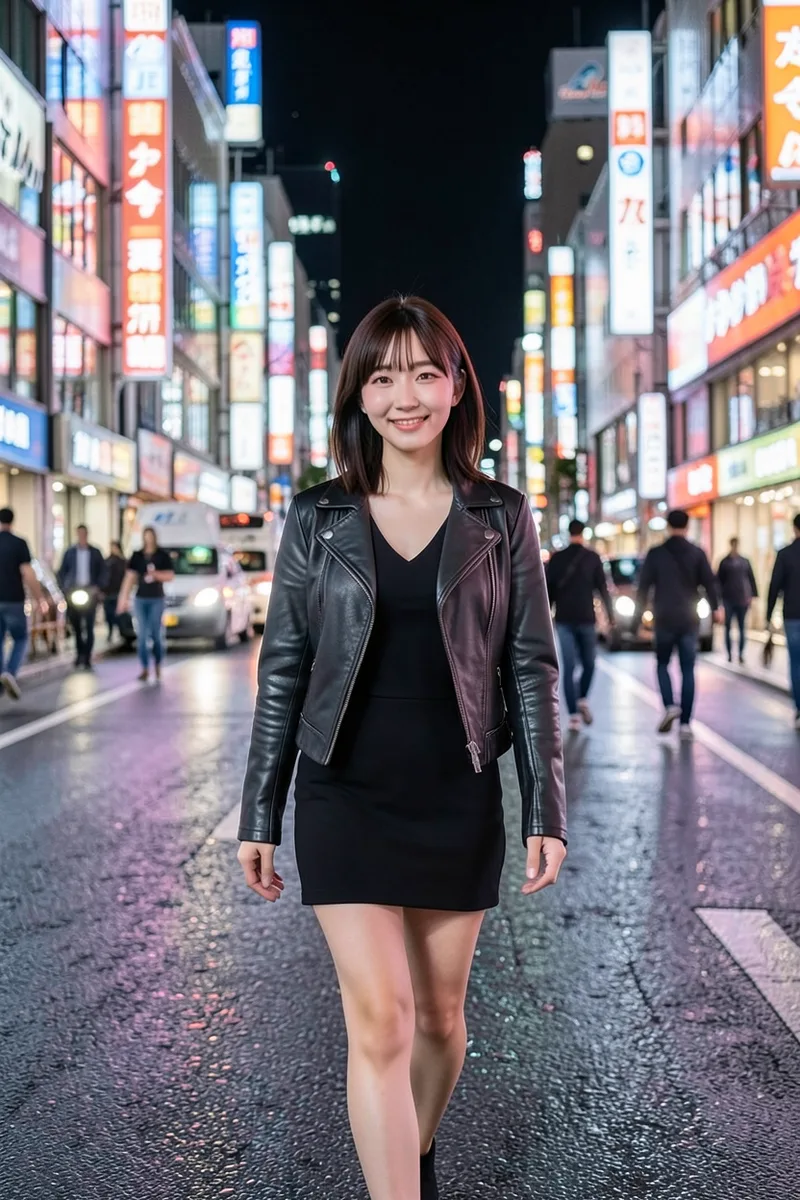
そろったChatGPT:夜の渋谷・全身(4枚中4枚)
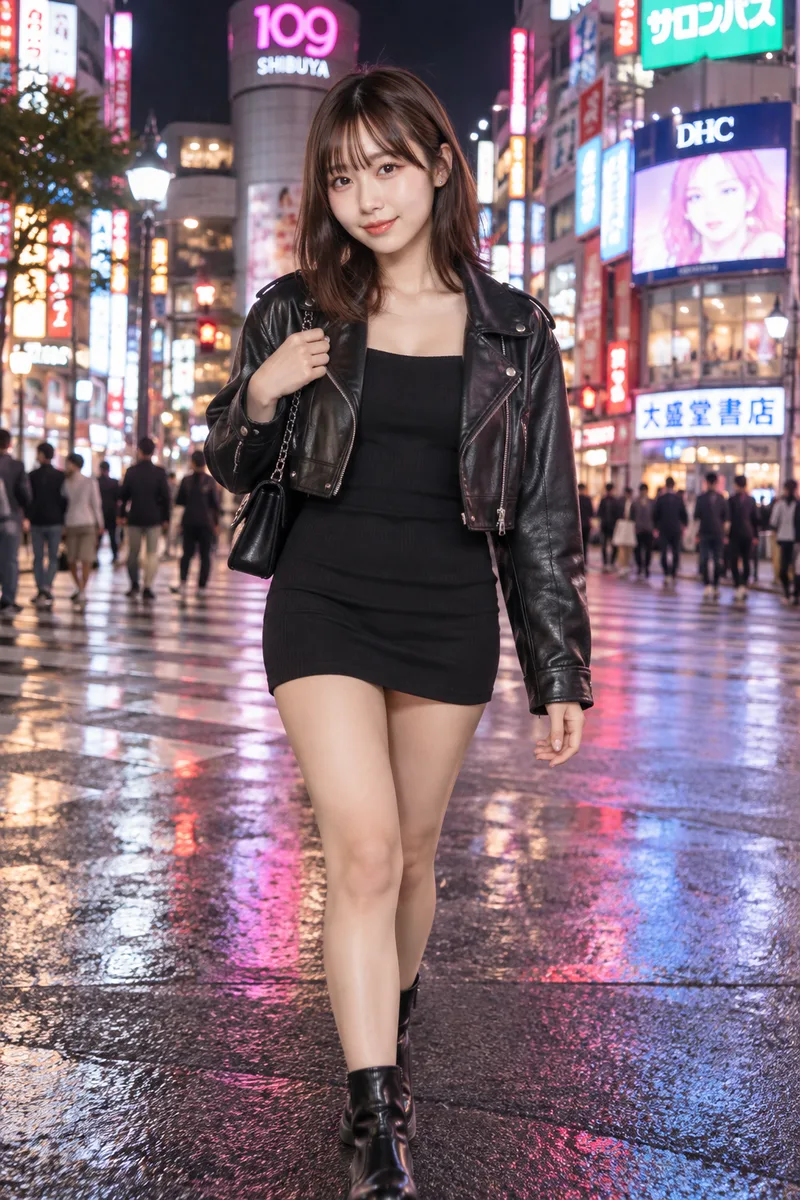
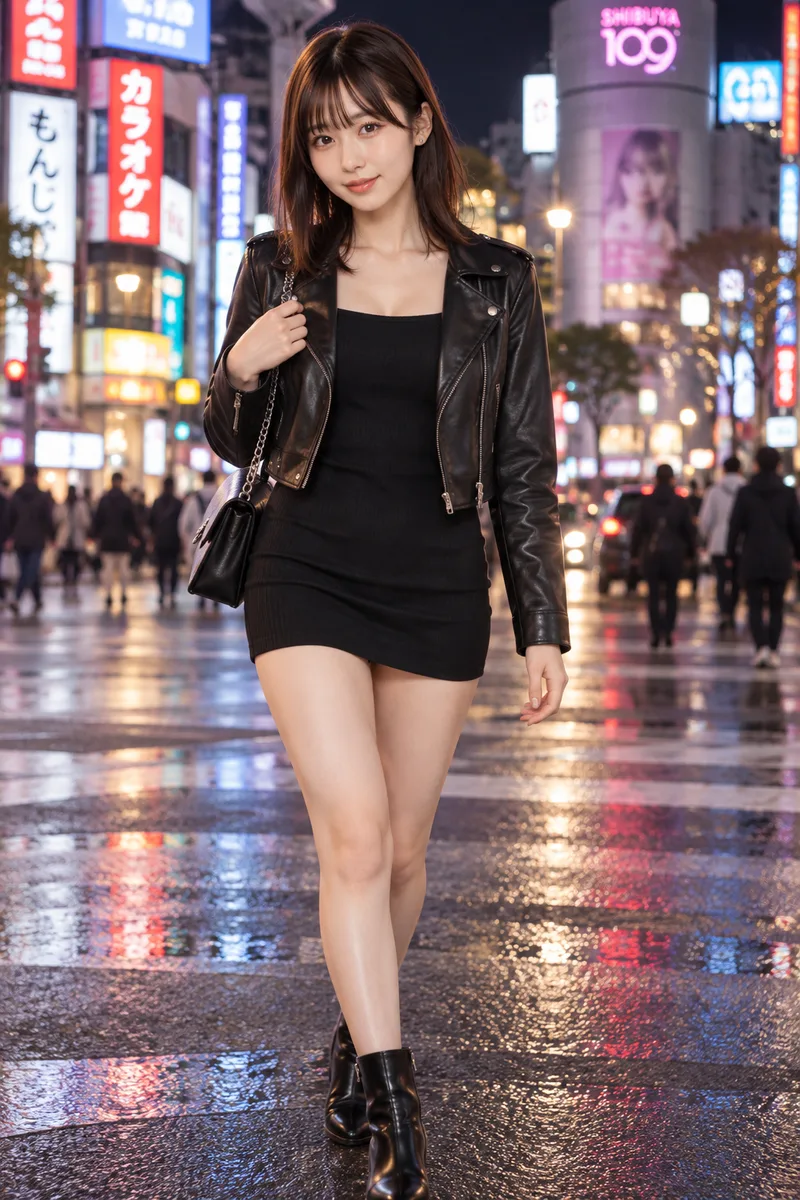
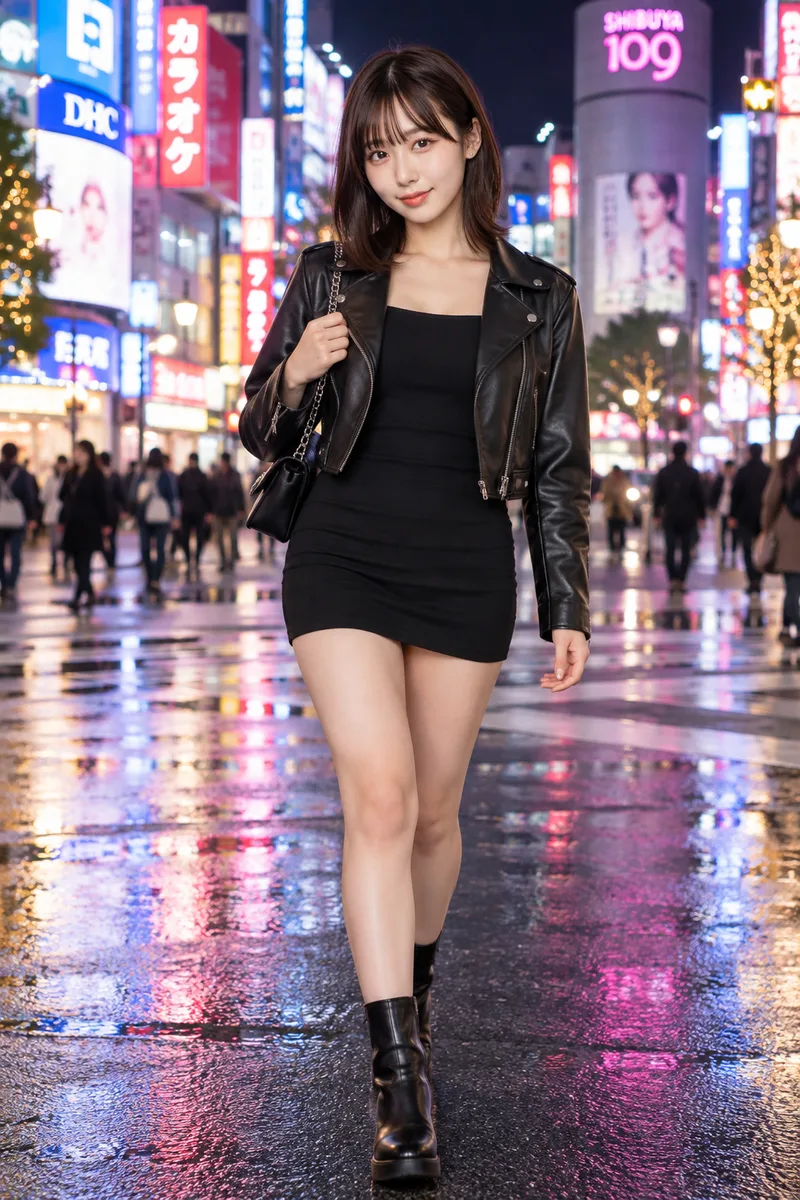
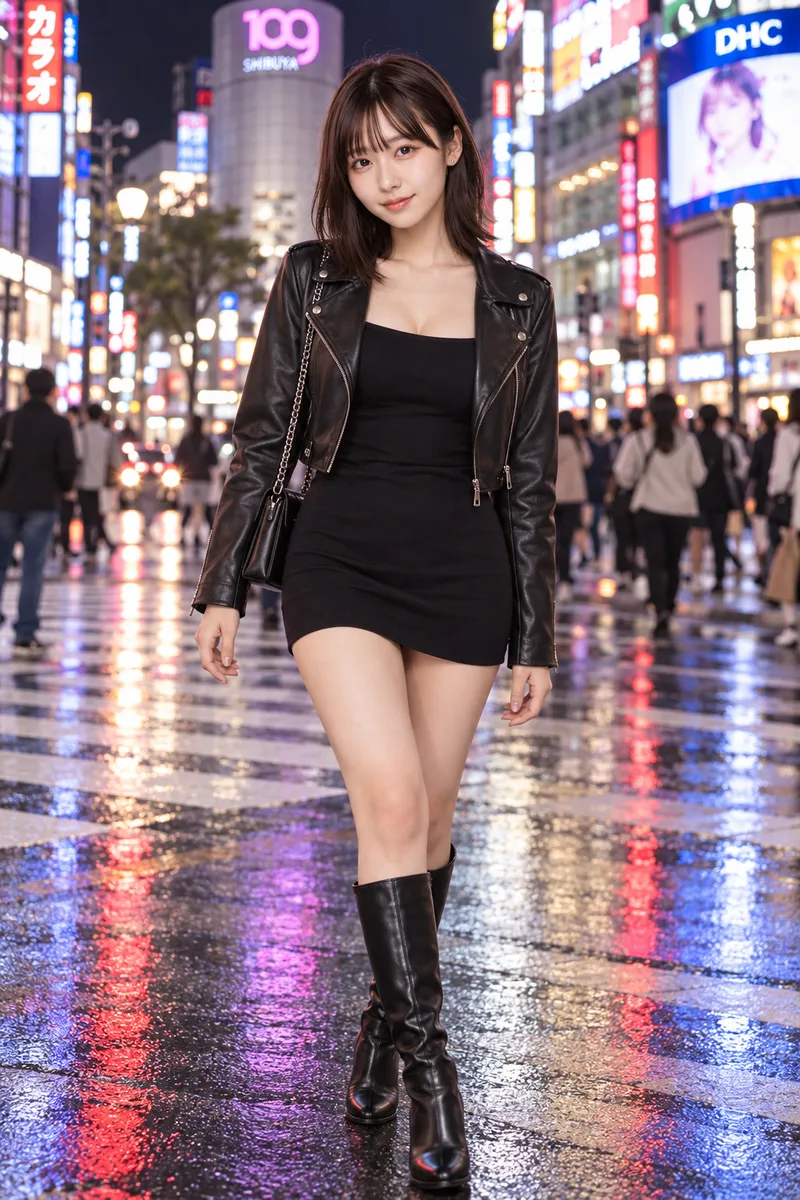
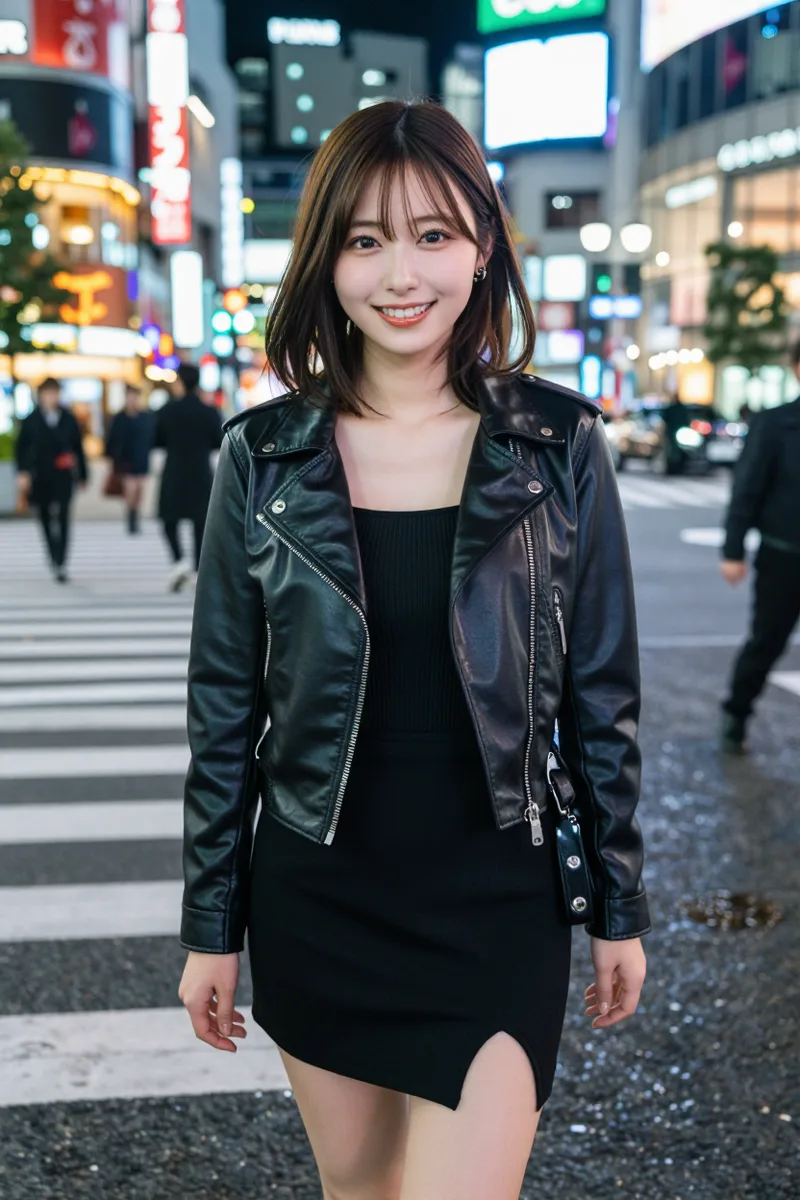
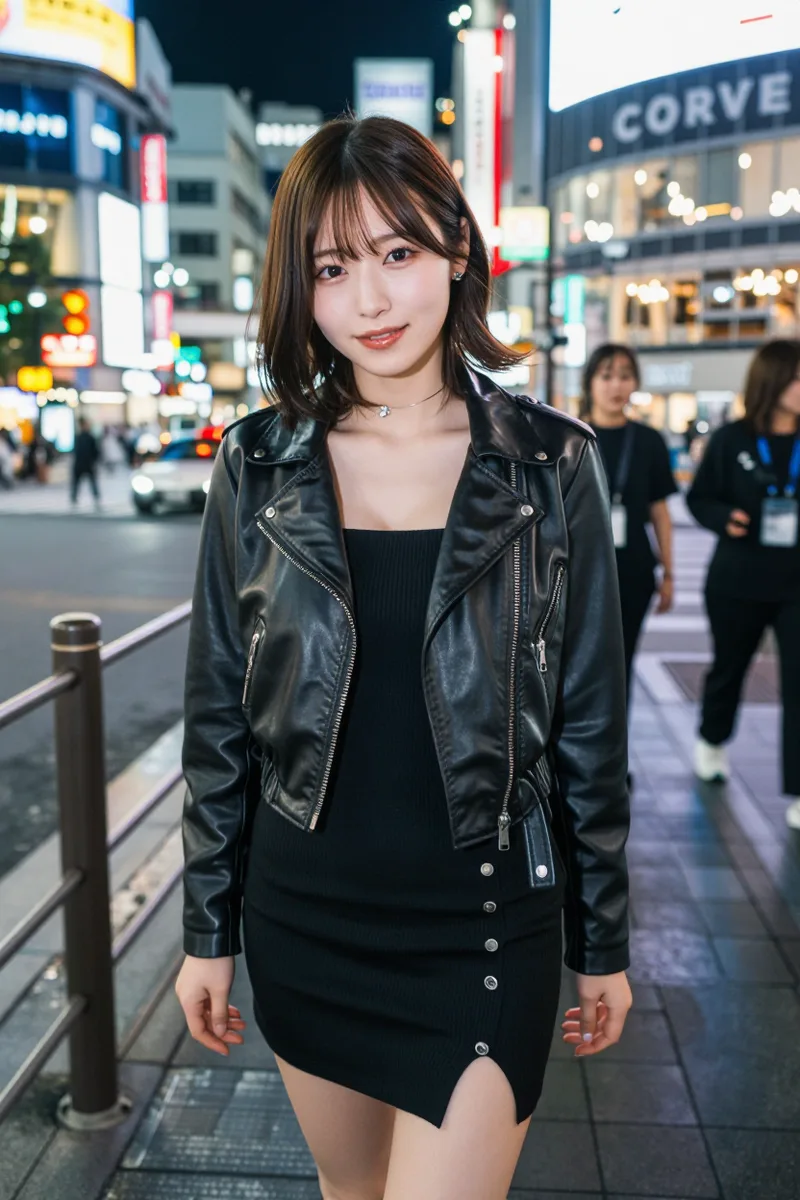
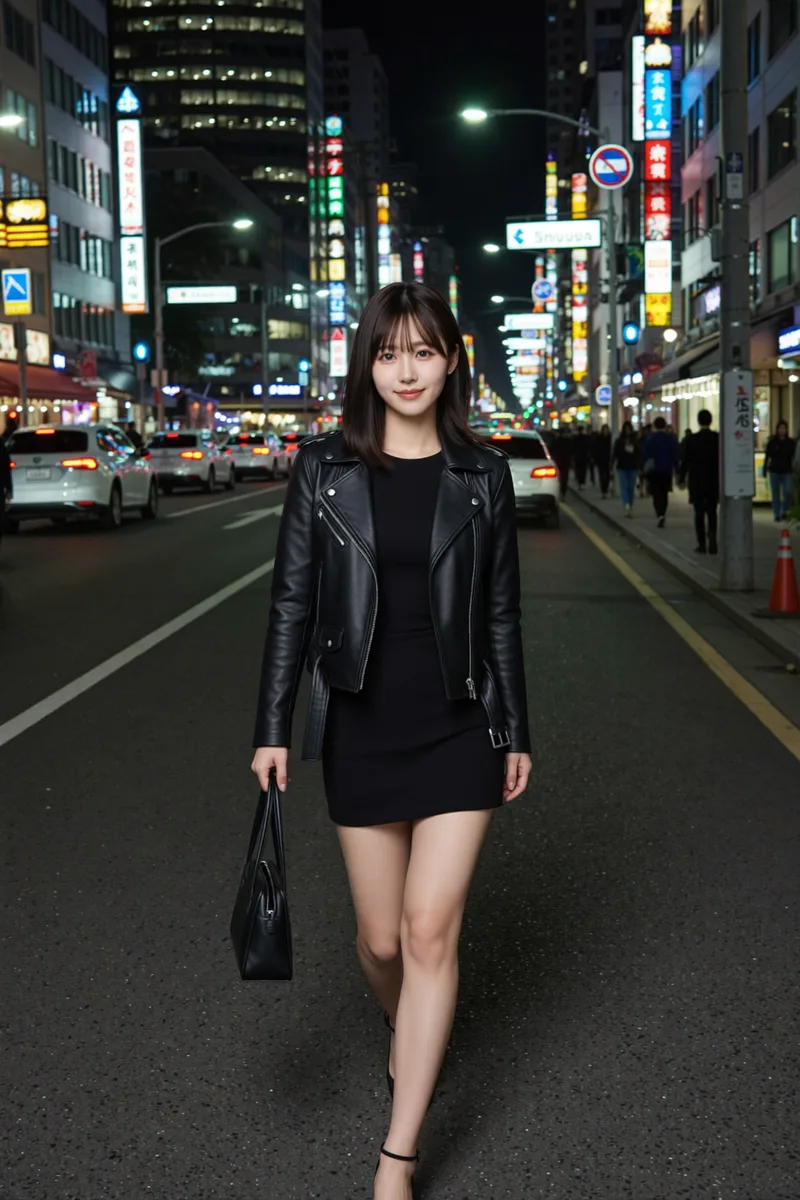
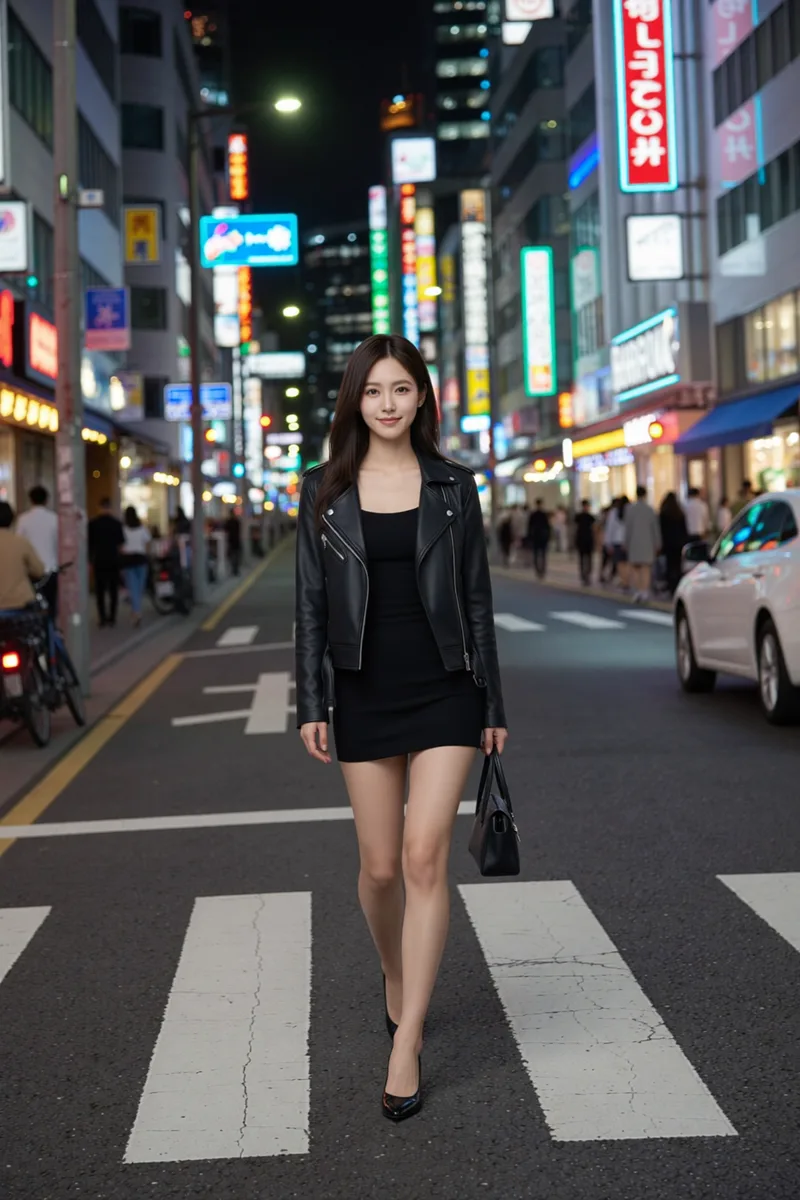
ChatGPTに元の1枚を渡して夜の渋谷で作った例(1枚目)ChatGPTに元の1枚を渡して夜の渋谷で作った例(2枚目)ChatGPTに元の1枚を渡して夜の渋谷で作った例(3枚目)ChatGPTに元の1枚を渡して夜の渋谷で作った例(4枚目)
この4枚のプロンプト(元の1枚を添付)
Keep the exact same woman from the attached reference photo: same face, same eyes, same makeup, the same glossy dark brown bob with see-through bangs and the same small silver stud earrings. Change only her outfit and the place: she is now wearing a black mini dress and a short black leather jacket, full-body shot walking on a neon-lit Shibuya street at night, soft smile, glowing city lights. Photorealistic photo, vertical 2:3 portrait format

これもそろいました。顔が小さいぶん細かいところは見えにくいものの、顔を拡大すると目の形も口元も元の1枚のまま。渋谷109まで入れてくれるサービス精神です。

ただ、プールの白いビキニは、4回頼んだどれも2回ずつ安全審査で止められ、1枚も作れませんでした。水着の図鑑を作ったときも、ChatGPT は文章だけで頼んだビキニを止めたので、水着は元の写真を渡すかどうかに関係なく ChatGPT では難しい場面です。

ChatGPT に頼れないのは、こういう服のときと、ComfyUI で何百枚も回したいとき、動画にしたいとき。ここから先は、その3つで顔をそろえる方法を試しました。

ComfyUI(説明文とシード値だけ):似ているけど別人

まずは ComfyUI の基準です。元の1枚と同じ人物の説明文を使い、服と場所の部分だけを差し替えました。シード値は、元の1枚と同じ 2510 と、それに続く 2511〜2513 の4つ。1枚目が元と同じシード値です。

別人になった説明文とシード値だけ:カフェ(4枚中1枚)
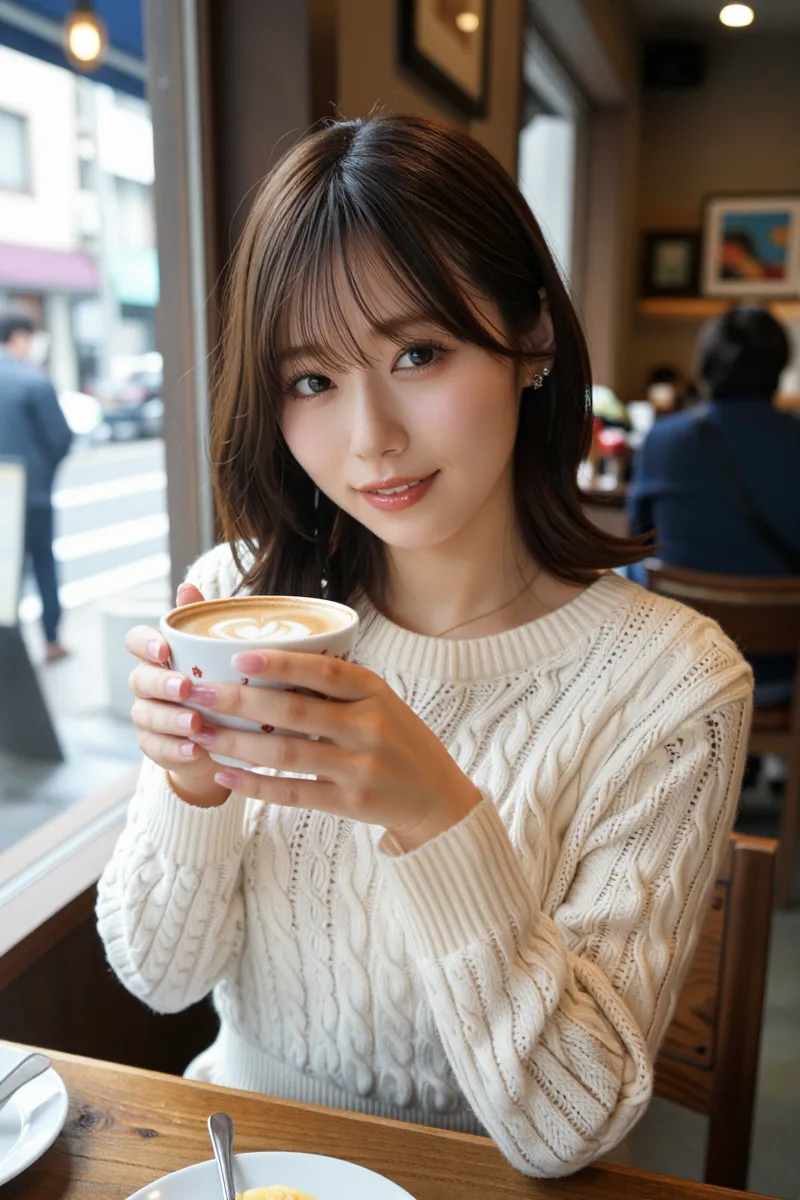
ComfyUIで説明文とシード値だけを使ってカフェで作った例(1枚目)ComfyUIで説明文とシード値だけを使ってカフェで作った例(2枚目)ComfyUIで説明文とシード値だけを使ってカフェで作った例(3枚目)ComfyUIで説明文とシード値だけを使ってカフェで作った例(4枚目)
この4枚のプロンプト(シード値 2510〜2513)
Photorealistic photograph of a beautiful 20-year-old Japanese woman, stylish Tokyo fashion model look, defined eyes with soft brown eyeliner, glossy peach-pink lips, glossy dark brown hair in a chin-length bob with see-through bangs, one side tucked behind her ear, small silver stud earrings, wearing a cream cable-knit sweater, waist-up, sitting at a window seat in a cozy Tokyo cafe holding a latte with both hands, soft smile, warm daylight from the window, shot on a 50mm lens

ぱっと見は「あ、同じ人かな」と思うんですよ。前髪もメイクの色も近い。でも元の1枚と顔を並べると、2枚目と4枚目は輪郭がほっそりして大人っぽく、3枚目だけが元の丸い目元に近いくらいです。同じモデルが得意な顔に寄っているだけで、同じ人ではありません。

別人になった説明文とシード値だけ:夜の渋谷(4枚中1枚)
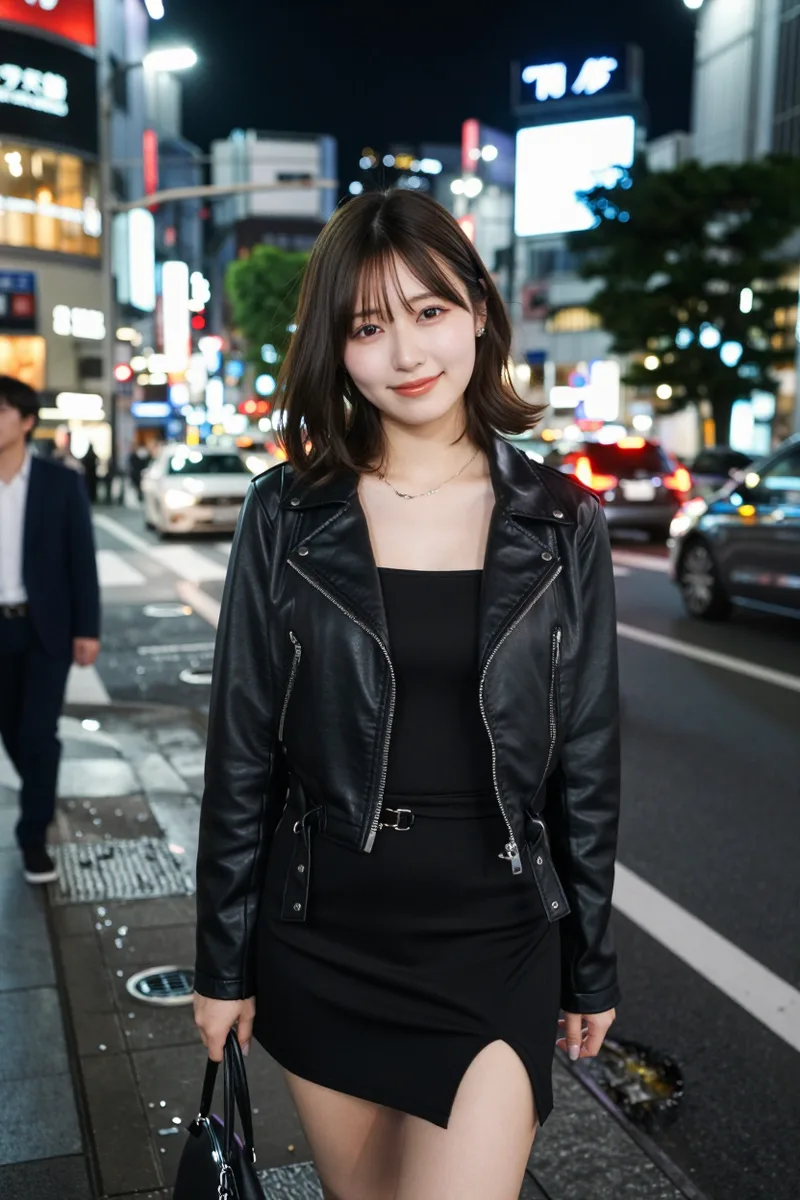
ComfyUIで説明文とシード値だけを使って夜の渋谷で作った例(1枚目)ComfyUIで説明文とシード値だけを使って夜の渋谷で作った例(2枚目)ComfyUIで説明文とシード値だけを使って夜の渋谷で作った例(3枚目)ComfyUIで説明文とシード値だけを使って夜の渋谷で作った例(4枚目)
この4枚のプロンプト(シード値 2510〜2513)
Photorealistic photograph of a beautiful 20-year-old Japanese woman, stylish Tokyo fashion model look, defined eyes with soft brown eyeliner, glossy peach-pink lips, glossy dark brown hair in a chin-length bob with see-through bangs, one side tucked behind her ear, small silver stud earrings, wearing a black mini dress and a short black leather jacket, full-body shot walking on a neon-lit Shibuya street at night, soft smile, glowing city lights, shot on a 35mm lens

別人になった説明文とシード値だけ:プールの水着(4枚中1枚)

ComfyUIで説明文とシード値だけを使ってプールで作った例(1枚目)ComfyUIで説明文とシード値だけを使ってプールで作った例(2枚目)ComfyUIで説明文とシード値だけを使ってプールで作った例(3枚目)ComfyUIで説明文とシード値だけを使ってプールで作った例(4枚目)
この4枚のプロンプト(シード値 2510〜2513)
Photorealistic photograph of a beautiful 20-year-old Japanese woman, stylish Tokyo fashion model look, defined eyes with soft brown eyeliner, glossy peach-pink lips, glossy dark brown hair in a chin-length bob with see-through bangs, one side tucked behind her ear, small silver stud earrings, wearing a white bikini, thigh-up, standing at the edge of a resort pool on a sunny day, soft smile, bright sunlight, shot on a 50mm lens

夜もプールも、本人に見えるのは4枚目だけ。全身を頼んだ夜の渋谷は、全部ひざ上の構図になりました。元と同じシード値の1枚目が、いちばん本人に近いわけでもありません。服と場所のキーワードが変わると、同じシード値でも顔は描き直されます。

ComfyUI(画像編集のモデル):4枚はそろうが、元の人とは別人

次は本命の、元の1枚を参照として渡せる画像編集のモデルです。Comfy Cloud に入っている2つを使いました。

  • Qwen-Image-Edit-2511:Qwen(アリババ)の画像編集のモデル。公式の説明で「人物のそろい方を大きく改善した」とあるバージョンで、速くする LoRA(4ステップ)を付けて回しました
  • FLUX.2 [klein] 4B:Black Forest Labs の軽い画像生成・編集のモデル。参照の画像を渡して編集できます(4ステップ)

別人になったQwen-Image-Edit-2511:カフェ(4枚中1枚)
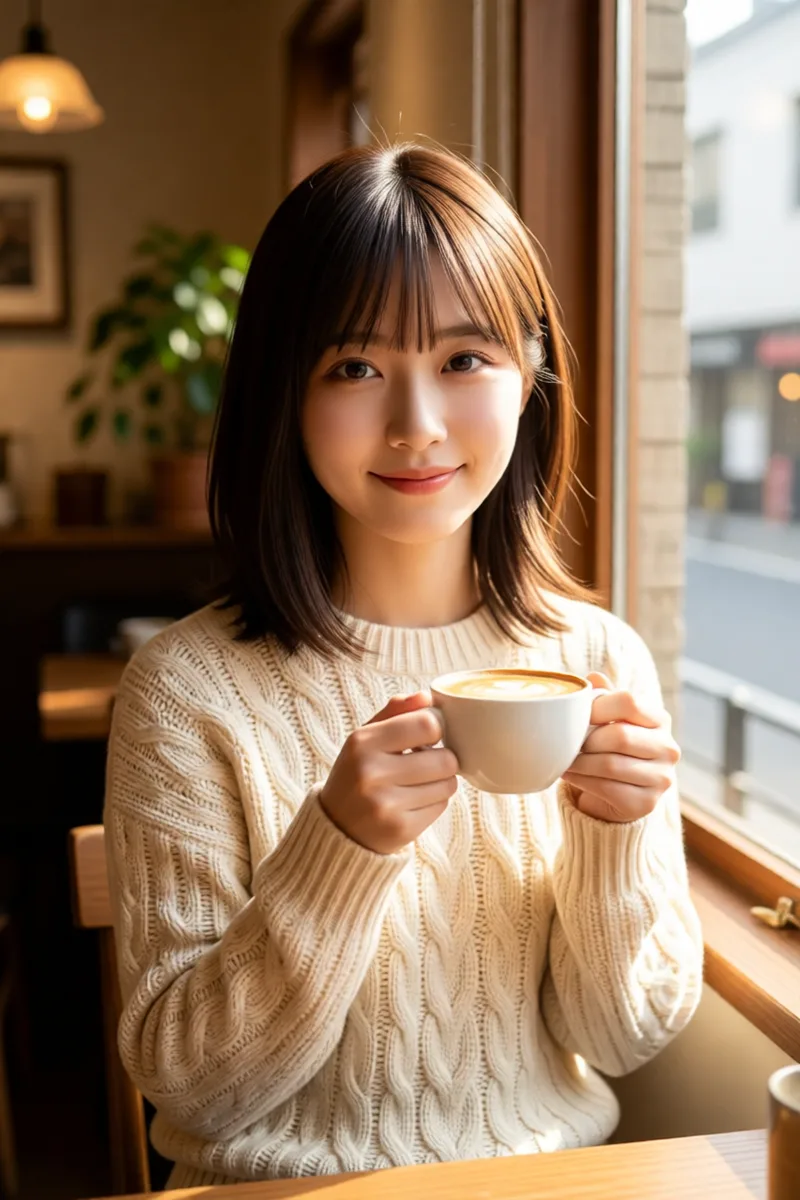
Qwen-Image-Edit-2511に元の1枚を渡してカフェで作った例(1枚目)Qwen-Image-Edit-2511に元の1枚を渡してカフェで作った例(2枚目)Qwen-Image-Edit-2511に元の1枚を渡してカフェで作った例(3枚目)Qwen-Image-Edit-2511に元の1枚を渡してカフェで作った例(4枚目)
この4枚のプロンプト(元の1枚を image 1 に)
Keep the woman's face, facial features, makeup, hairstyle and hair length exactly the same as in image 1. Change only her clothes, pose and the background: she is wearing a cream cable-knit sweater, waist-up, sitting at a window seat in a cozy Tokyo cafe holding a latte with both hands, soft smile, warm daylight from the window. Photorealistic photo.

あれ? 4枚どうしは双子みたいにそろっているのに、元の1枚と比べると、鼻が丸くなって目元のピンクのメイクも消えています。自然光のカフェで撮り直したら、すっぴん寄りの妹さんが来た感じ。本人に見えるのは3枚目くらいです。

別人になったQwen-Image-Edit-2511:夜の渋谷(4枚中0枚)・水着(4枚中1枚)
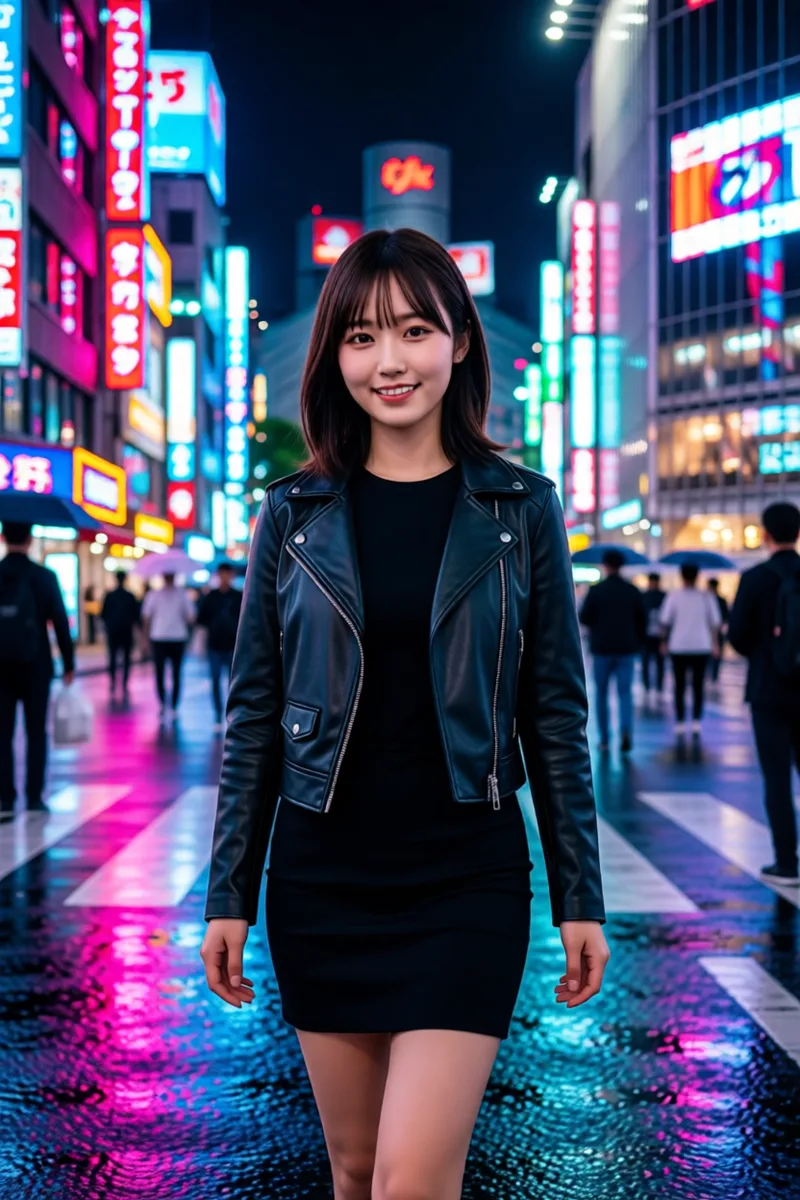
Qwen-Image-Edit-2511に元の1枚を渡して夜の渋谷で作った例(1枚目)
夜の渋谷
Qwen-Image-Edit-2511に元の1枚を渡して夜の渋谷で作った例(2枚目)
Qwen-Image-Edit-2511に元の1枚を渡して夜の渋谷で作った例(3枚目)
Qwen-Image-Edit-2511に元の1枚を渡して夜の渋谷で作った例(4枚目)
Qwen-Image-Edit-2511に元の1枚を渡してプールで作った例(1枚目)
プールの水着
Qwen-Image-Edit-2511に元の1枚を渡してプールで作った例(2枚目)
Qwen-Image-Edit-2511に元の1枚を渡してプールで作った例(3枚目)
Qwen-Image-Edit-2511に元の1枚を渡してプールで作った例(4枚目)
この8枚のプロンプト(元の1枚を image 1 に)
Keep the woman's face, facial features, makeup, hairstyle and hair length exactly the same as in image 1. Change only her clothes, pose and the background: she is wearing a black mini dress and a short black leather jacket, full-body shot walking on a neon-lit Shibuya street at night, soft smile, glowing city lights(水着は wearing a white bikini, thigh-up, standing at the edge of a resort pool on a sunny day, soft smile, bright sunlight). Photorealistic photo.

夜の渋谷は、ネオンの赤みで頬の色が濃くなり、4枚とも別の人。水着は ChatGPT と違って止められずに作れて、4枚とも同じ顔でそろっています。でもやっぱり元の1枚とは少し違う顔で、本人と言えるのは2枚目だけでした。

別人になったFLUX.2 [klein] 4B:カフェ・夜の渋谷・水着(12枚中0枚)
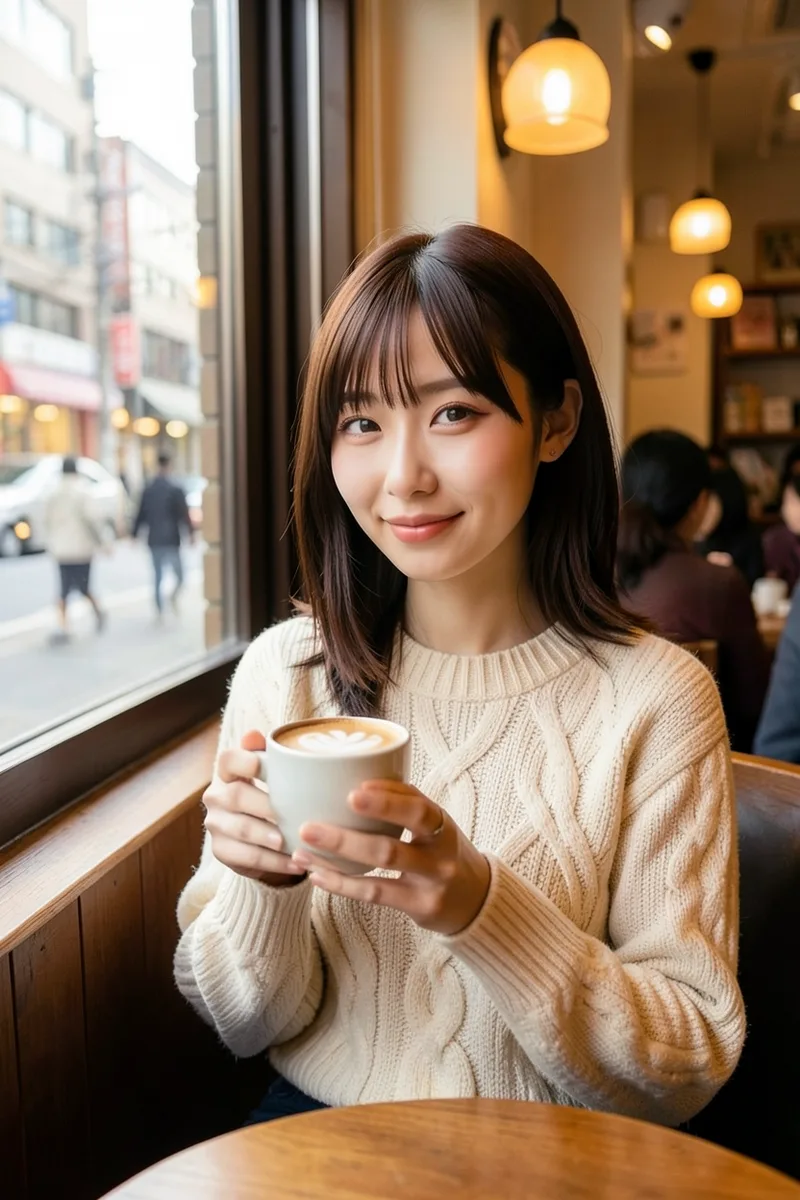
FLUX.2 kleinに元の1枚を渡してカフェで作った例(1枚目)
カフェ
FLUX.2 kleinに元の1枚を渡してカフェで作った例(2枚目)
FLUX.2 kleinに元の1枚を渡してカフェで作った例(3枚目)
FLUX.2 kleinに元の1枚を渡してカフェで作った例(4枚目)
FLUX.2 kleinに元の1枚を渡して夜の渋谷で作った例(1枚目)
夜の渋谷
FLUX.2 kleinに元の1枚を渡して夜の渋谷で作った例(2枚目)
FLUX.2 kleinに元の1枚を渡して夜の渋谷で作った例(3枚目)
FLUX.2 kleinに元の1枚を渡して夜の渋谷で作った例(4枚目)
FLUX.2 kleinに元の1枚を渡してプールで作った例(1枚目)
プールの水着
FLUX.2 kleinに元の1枚を渡してプールで作った例(2枚目)
FLUX.2 kleinに元の1枚を渡してプールで作った例(3枚目)
FLUX.2 kleinに元の1枚を渡してプールで作った例(4枚目)
この12枚のプロンプト(元の1枚を参照の画像に)
A photorealistic photo of the woman from the reference image, with exactly the same face, facial features, makeup, hairstyle and hair length as in the reference image. She is [場面の差し替え部分].

klein は、12枚とも元より年上の、落ち着いたお姉さんになりました。夜の渋谷は歯を見せて笑う別人です。体の形や服はとてもきれいに出るので、狙いの場面を作るのは上手。でも顔をそろえる用途では、今回は1枚も本人になりませんでした。

服だけ変えると、顔はそのまま残った

場所や光まで変えるから、顔まで描き直されるのでは? と思い、背景も光もそのままで、Tシャツをニットに替えるだけの編集を頼みました。

そろった服だけ変える:Qwen-Image-Edit-2511(4枚中4枚)・FLUX.2 [klein](4枚中4枚)
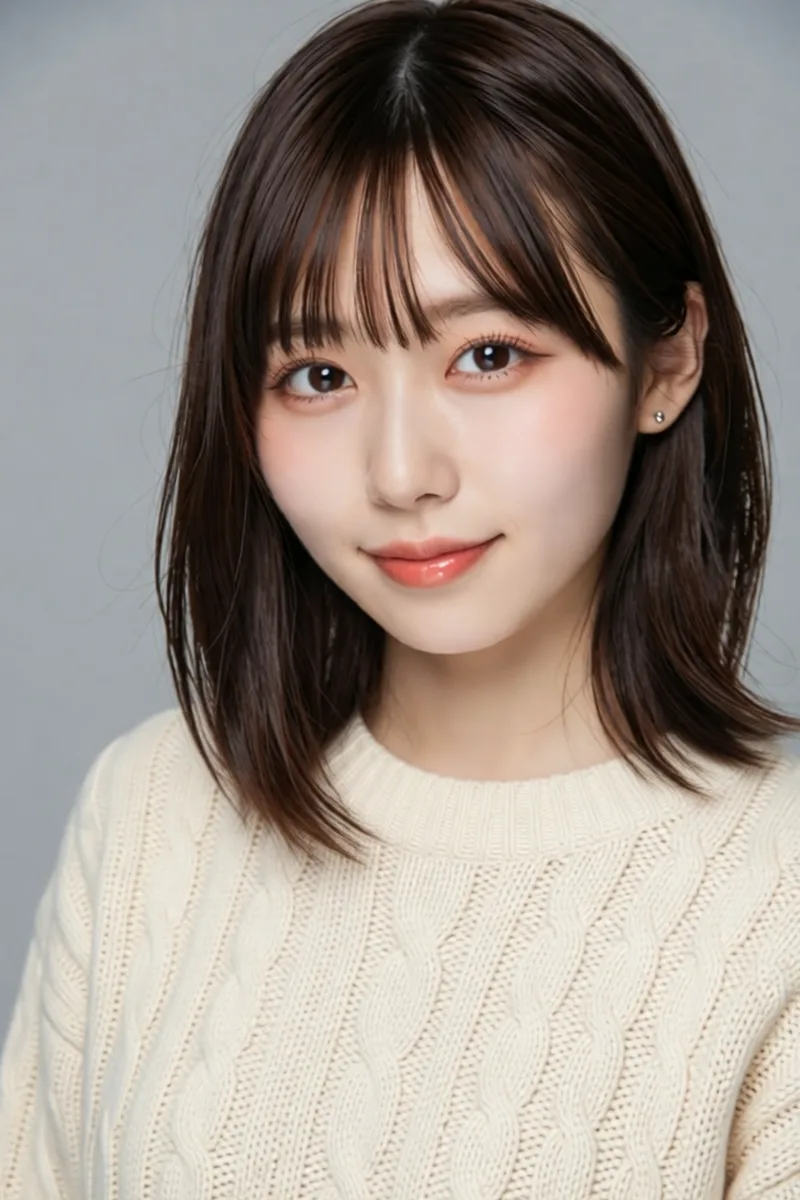
Qwen-Image-Edit-2511で服だけを変えた例(1枚目)
Qwen
Qwen-Image-Edit-2511で服だけを変えた例(2枚目)
Qwen-Image-Edit-2511で服だけを変えた例(3枚目)
Qwen-Image-Edit-2511で服だけを変えた例(4枚目)
FLUX.2 kleinで服だけを変えた例(1枚目)
klein
FLUX.2 kleinで服だけを変えた例(2枚目)
FLUX.2 kleinで服だけを変えた例(3枚目)
FLUX.2 kleinで服だけを変えた例(4枚目)
Qwen の4枚のプロンプト
Change only her white t-shirt to a cream cable-knit sweater. Keep her face, expression, makeup, hairstyle, pose, the gray studio background and the lighting exactly the same.
klein の4枚のプロンプト
The same photo as the reference image with the same woman, same face, expression, makeup, hairstyle, pose, gray studio background and lighting, but she wears a cream cable-knit sweater instead of the white t-shirt.

おお!8枚とも本人。目元のメイクも、ほんの少し上がった口角もそのままで、着替えた服だけが違います。画像編集のモデルは、変えるところが小さいほど元の顔を残し、場所や光まで変えると顔ごと描き直すみたいですね。

顔を戻す編集をもう1回行うと、4枚中2枚は本人に寄った

じゃあ場所を変えたあとに、顔だけ元に戻せないか。Qwen にカフェの1枚(image 1)と元の1枚(image 2)の2枚を渡して、顔だけ入れ替えてもらいました。

直したあとQwen-Image-Edit-2511:カフェの画像に元の顔を戻す(4枚中2枚)
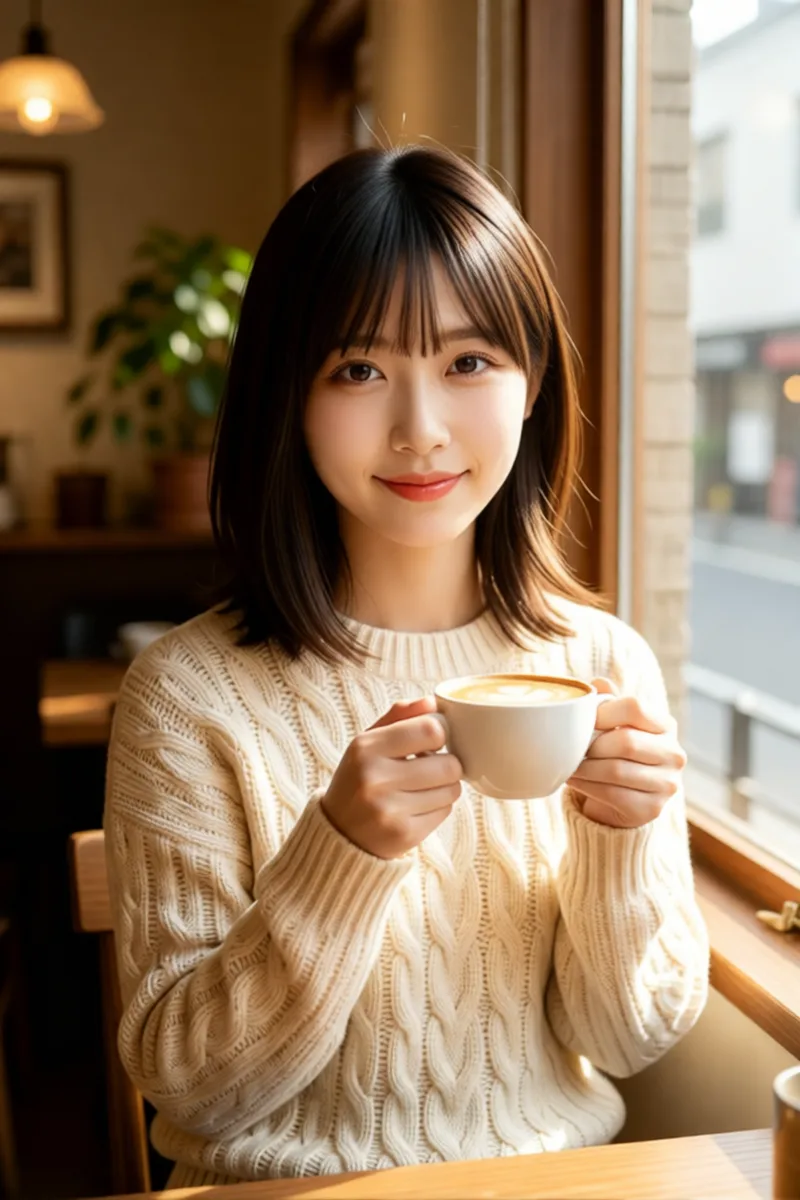
Qwen-Image-Edit-2511でカフェの画像に元の1枚の顔を戻した例(1枚目)Qwen-Image-Edit-2511でカフェの画像に元の1枚の顔を戻した例(2枚目)Qwen-Image-Edit-2511でカフェの画像に元の1枚の顔を戻した例(3枚目)Qwen-Image-Edit-2511でカフェの画像に元の1枚の顔を戻した例(4枚目)
この4枚のプロンプト(カフェの画像を image 1、元の1枚を image 2 に)
Replace the woman's face in image 1 with the face of the woman in image 2: the same eyes, eyelids, nose, lips, face shape and makeup as image 2. Keep everything else in image 1 exactly the same: her clothes, pose, hair, the background and the lighting.

2枚目と3枚目は、目元のメイクが戻って本人に寄りました。1枚目と4枚目は、カフェの暖かい光のまま元の顔に寄せきれていません。同じやり方を夜の渋谷でも2枚試しましたが、こちらはネオンの色に負けて変わりませんでした。

ComfyUI で何百枚も同じ人を回したいなら、本命はその人の画像で LoRA(追加の学習)を作る方法です。とはいえ学習の手間がかかるので、別の企画で試します。ComfyUI で動画を作る場合(Wan 2.2)に顔がどう保たれるかも、別の記事で扱う予定です。

裏側:Qwen に髪型をキーワードでも書いたら、髪を切られた

画像編集のモデルの1回目は、頼み方を間違えました。最初は ChatGPT と同じように「same face … the same glossy dark brown bob」と、髪型をキーワードでも書いていたんです。

効かなかった髪型をキーワードで書いた Qwen-Image-Edit-2511:カフェ
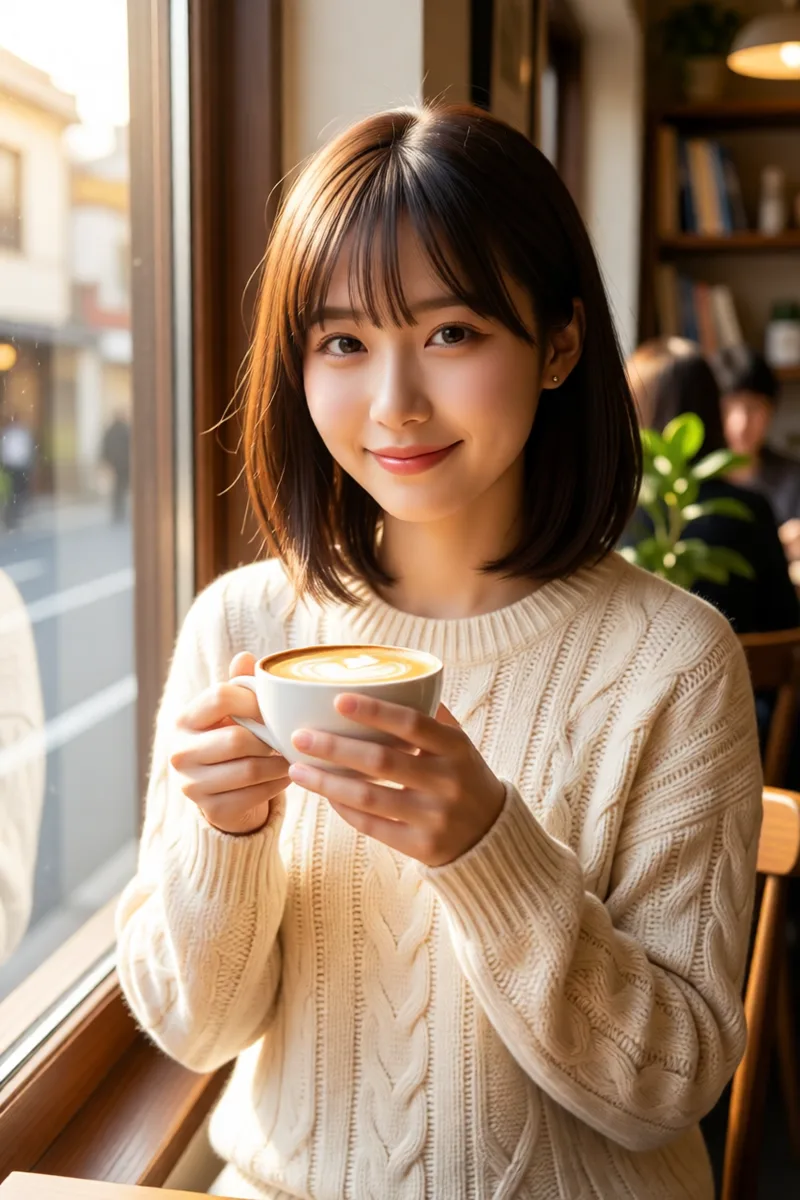
髪型をキーワードで書いたQwen-Image-Edit-2511のカフェの例(1枚目)髪型をキーワードで書いたQwen-Image-Edit-2511のカフェの例(2枚目)髪型をキーワードで書いたQwen-Image-Edit-2511のカフェの例(3枚目)髪型をキーワードで書いたQwen-Image-Edit-2511のカフェの例(4枚目)
この4枚のプロンプト(元の1枚を image 1 に)
Keep the exact same woman from image 1 with the same face, same eyes, same makeup, the same glossy dark brown bob with see-through bangs and the same small silver stud earrings. Change her outfit and the place: she is now wearing a cream cable-knit sweater, waist-up, sitting at a window seat in a cozy Tokyo cafe holding a latte with both hands, soft smile, warm daylight from the window. Photorealistic photo.

・・・髪、切ってますよね。元の1枚は肩につく長さなのに、4枚ともあご丈のボブです。元の1枚を作ったプロンプトにも「chin-length bob」と書いてあったので、元の画像とプロンプトが食い違っていて、Qwen はプロンプトのほうを信じました。ChatGPT は同じキーワードを書いても元の写真の長さを守ったので、ここは性格の違いですね。

そこで髪型のキーワードを消して「hairstyle and hair length exactly the same as in image 1(髪型と長さは image 1 のまま)」に替えたのが、上で見せた作例です。

直したあと髪型をキーワードで書かない Qwen-Image-Edit-2511:カフェ

髪型をキーワードで書かないQwen-Image-Edit-2511のカフェの例(1枚目)髪型をキーワードで書かないQwen-Image-Edit-2511のカフェの例(2枚目)髪型をキーワードで書かないQwen-Image-Edit-2511のカフェの例(3枚目)髪型をキーワードで書かないQwen-Image-Edit-2511のカフェの例(4枚目)
この4枚のプロンプト(元の1枚を image 1 に)
Keep the woman's face, facial features, makeup, hairstyle and hair length exactly the same as in image 1. Change only her clothes, pose and the background: she is wearing a cream cable-knit sweater, waist-up, sitting at a window seat in a cozy Tokyo cafe holding a latte with both hands, soft smile, warm daylight from the window. Photorealistic photo.

髪の長さは戻りました。画像を渡すなら、渡した画像に写っていることは言葉で書き直さず「image 1 のまま」と書くのが安全です。ちなみに、速くする LoRA を外して30ステップで回したり、klein を大きい 9B に替えたりもしましたが、場所を変えたときの顔が元の人に近づくことはありませんでした。

Kling 3.0:1本の中では顔が崩れにくい。遠くで振り返ると崩れた

ここからは動画です。Kling 3.0 を Higgsfield の中から使い、ChatGPT で作ったカフェと夜の渋谷の1枚ずつを最初のコマ(start frame)にして、5秒ずつ作りました。頼んだのは、顔が崩れやすい「横を向いて戻る」「背中を向けて遠くへ歩き、振り返る」動きです。

最初のコマだけKling 3.0:カフェで横を向く・夜の渋谷で遠くへ歩いて振り返る

カフェ
夜の渋谷
カフェのプロンプト
She sets the latte down on the table, turns her head to look out the window for a moment, then turns back to the camera and smiles. The camera stays still. Natural, realistic motion.
夜の渋谷のプロンプト
She turns around and walks away from the camera into the crowd on the neon-lit street, then stops and looks back over her shoulder at the camera with a smile. The camera stays still. Natural, realistic motion.

カフェはすごい。横顔になっても、正面に戻って笑っても本人のままです。1コマずつ切り出しても、別人に変わる瞬間がありませんでした。

夜の渋谷は、頼んだとおり背中を向けて人混みのほうへ歩いていき、最後に振り返ってくれます。ただ、その振り返った顔が遠くて小さいぶん、ぼやけて別の人に。最初のコマの顔から離れるほど、Kling が顔を想像で描くしかなくなるんだと思います。

正面・斜め・横の3枚を渡すと、顔は保てたが動きが控えめになった

そこで、正面(元の1枚)・斜め・横の3枚を「この人」として登録し、同じ最初のコマ・同じ動きでもう一度作りました。Kling 本家の Element Library と同じく、Higgsfield でも人物の参照(Elements)を作って、プロンプトの中で呼べます。斜めと横の2枚は、Qwen-Image-Edit-2511 に「スタジオのまま向きだけ変えて」と頼んで作りました。
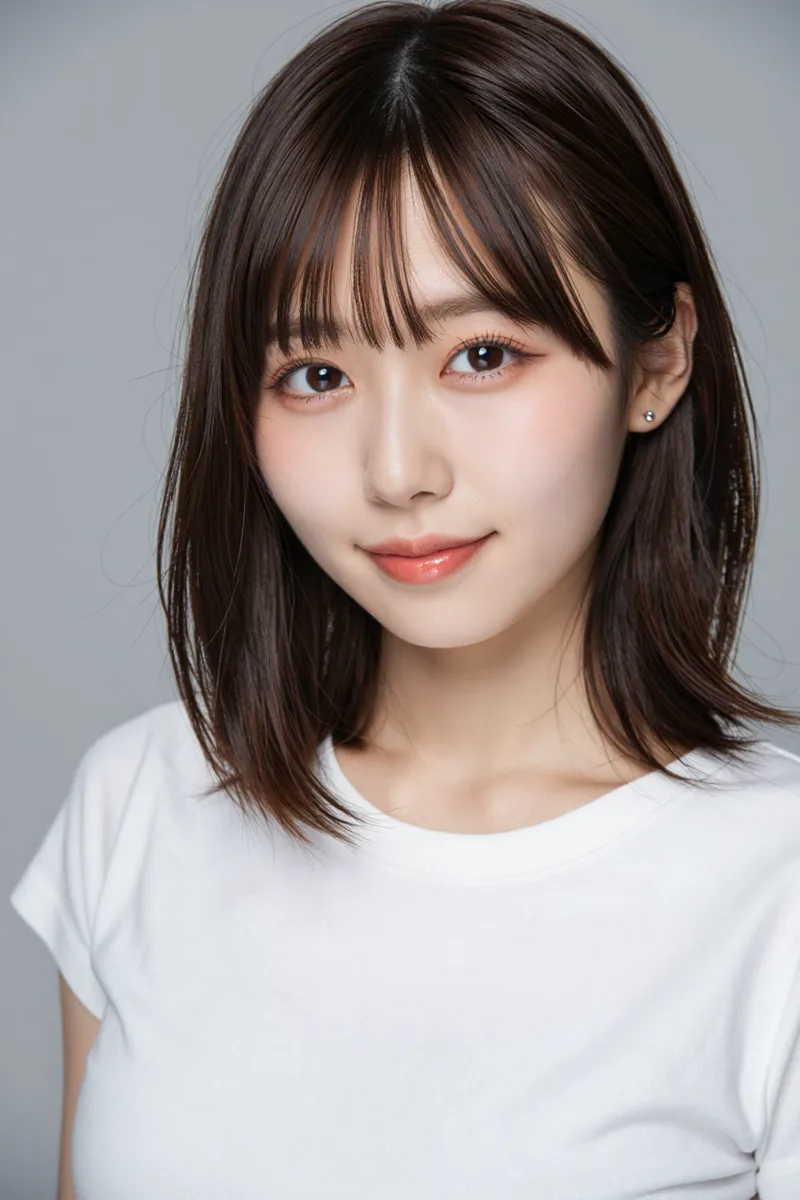
Kling に渡した正面・斜め・横の3枚(1枚目)Kling に渡した正面・斜め・横の3枚(2枚目)Kling に渡した正面・斜め・横の3枚(3枚目)

3枚を渡したKling 3.0+正面・斜め・横の3枚:カフェ・夜の渋谷

カフェ
夜の渋谷
プロンプト
上の2本と同じ文の頭の She を、登録した人物の呼び出し(@名前)に替えた

カフェは、窓の外を見る横顔も、最後に笑って振り向く顔も本人。夜の渋谷は、最後まで本人の顔のまま……なんですが、背中を向けて遠くへ歩く動きを1回もしてくれませんでした。こっちへ歩いてきて、ちらっと横を見るだけ。顔を見せ続けることを優先した、という感じです。Kling の公式の説明では、登録した人物は最初のコマに写っていることが条件で、結びつけられるのは3人まで。登録した顔を見失わないように、背中を向ける動きを避けたのかもしれません。

Higgsfield の Soul ID:20枚で学習すると、水着でも本人の顔が続いた

Soul ID は、同じ人の写真を20枚以上渡して、その人の顔を覚えさせる Higgsfield の機能です。覚えた顔は、Higgsfield の画像生成の Soul 2.0 で、プロンプトに人物の説明を書かなくても呼び出せます。公式のヘルプには「架空の人物なら、先に肖像を作ってから学習する」とあるので、その手順でやりました。

学習に使ったのは、元の1枚・斜め・横に、Qwen-Image-Edit-2511 で作った17枚を足した20枚です。上で分かった「背景と光はそのままで、服・表情・向きだけ変えると顔が残る」を使って、グレーのスタジオのまま作りました。

学習に使ったSoul ID の学習に使った20枚のうちの8枚
Soul IDの学習に使った架空の人物の画像(1枚目)Soul IDの学習に使った架空の人物の画像(2枚目)Soul IDの学習に使った架空の人物の画像(3枚目)Soul IDの学習に使った架空の人物の画像(4枚目)Soul IDの学習に使った架空の人物の画像(5枚目)Soul IDの学習に使った架空の人物の画像(6枚目)Soul IDの学習に使った架空の人物の画像(7枚目)Soul IDの学習に使った架空の人物の画像(8枚目)
Qwen に頼んだプロンプト(例:グレーのパーカー)
Keep her face, facial features, makeup, hairstyle, the plain light gray studio background and the soft even lighting exactly the same. Change only her clothes and pose: a gray hoodie, sitting on a white stool, waist-up, gentle smile.

学習は10分ほどで終わって、25クレジットでした。Soul 2.0 では、人物の説明を書かずに、服と場所だけのプロンプトで3場面を4枚ずつ作りました。

そろったSoul ID+Soul 2.0:カフェ(4枚中4枚)・夜の渋谷(4枚中3枚)・水着(4枚中3枚)
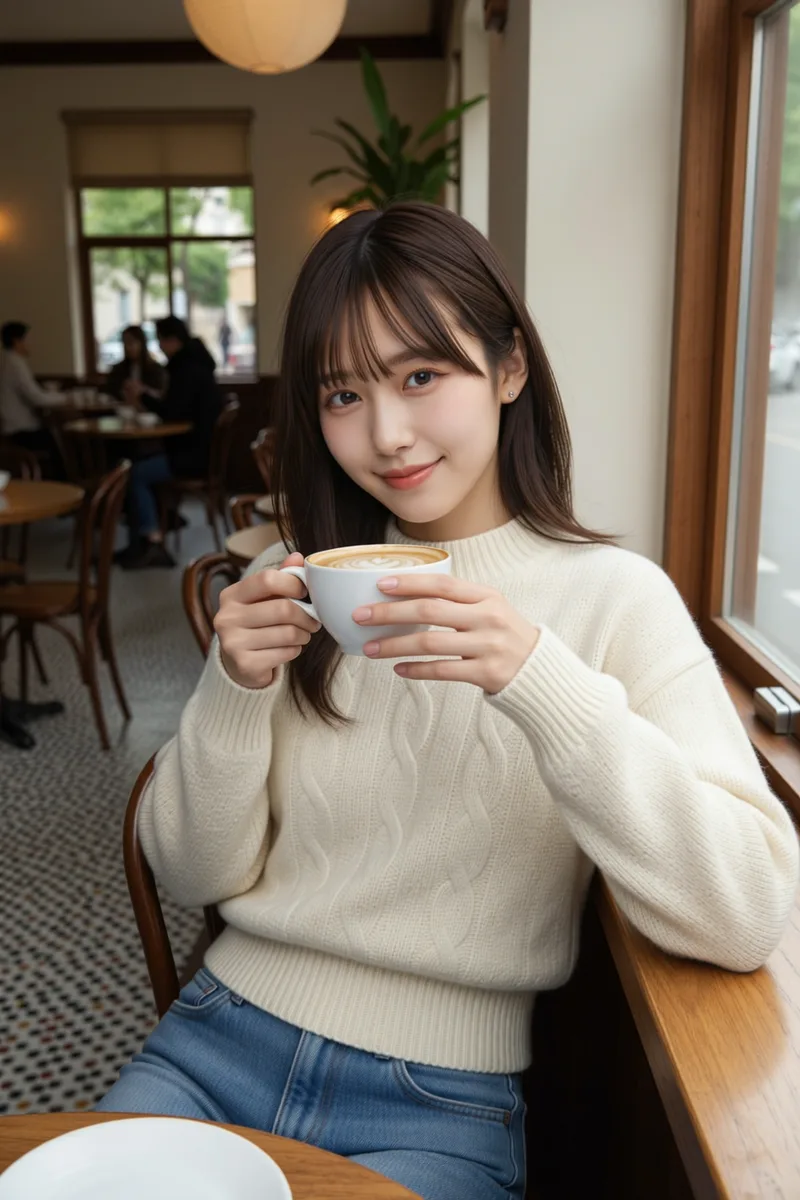
Soul IDで学習した人物をSoul 2.0のカフェで作った例(1枚目)
カフェ
Soul IDで学習した人物をSoul 2.0のカフェで作った例(2枚目)
Soul IDで学習した人物をSoul 2.0のカフェで作った例(3枚目)
Soul IDで学習した人物をSoul 2.0のカフェで作った例(4枚目)
Soul IDで学習した人物をSoul 2.0の夜の渋谷で作った例(1枚目)
夜の渋谷
Soul IDで学習した人物をSoul 2.0の夜の渋谷で作った例(2枚目)
Soul IDで学習した人物をSoul 2.0の夜の渋谷で作った例(3枚目)
Soul IDで学習した人物をSoul 2.0の夜の渋谷で作った例(4枚目)
Soul IDで学習した人物をSoul 2.0のプールで作った例(1枚目)
プールの水着
Soul IDで学習した人物をSoul 2.0のプールで作った例(2枚目)
Soul IDで学習した人物をSoul 2.0のプールで作った例(3枚目)
Soul IDで学習した人物をSoul 2.0のプールで作った例(4枚目)
この12枚のプロンプト(学習した Soul ID を選んで)
Photorealistic photo of the woman wearing a cream cable-knit sweater, waist-up, sitting at a window seat in a cozy Tokyo cafe holding a latte with both hands, soft smile, warm daylight from the window(夜の渋谷と水着は、場面の差し替え部分を入れ替え)

これはいい感じ!カフェは4枚とも本人で、4枚目はなぜかラテを2杯頼んでいます。夜の渋谷は、説明文とシード値だけだとひざ上までだった全身も、ちゃんと頭から足先まで出ました。2枚目だけ前髪が消えて、別の人になっています。

水着も、ChatGPT と違って止められずに作れました。本人に見えるのは12枚中10枚で、画像なら ChatGPT の次にそろった方法です。ただ、学習に使った20枚は全部肩までの髪なのに、水着は4枚中3枚が胸まで伸びた髪になりました。水着の3枚目は輪郭が面長で、ちょっと別の人寄りです。

Soul ID の人物を動画にすると、顔は「似た人」に寄った

学習した Soul ID は、動画の Seedance 2.0 では人物の参照(Elements)として呼べます。ここでは最初のコマを渡さずに、文章だけでカフェと夜の渋谷の2本を作りました(480p・音なし)。Soul 2.0 の夜の渋谷の1枚を最初のコマにした Kling 3.0 も1本作りました。

似た人になったSeedance 2.0+Soul ID の人物:カフェ・夜の渋谷

Seedance カフェ
Seedance 夜の渋谷
夜の渋谷のプロンプト(@ で Soul ID の人物を呼ぶ)
@人物 wearing a black mini dress and a short black leather jacket turns around and walks away from the camera into the crowd on a neon-lit Shibuya street at night, then stops and looks back over her shoulder at the camera with a smile. The camera stays still. Photorealistic.

Seedance は、頼んだ動きをいちばん素直にやってくれました。夜の渋谷で背中を向けて人混みへ歩き、ちゃんと振り返って笑います。ただ顔は、出だしから元の人より少し大人びて、ピンクの目元のメイクもありません。Soul ID から Seedance の参照に渡っていたのは、学習に使った20枚のうち、白いワンピースで顔が小さく写った全身の1枚だけでした。学習した顔そのものが動画に使われるわけではなさそうです。

振り返ると崩れたKling 3.0:Soul 2.0 の夜の渋谷の1枚を最初のコマに

Kling 夜の渋谷
プロンプト
She turns around and walks away from the camera into the crowd on the neon-lit street, then stops and looks back over her shoulder at the camera with a smile. The camera stays still. Natural, realistic motion.

Kling は、背中を向けて歩いていったはずが、振り返った瞬間には手前に戻っています。しかもその顔は、歯を見せて大きく笑う別の人。ChatGPT の1枚から作ったときと同じで、背中を向けたあとの顔は、最初のコマを覚えていないみたいですね。

よくある質問

IP-Adapter は、今のモデルで顔をそろえるのに使える?

IP-Adapter は、参照の画像から顔や雰囲気を写し取る追加のモデルです。2026年10月29日の時点で Comfy Cloud に入っている IP-Adapter のモデルは、SD1.5・SDXL・Kolors 用だけで、この記事で使った Z-Image・Qwen-Image・FLUX.2 向けのものはありませんでした。ノードを作っている ComfyUI_IPAdapter_plus も、2025年4月14日から「maintenance only(保守だけ)」になっています。今のモデルで元の顔を渡すなら、この記事の画像編集のモデルに参照として渡すのが手軽です。

シード値を固定すれば、同じ顔になる?

プロンプトを変えなければ同じ画像になりますが、服や場所のキーワードを変えると顔も描き直されます。今回、元の1枚と同じシード値で場面だけ変えた3枚は、どれも元の人に見えませんでした。

Soul ID の学習に、実在の人の写真を使っていい?

Higgsfield の公式のヘルプは「自分か、使う許可をもらった人の写真だけ」としています。架空の人物は、先に肖像を作ってから学習する、と書かれていて、この記事もその手順です。

何枚あれば学習できる?

Higgsfield の Soul ID は、公式のヘルプで「同じ人の写真を20枚以上(80枚まで)」とあります。今回は20枚で学習しました。

やりたいことから選ぶ方法

やりたいこと 選ぶ方法 この記事での結果
同じ人で、服と場所を変えた画像を数枚ChatGPT に元の1枚を添付して「この人のまま服と場所だけ変えて」カフェ・夜の渋谷の8枚とも本人
ChatGPT に止められる服(水着など)でHiggsfield の Soul ID で学習して、Soul 2.0 で作る止められずに作れて、4枚中3枚が本人
ComfyUI で、服だけ替えた画像を量産画像編集のモデルで、背景と光はそのまま服だけ変えるQwen・klein とも8枚とも本人
ComfyUI で、場所も変えて何百枚もその人の LoRA を学習する(別の企画で試します)画像編集のモデルだけでは、場所を変えると似た別人
短い動画(その場で動く)Kling 3.0 に本人の1枚を最初のコマとして渡す横を向いて戻っても本人のまま
動画で遠くへ歩く・振り返る正面・斜め・横の3枚も渡す。動きが控えめになったら、近くで振り返る動きにする顔は保ったが、背中を向ける動きをしなかった
同じ人を、いろんな場所で何十枚も(画像)Soul ID で学習して Soul 2.0 で作るカフェ4・夜の渋谷3・水着3の12枚中10枚が本人

Related

やってみたの記事

すべて見る →