ChatGPTの画像生成プロンプトのコツ|OpenAI公式ガイドの6つをAI美女で4枚ずつ試した
- 53枚
- カテゴリ
- やってみた
OpenAI の公式ガイドにある画像生成のコツを6つ、ChatGPT(Images 2.5)で4枚ずつ試すと、はっきり効いたのは「夜・雨・ネオンの場面は、広さと空気と色まで書く」でした。書いた傘・湯気・ピンクと水色の映り込みが、4枚とも全部出ています。
レンズの数字(35mm・85mm)は背景のぼけ方だけが変わり、見出しで区切る書き方は「文字なし」の指定が守られました。逆に、photorealistic と書く・「足先まで入れる」と書く・直すときに残すものを並べる、の3つは、書かなくても同じ4枚になっています。
先に結論:効いたコツと、変わらなかったコツ
6つのコツを、それぞれ「書いた4枚」と「書かなかった4枚」で比べた結果です。
| 公式ガイドのコツ | 試した書き方 | 結果 |
|---|---|---|
| 夜・雨・ネオンは具体的に書く | 大雨・ぬれた路面のピンクと水色の映り込み・湯気・透明の傘 | 効いた。書いたものが4枚とも全部出た |
| カメラの仕様は見た目の手がかり | 35mm・50mm・85mm f/1.8 | 背景のぼけ方だけ変わった |
| 見出しで区切って書く | Scene・Subject・Details・Constraints | 中身は同じ。「文字なし」は見出しのほうだけ4枚とも守られた |
| photorealistic と書く | Photorealistic photograph of … | 書かなくても写真で、ほぼ同じ |
| 体の写り方を書く | full body visible, feet included | full body だけで足先まで入り、同じ |
| 直すときは「ここだけ変えて」と残すものを書く | Change only the color of her dress … Keep … exactly the same. | 「赤にして」だけでも服以外は変わらず、同じ |
変わらなかった3つは、「書いても意味がない」ではなく、今の ChatGPT が最初からそうしてくれる、ということだと思います。難しい場面や、ほかのツールに移ったときには効く場面があるはずなので、知っておいて損はないコツです。
試した公式ガイド
試したのは、OpenAI が出している画像生成のプロンプトのガイドです。どちらも英語の資料で、GPT Image 2.5 を含む OpenAI の画像生成モデルの書き方がまとまっています。
ガイドのコツはたくさんありますが、人物の写真で差が出そうなものを6つ選びました。肌の毛穴やしわを書く、磨き上げを避ける(no glamorization)のコツは、AIっぽさを消す記事ですでに試しているので、ここでは外しています。
作例は、どれも同じ20歳の人物像で、コツごとに場所と服を変えて ChatGPT で4枚ずつ作りました。
コツ1:夜・雨・ネオンは、広さと空気と色まで書く
公式ガイドには、夜・雨・ネオンのような場面は、雰囲気の言葉だけに頼らず、広さ・空気・色を書くように、とあります。まずは雰囲気の言葉だけ。
書かなかった雰囲気の言葉だけ:moody neon rainy night atmosphere
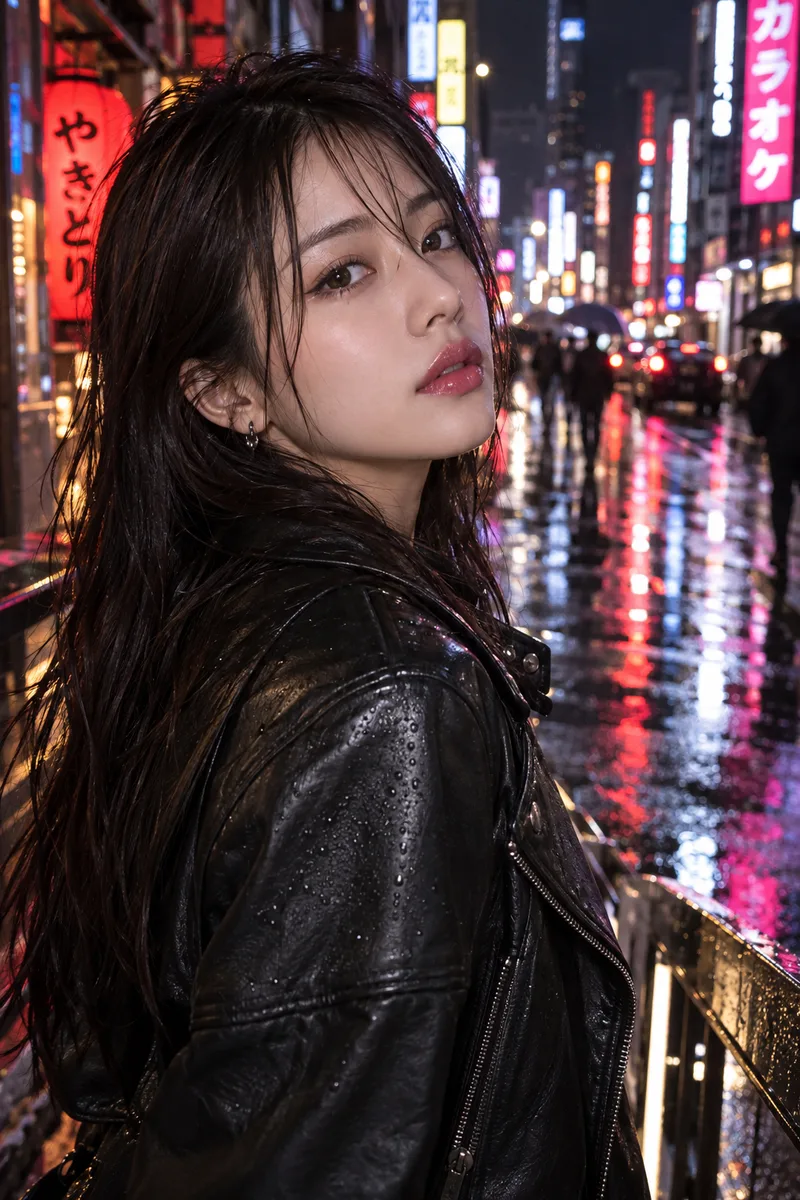
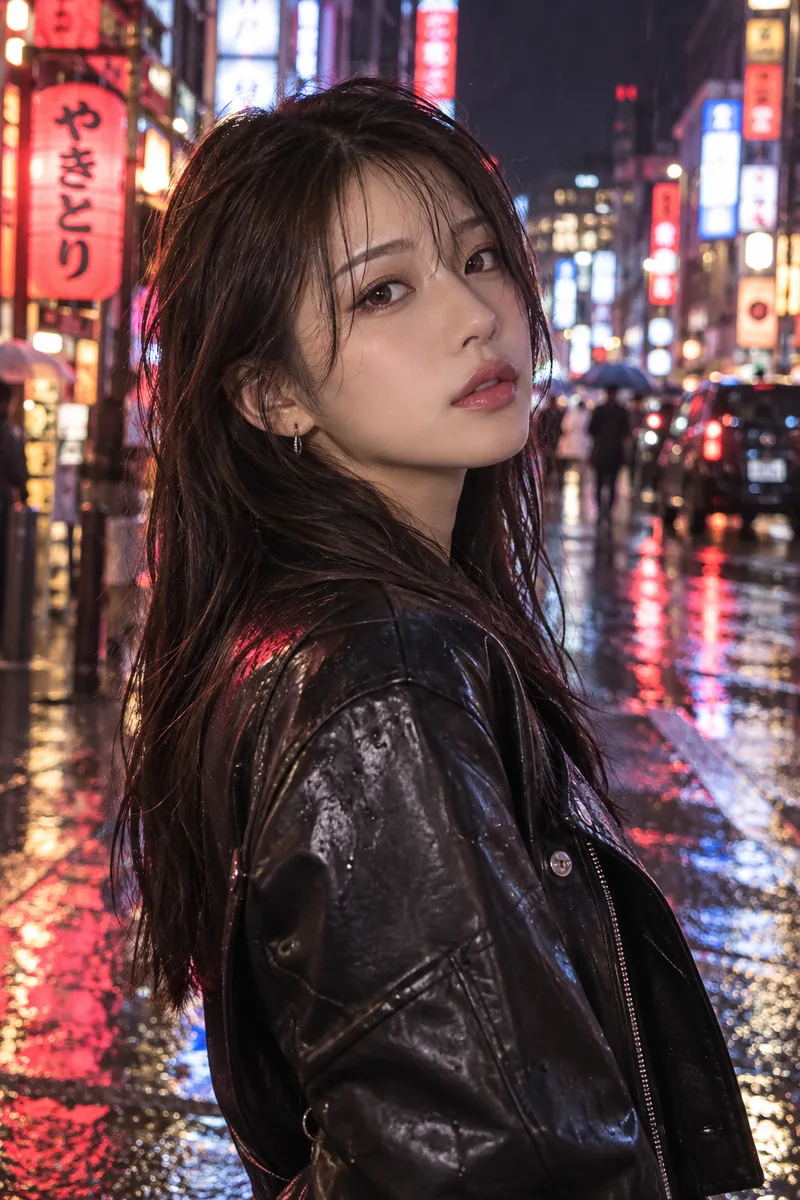
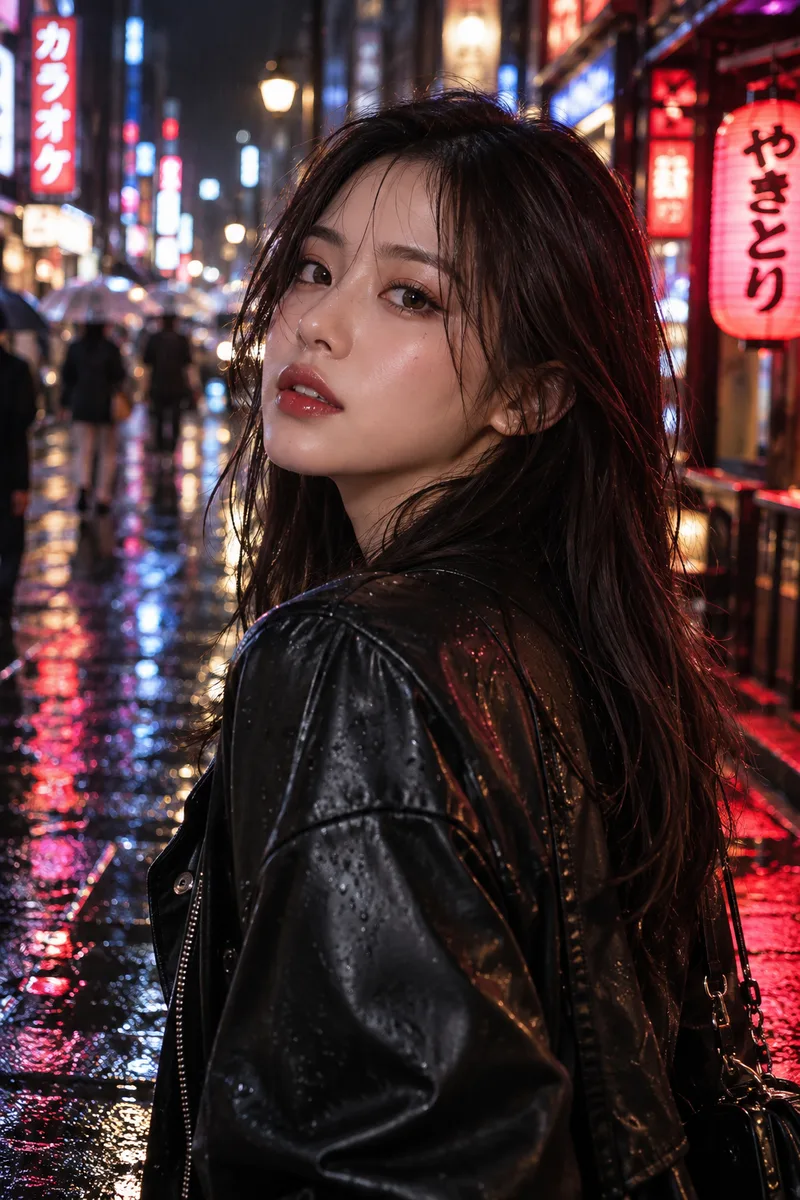
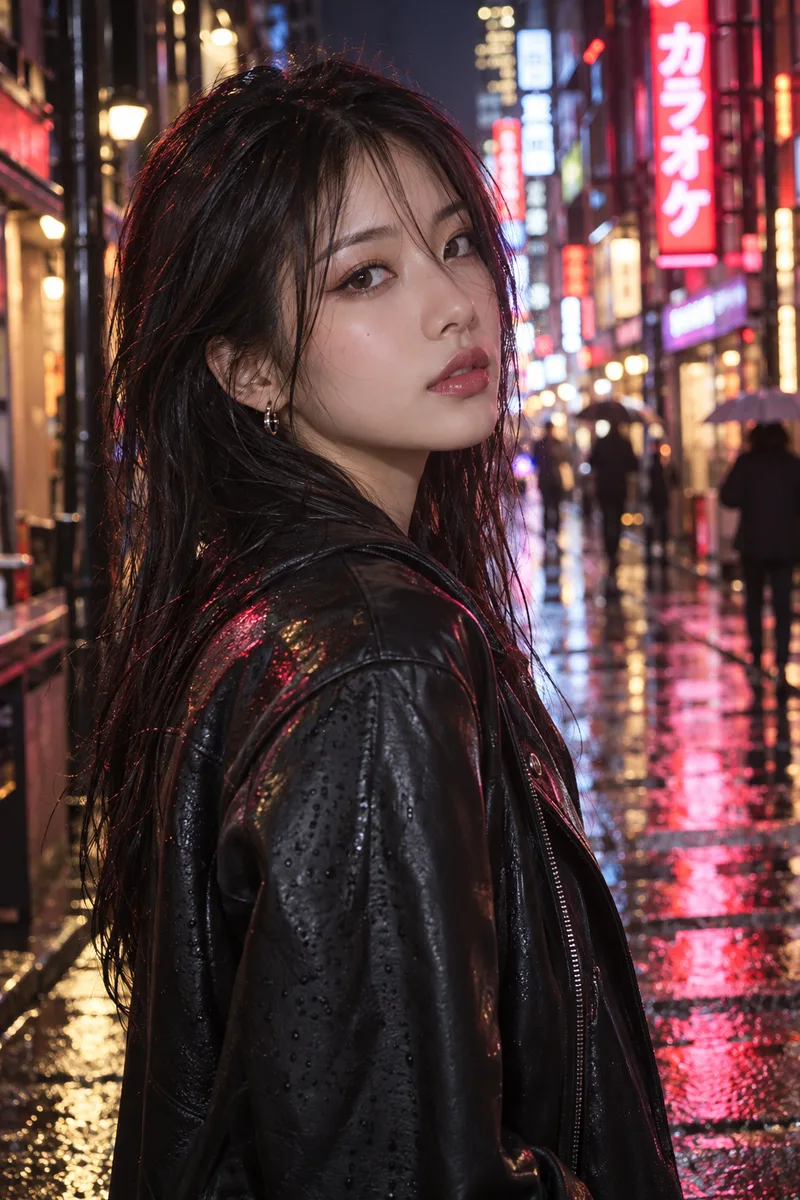
おお、これでも十分に雨のネオン街。ぬれた路面に赤い光が映り、髪も革のジャケットもしっとりぬれています。ただ、色は赤ばかりで、広い通りに傘の通行人。どんな夜になるかは AI 任せです。
次に、ガイドどおり、場所の広さ(遠くまで続く細い路地)・空気(大雨・光の中の雨すじ・湯気)・色(ピンクと水色のネオン、顔に青い影とマゼンタ)を書きました。
コツどおり広さ・空気・色を書いた:standing on a narrow side street at night in heavy rain, wet asphalt reflecting pink and cyan neon signs …
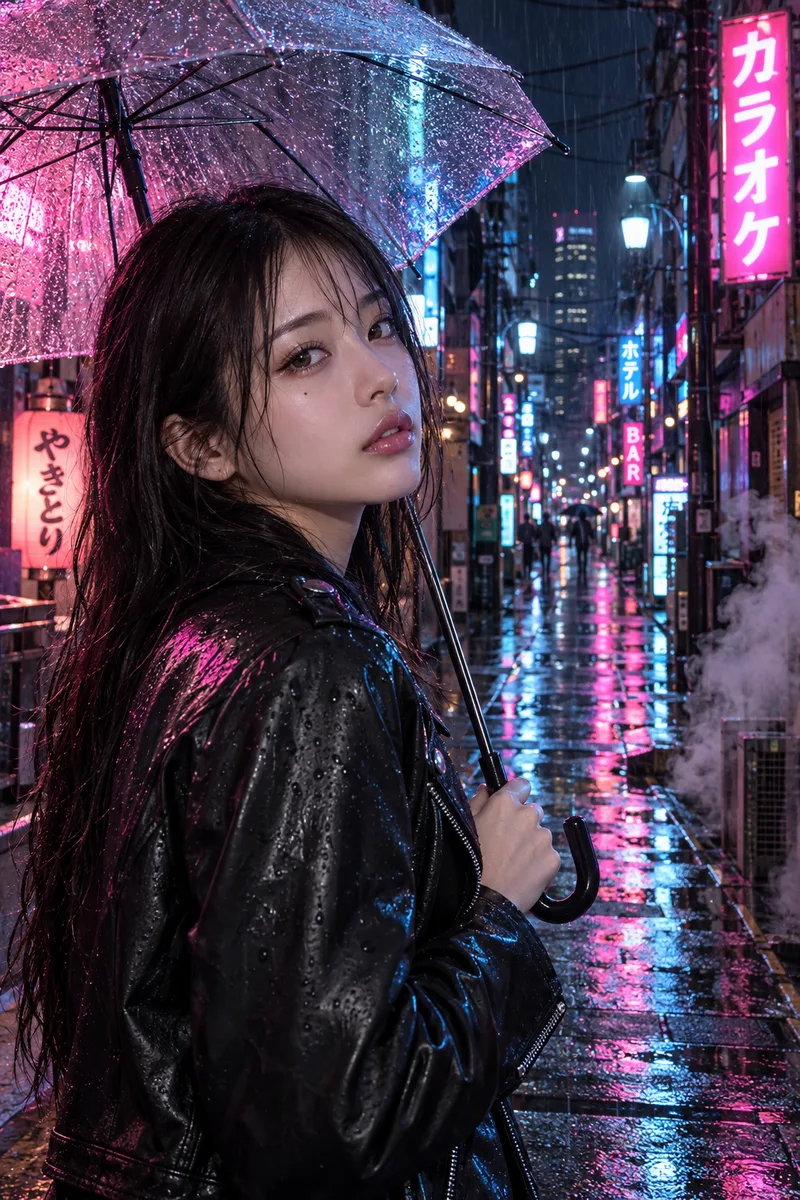
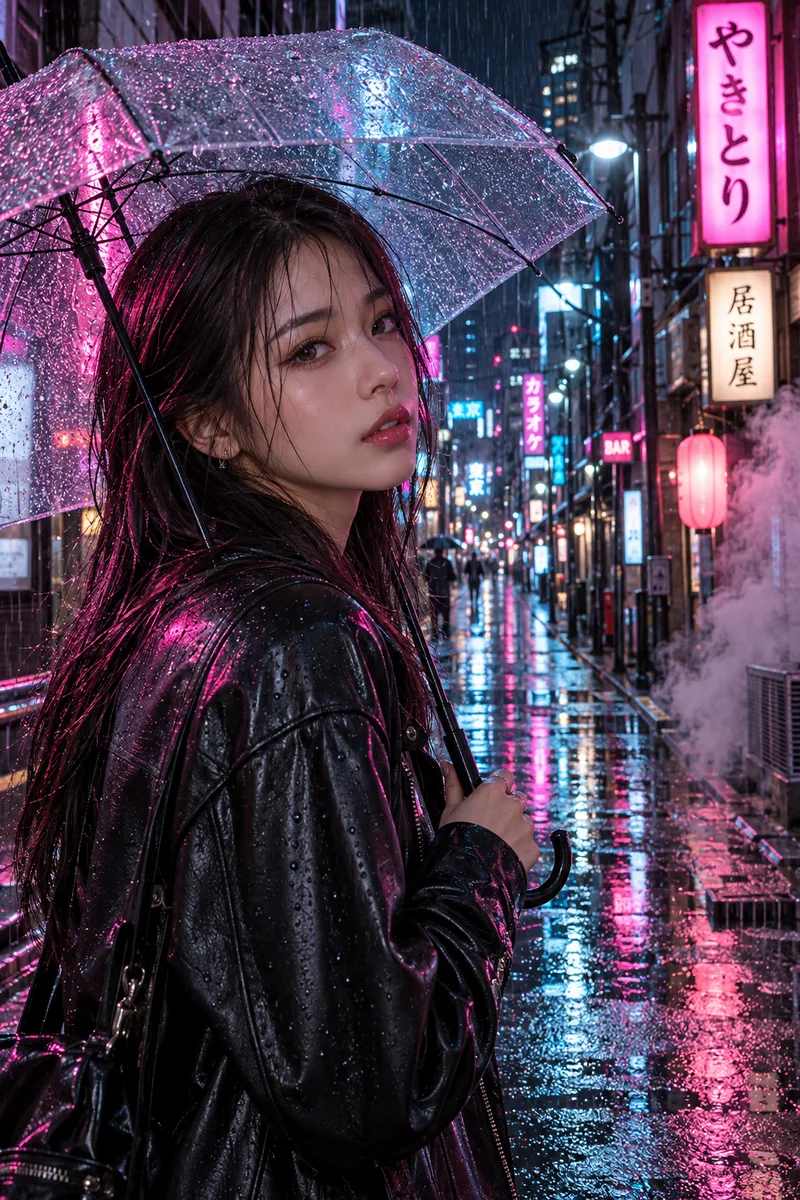
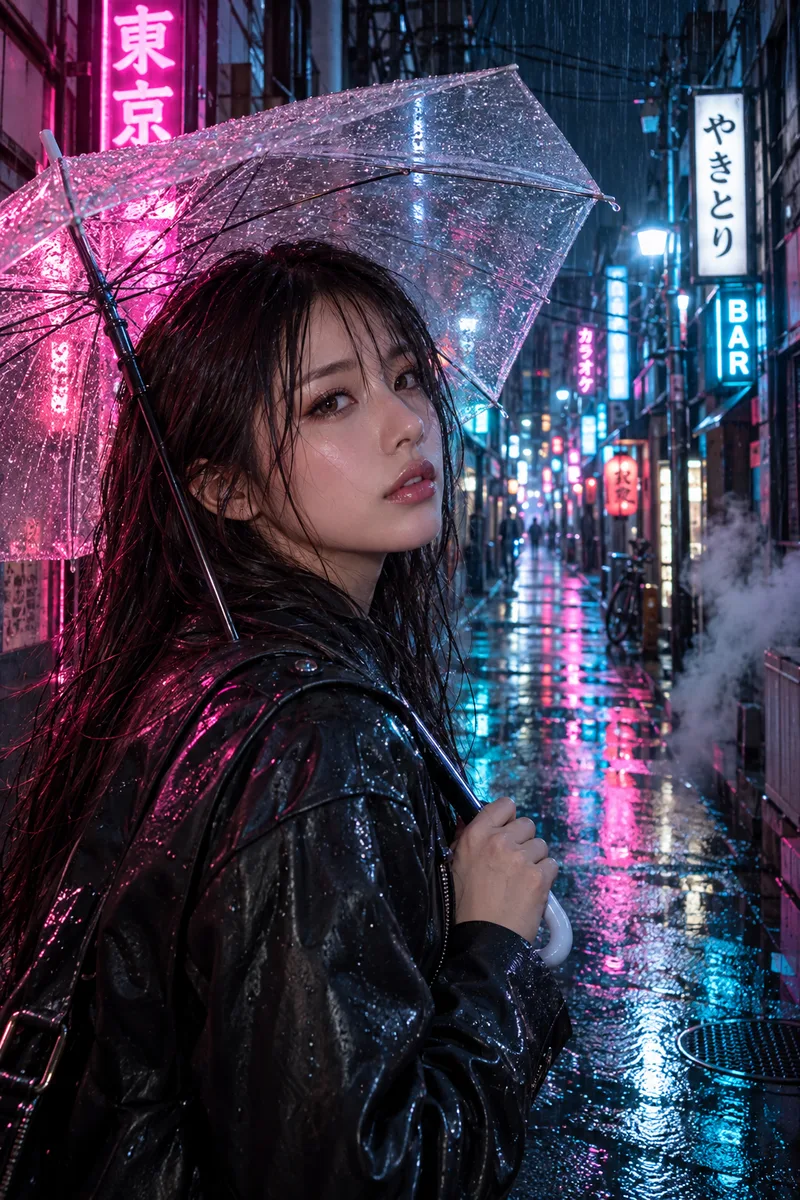
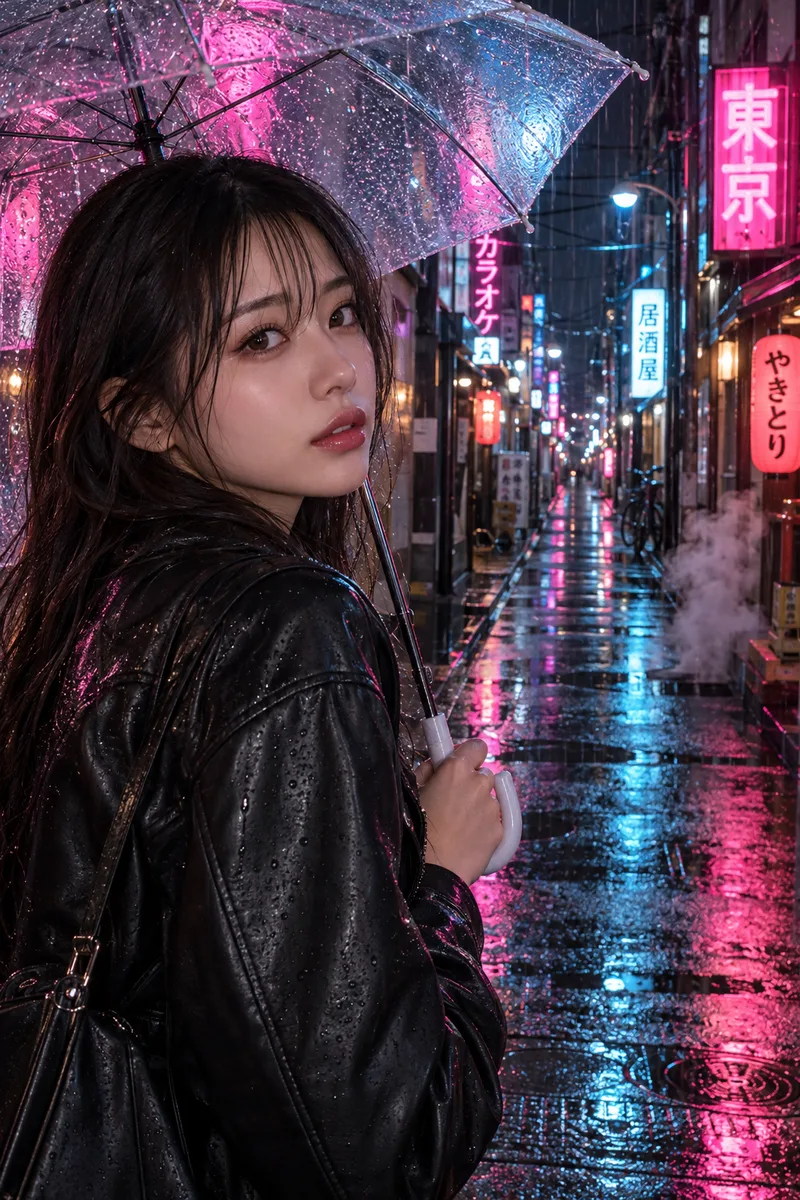
キタ!細い路地、路面のピンクと水色、湯気、透明のビニール傘、顔の青とマゼンタ。書いたものが4枚とも全部入っています。傘を持つ手も崩れていません。雰囲気の言葉だけでも夜にはなるけど、「この夜」を出したいなら書く。これがいちばん分かりやすく効いたコツでした。
コツ2:レンズの数字は、背景のぼけ方だけ変わる
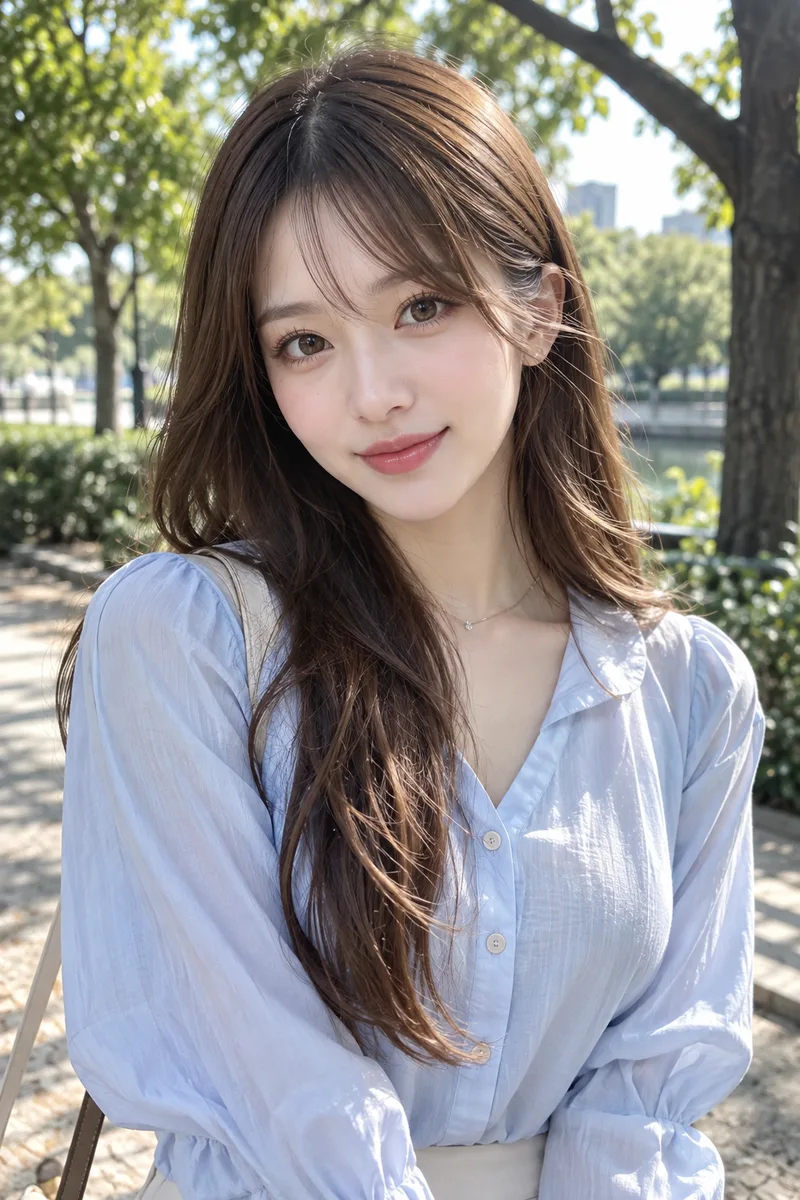
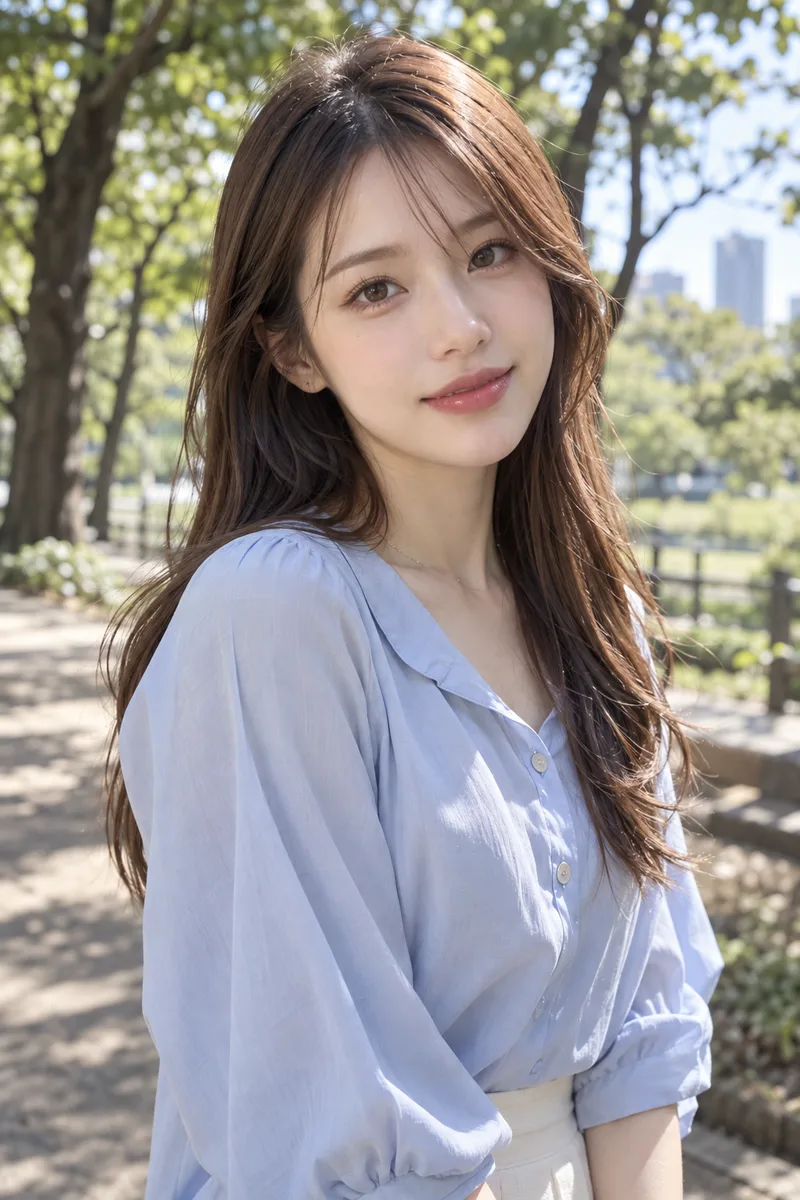
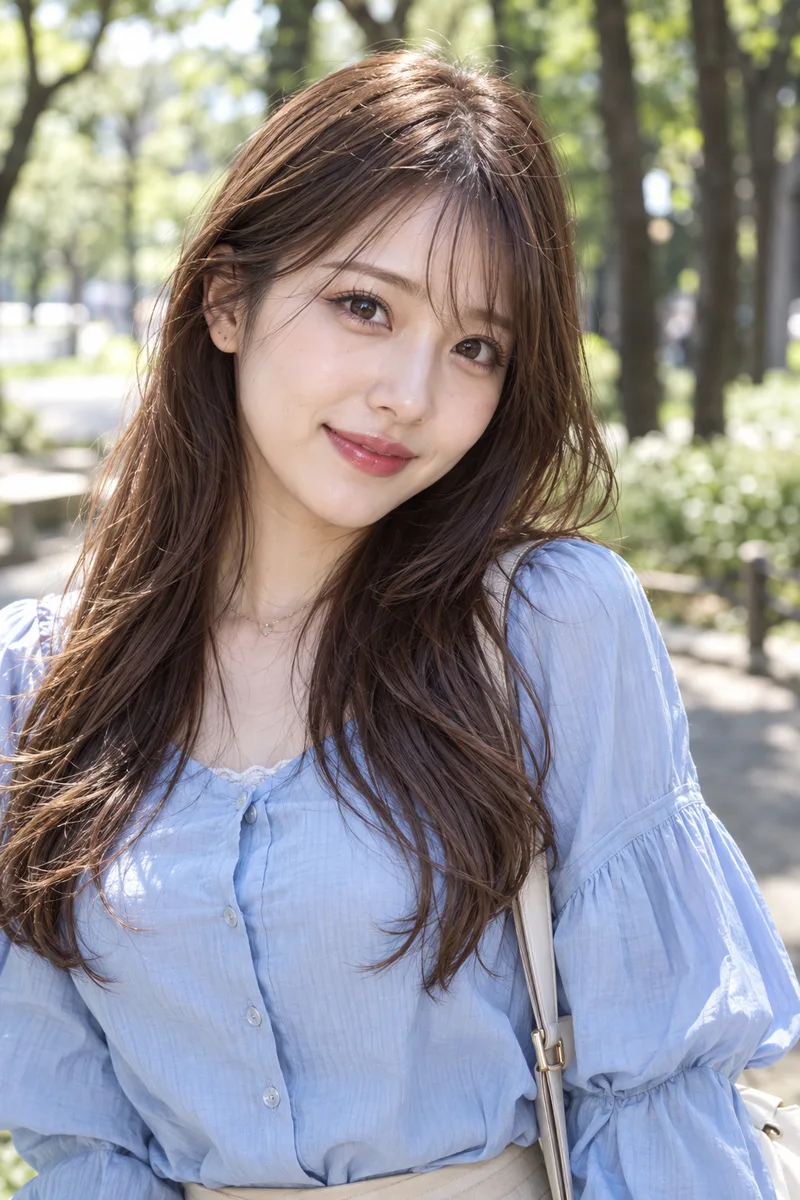
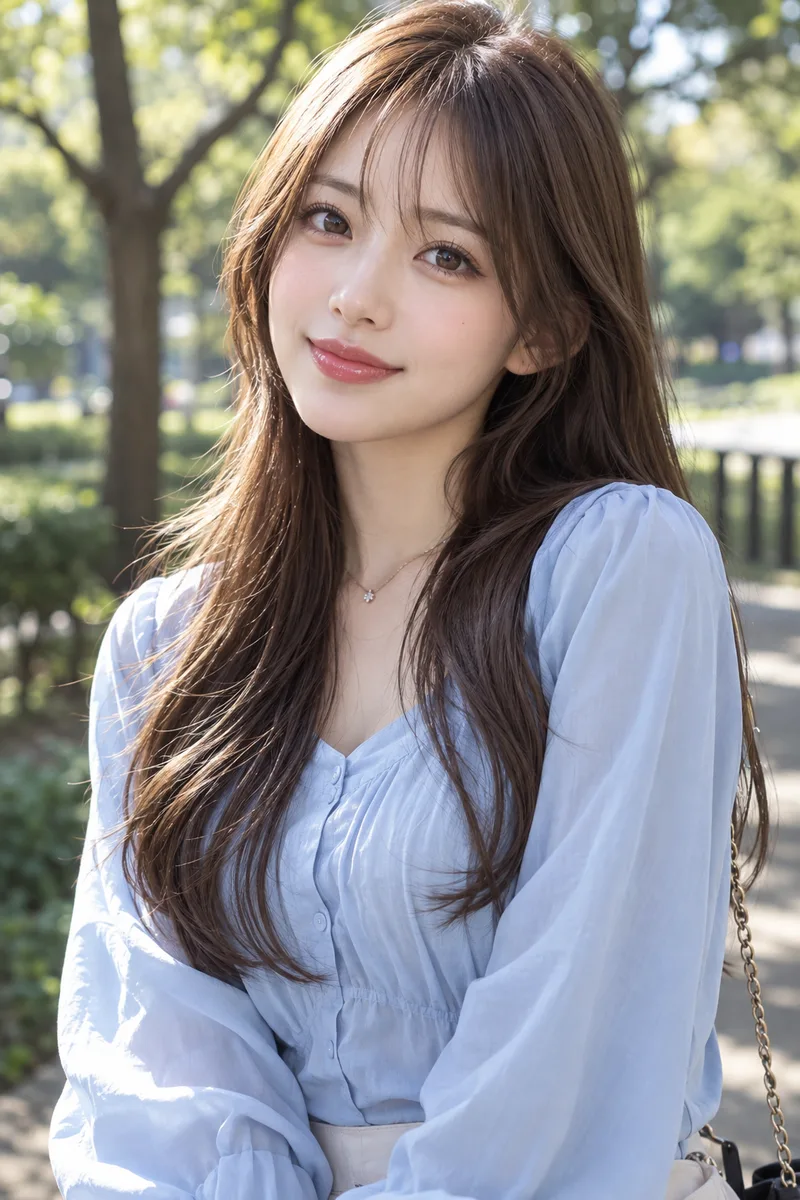
公式ガイドは、レンズのようなカメラの仕様は「見た目の手がかり」で、物理的に正確に再現されるわけではない、と書いています。公園で、35mm・50mm・85mm f/1.8 を書き分けました。
コツどおりshot on a 35mm lens
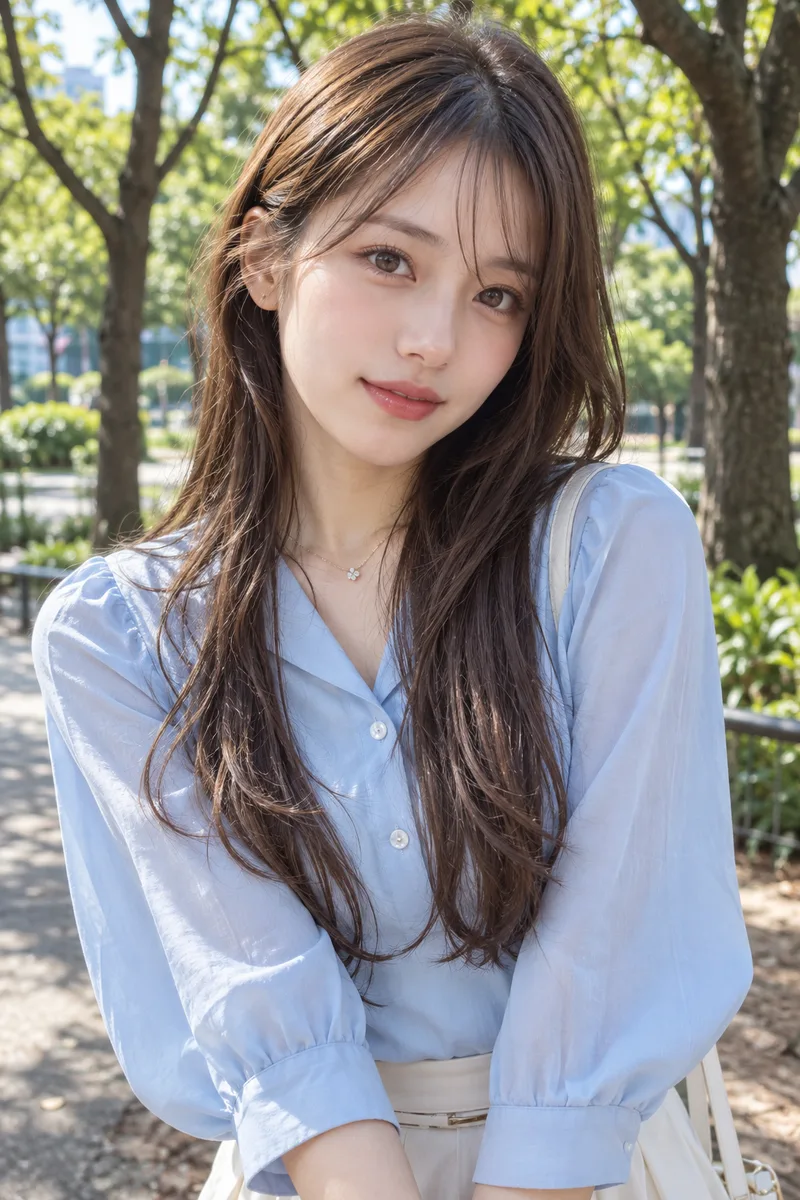
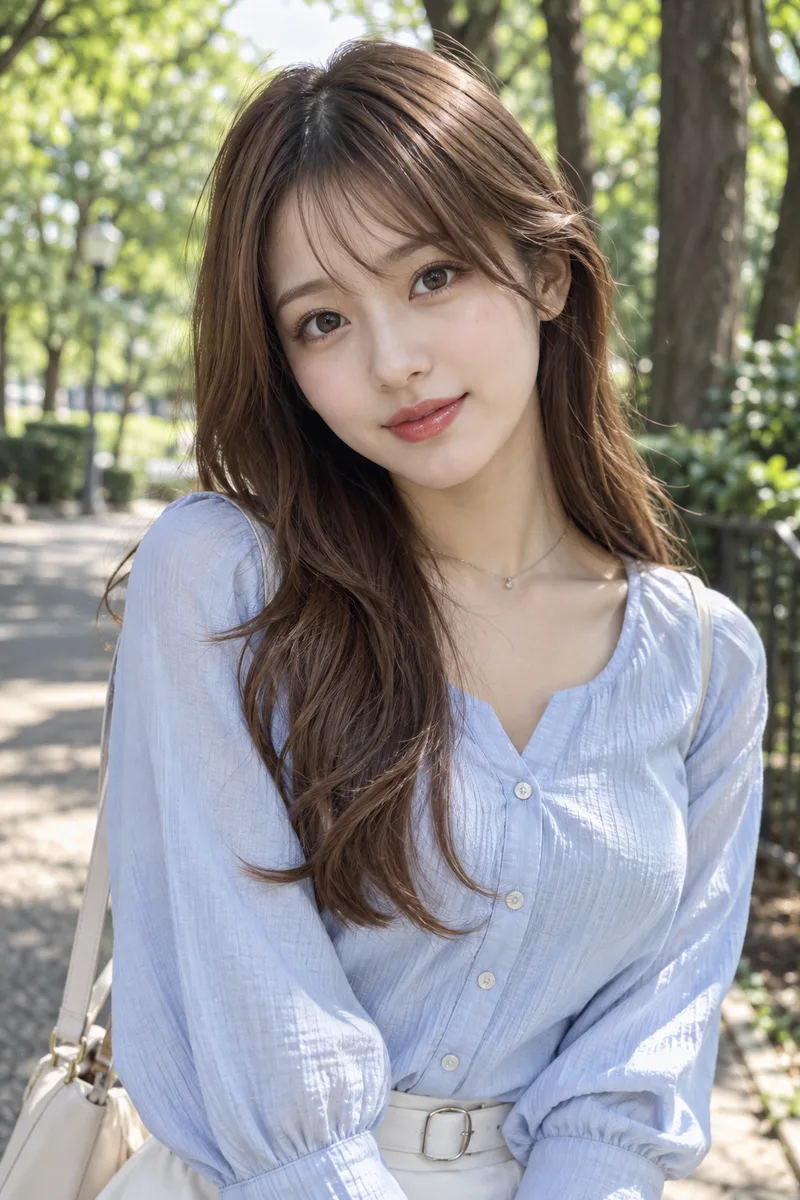
コツどおりshot on a 50mm lens
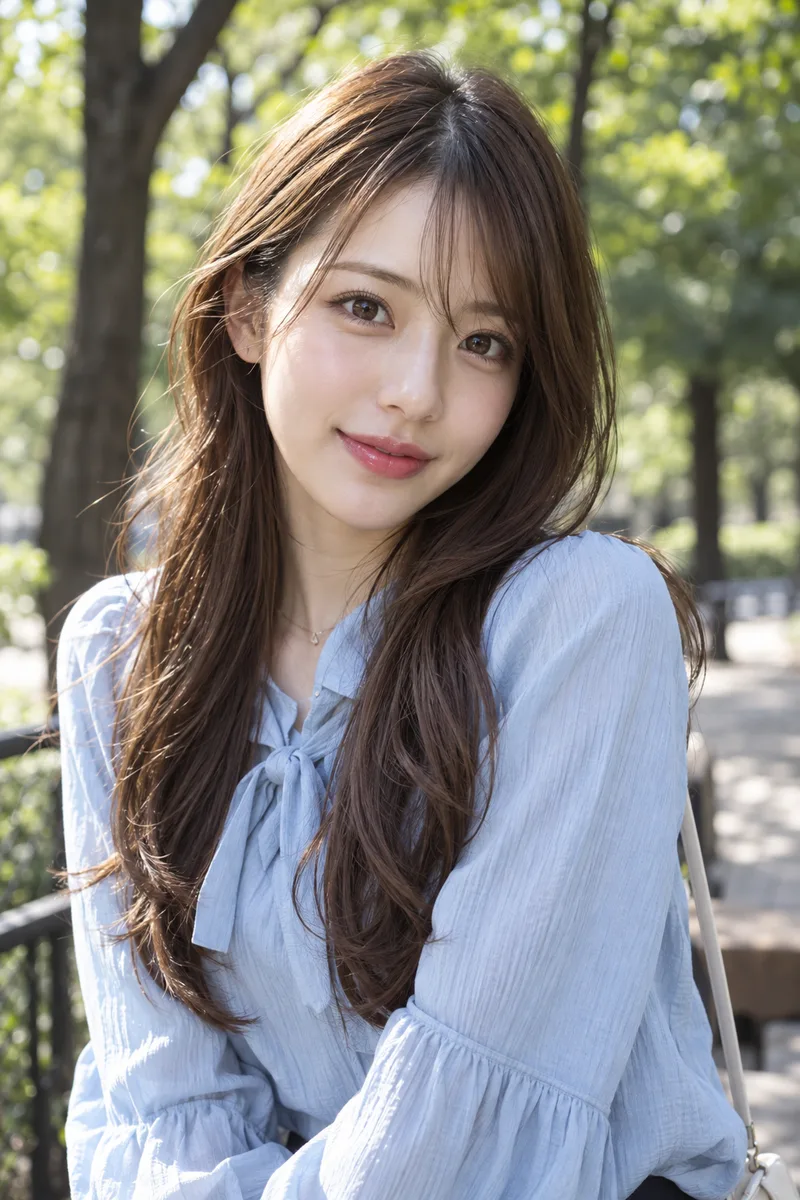
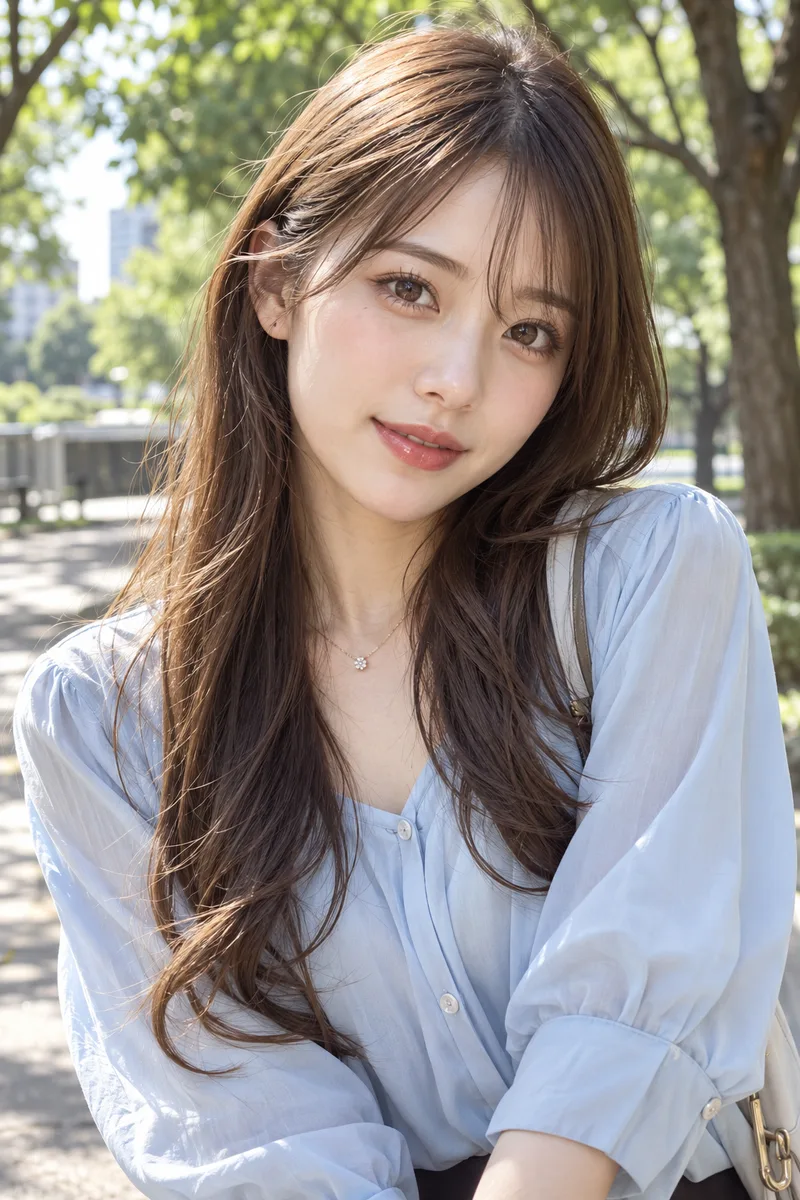
コツどおりshot on a 85mm f/1.8 lens
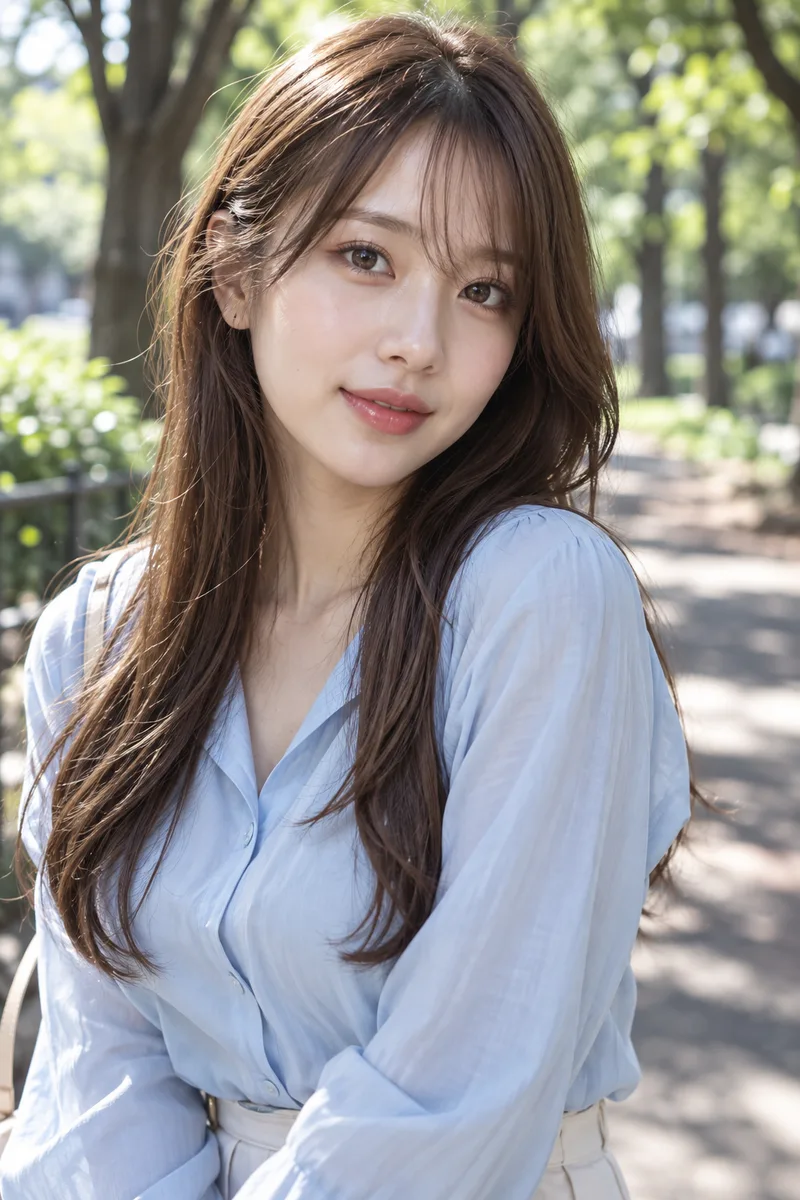
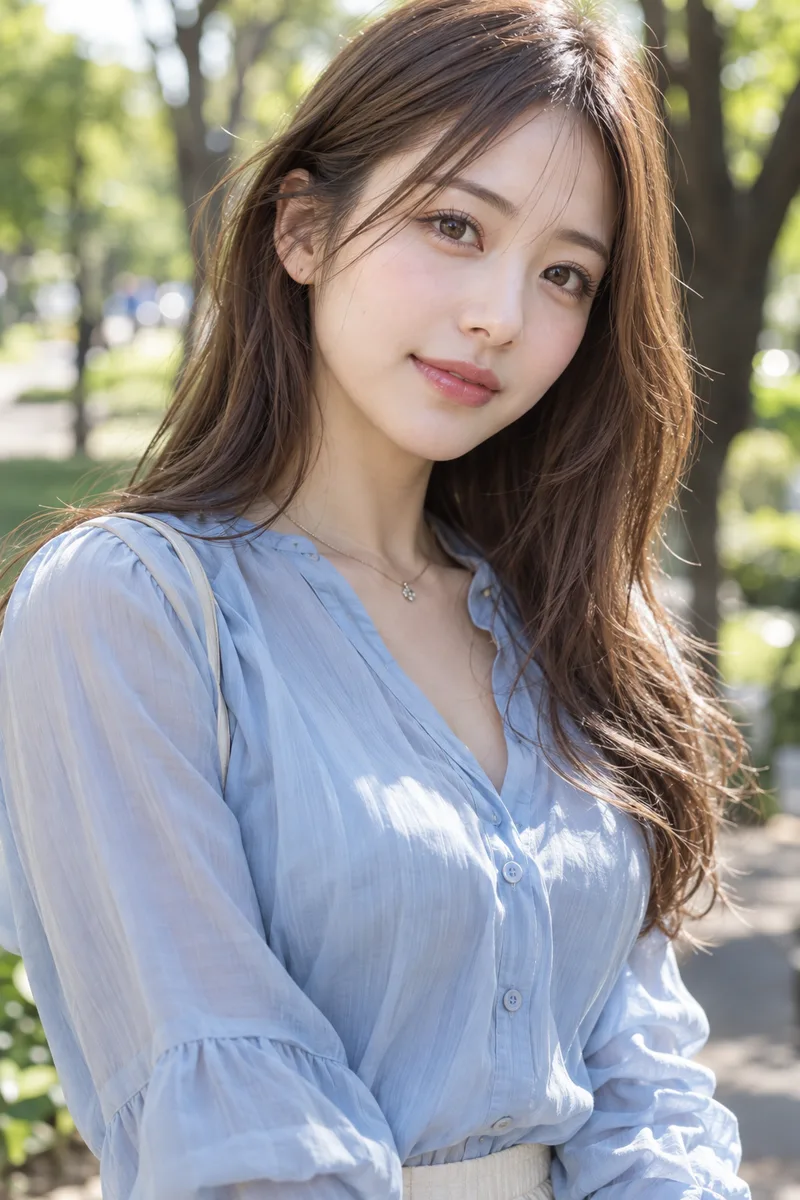
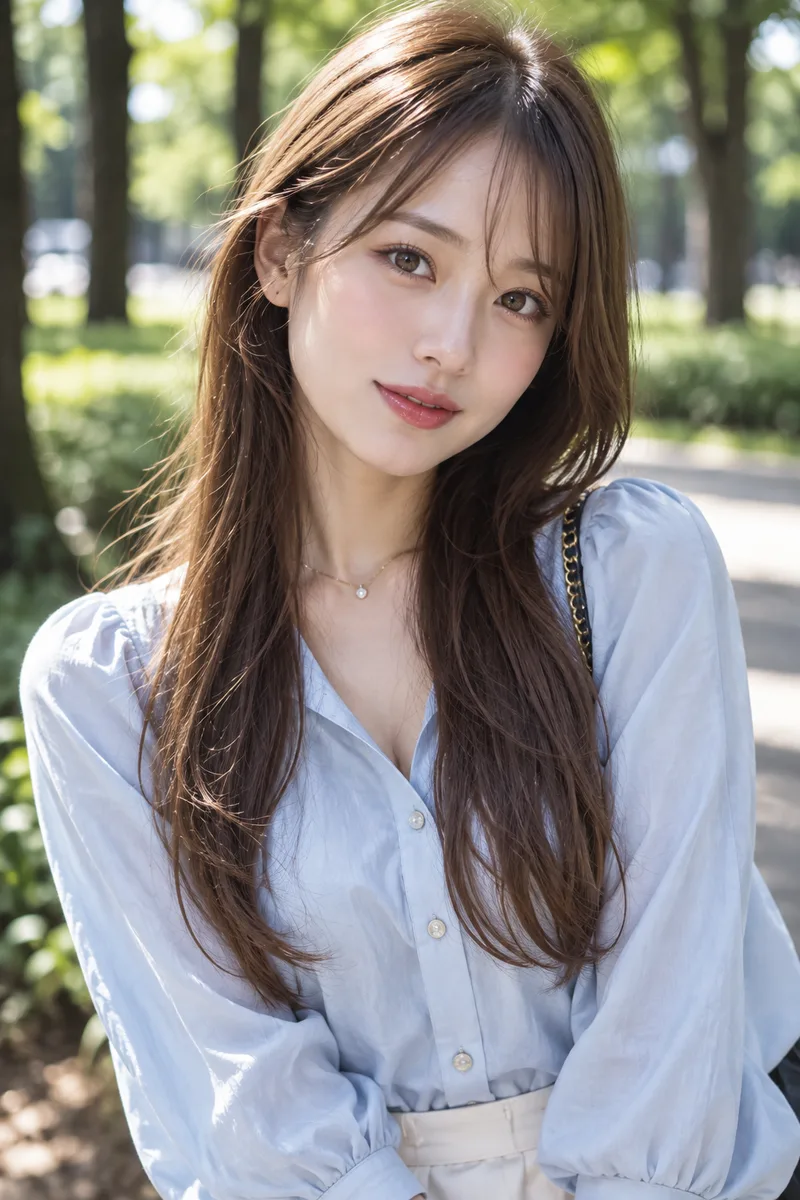
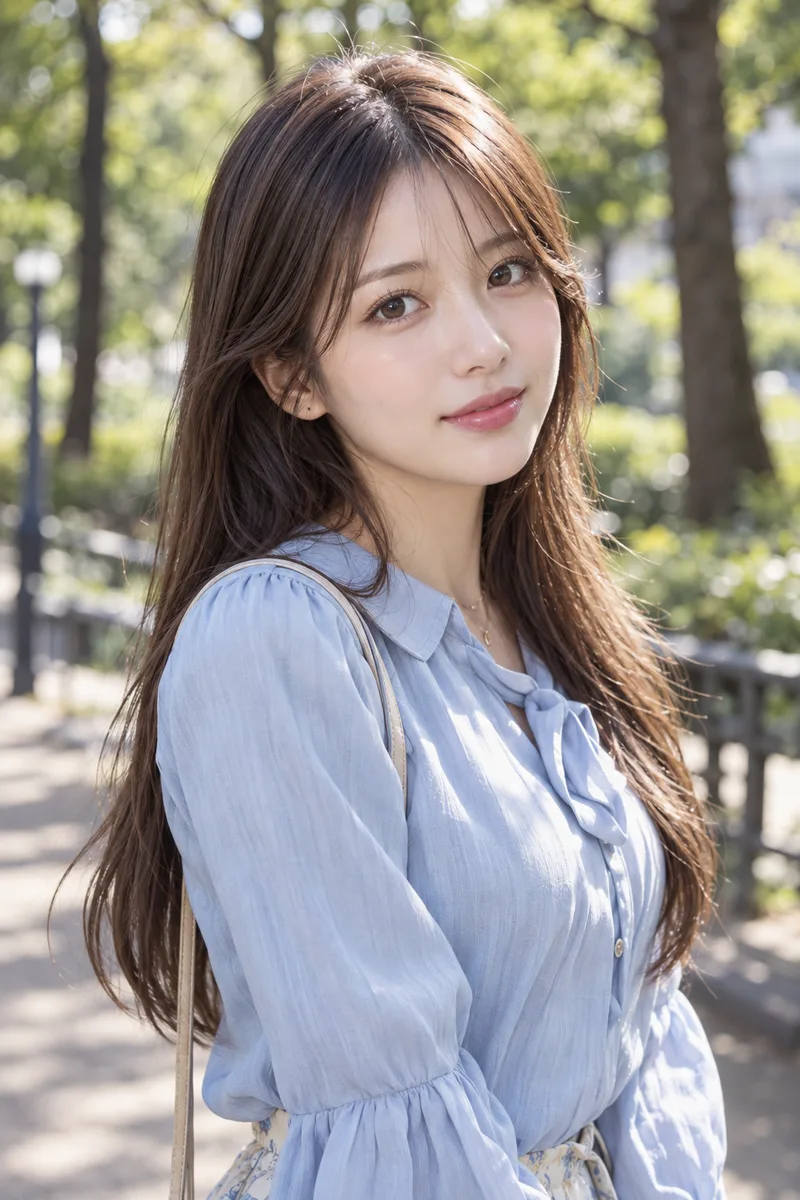
35mm は後ろの木と遠くのビルまではっきり写り、85mm f/1.8 は背景が大きくぼけて、木の形がほとんど溶けています。50mm はその間。顔の大きさ・服・構図は、3つともほぼ同じでした。
本物のカメラなら、35mm で同じ大きさに撮ると、近づくぶん顔がゆがんで背景も広く入ります。そこまでは再現されず、変わるのはぼけ方だけ。ガイドの言う「見た目の手がかり」は、まさにこれでした。背景をぼかしたいときは、85mm f/1.8 と書くのがいちばん手軽です。
コツ3:見出しで区切ると、「文字なし」が守られた
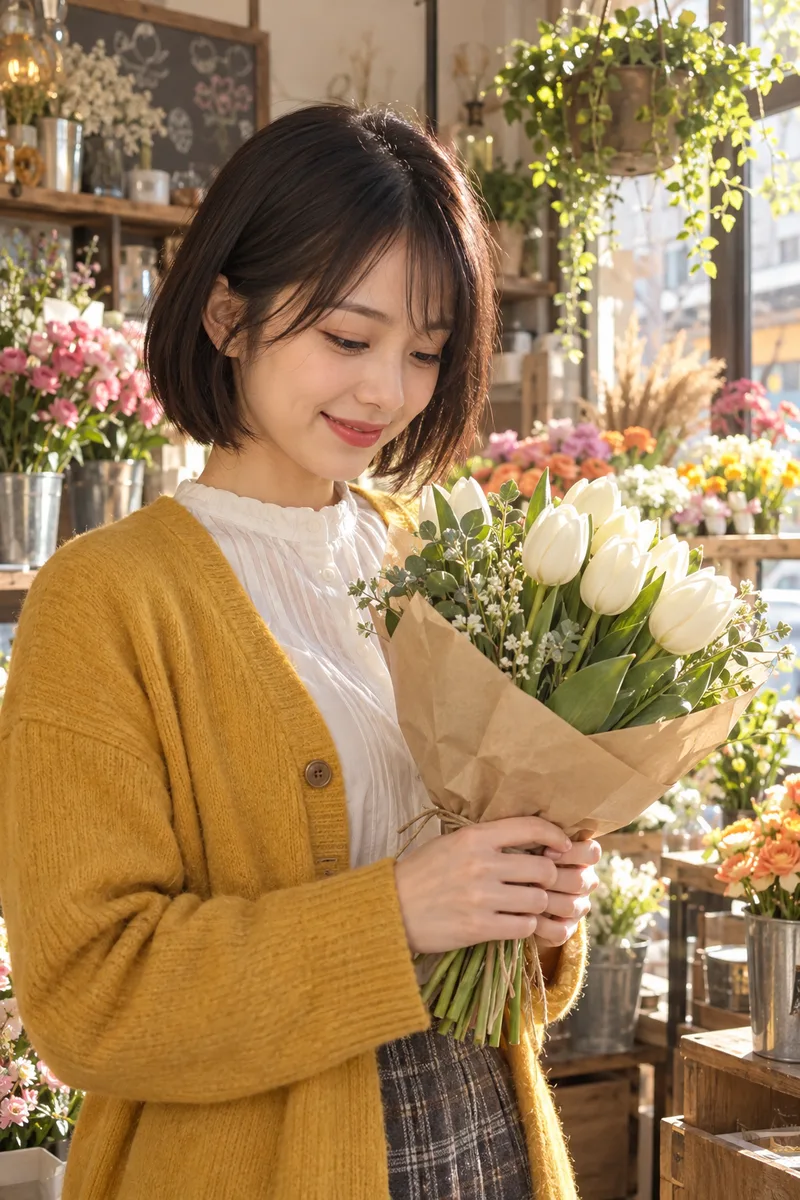
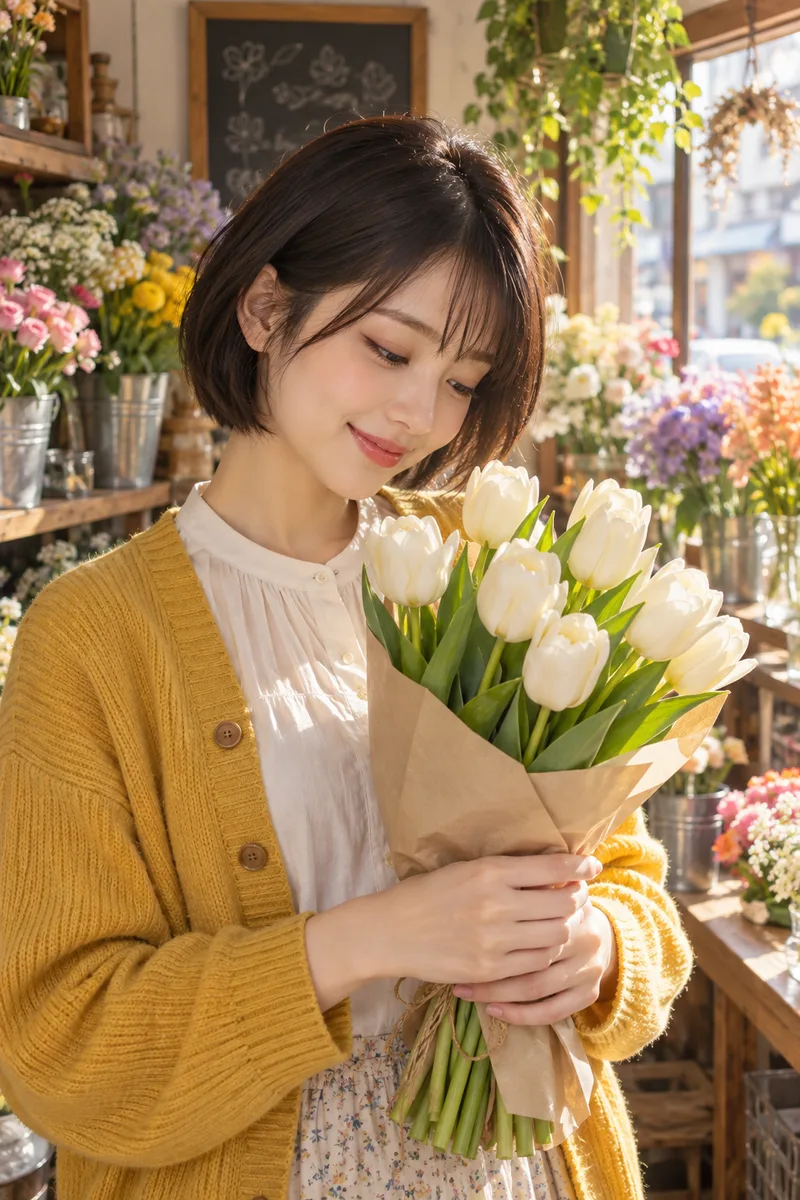
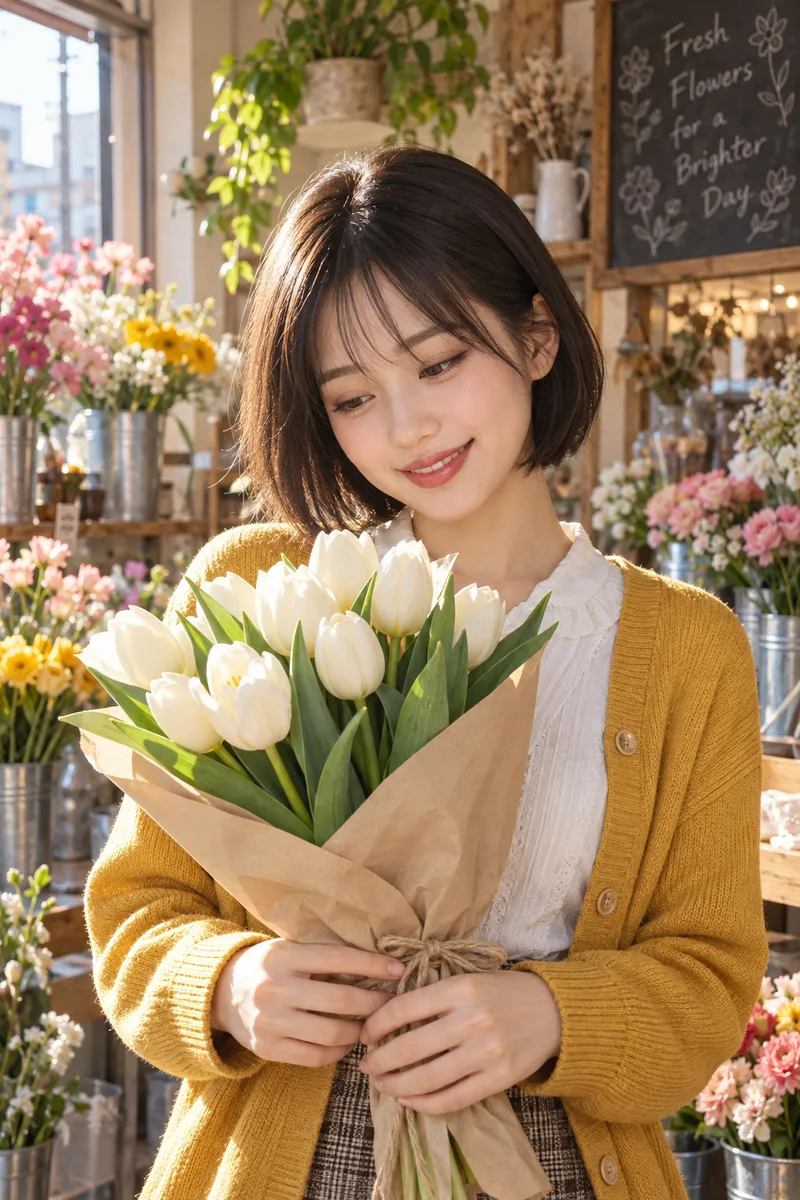
公式ガイドは、込み入った頼みごとは、1つの長い段落ではなく、場面(Scene)・人物(Subject)・細部(Details)・制約(Constraints)の見出しで区切って書くように勧めています。花屋の場面を、同じ中身で2通りに書きました。
書かなかった1つの段落で書いた(全文は下の枠)
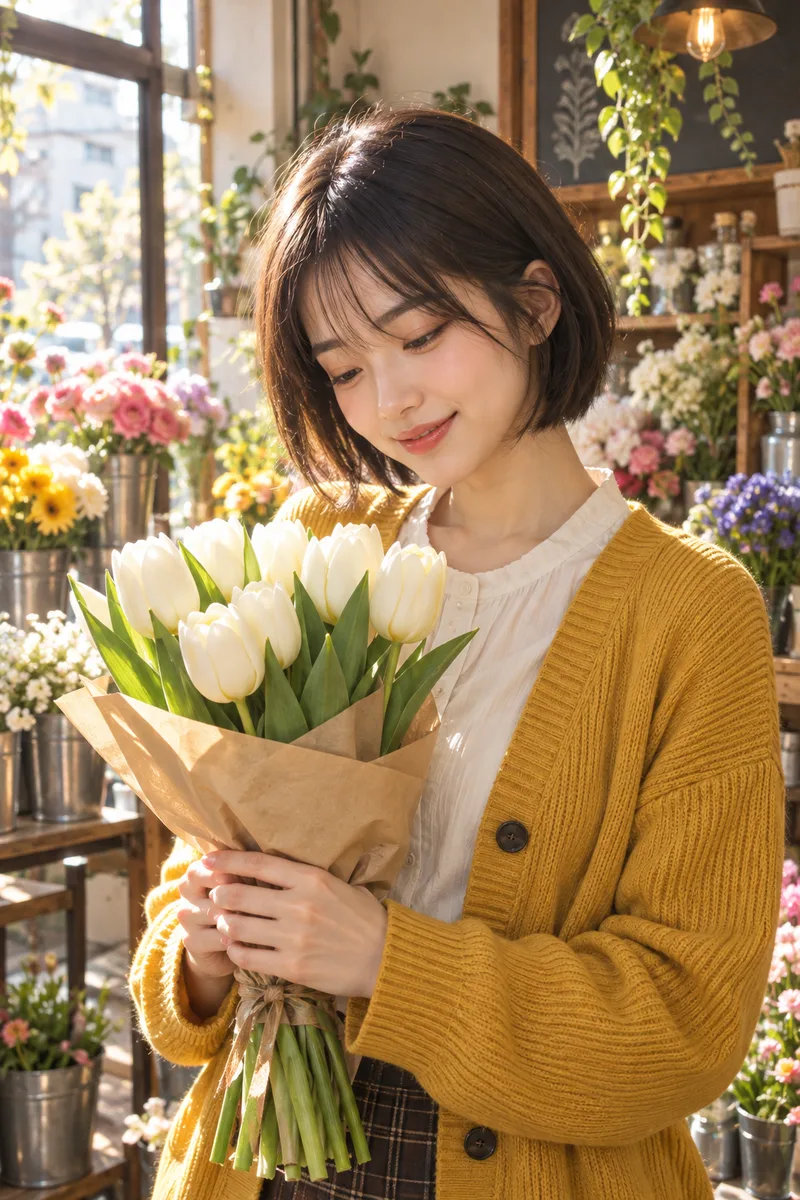
コツどおり見出しで区切って書いた(全文は下の枠)
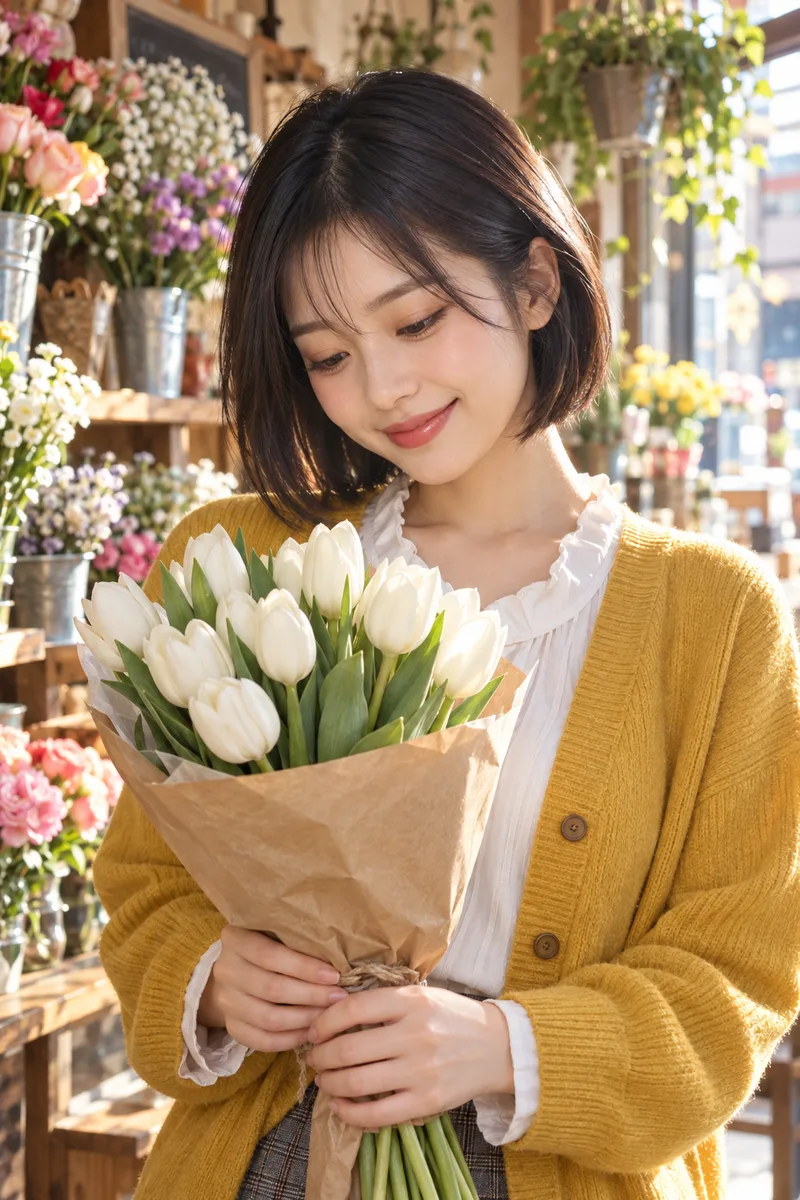
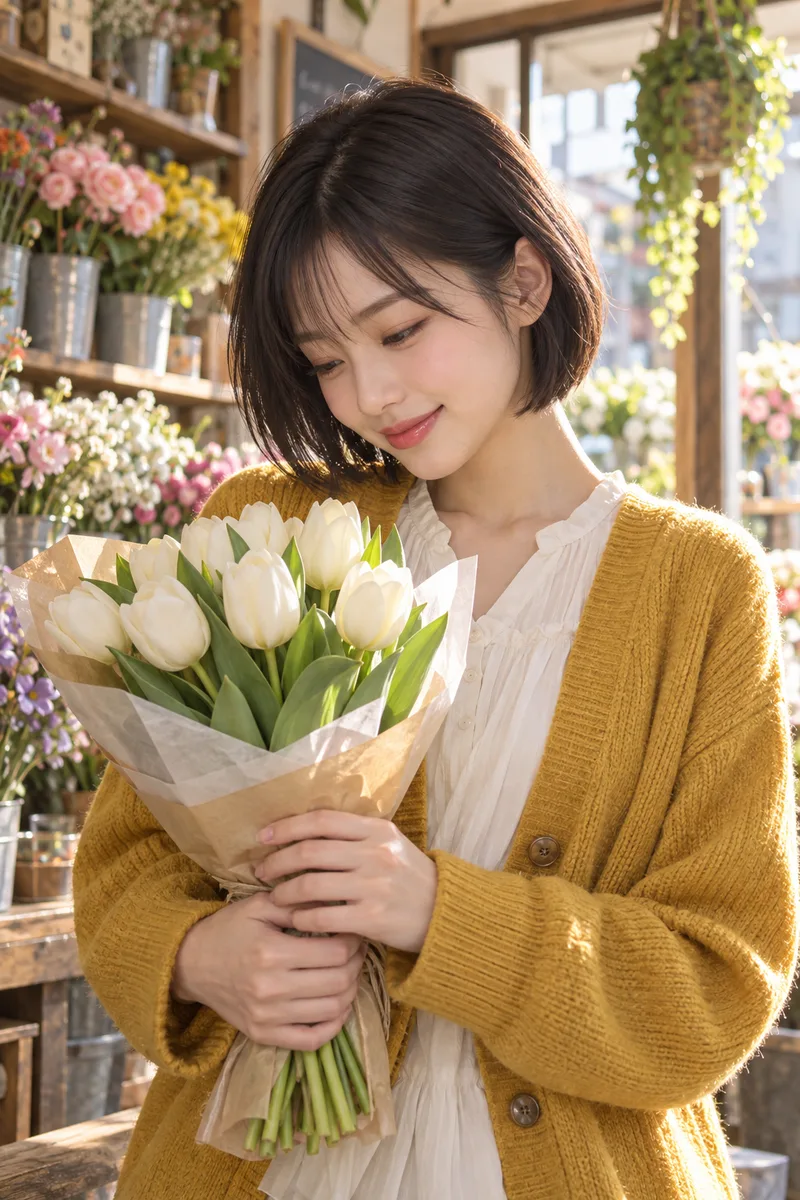
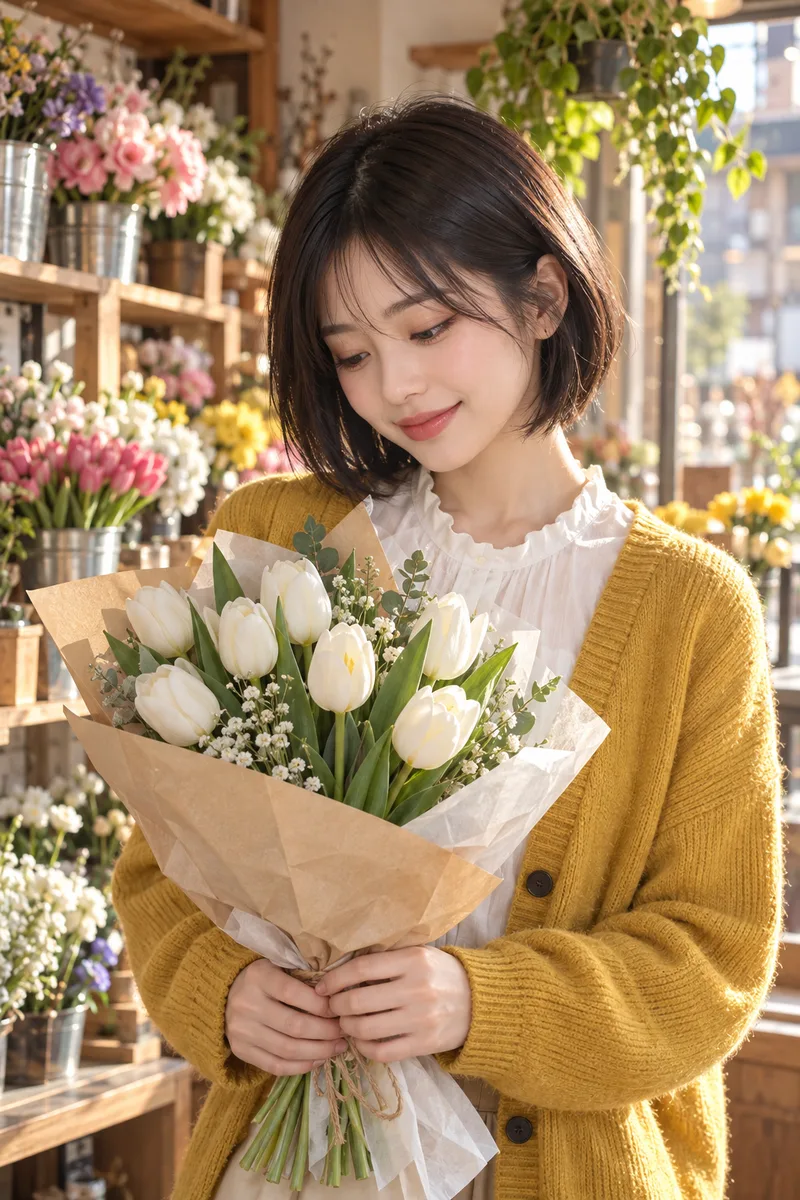
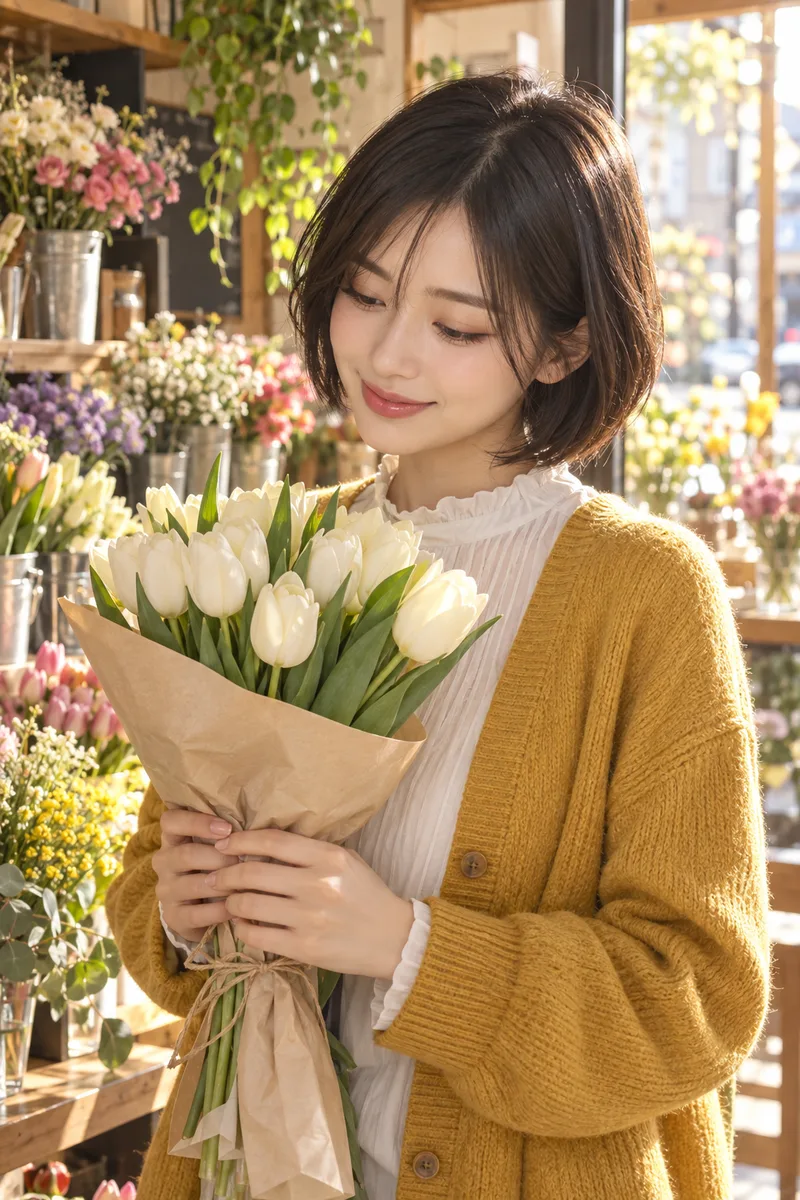
Subject: a beautiful 20-year-old Japanese woman, stylish Tokyo fashion model look, small refined face, defined eyes with soft brown eyeliner, glossy rose lips, with a short black bob, wearing a mustard yellow cardigan over a white blouse.
Details: she holds a bouquet of white tulips with both hands, smiles softly and looks at the bouquet, waist-up shot, photorealistic photograph.
黒髪のボブ・からし色のカーディガン・白いブラウス・白いチューリップを両手で・木の棚の花・黒板・つるした緑・窓の光・花束を見て微笑む・腰から上。書いた10個は、どちらの書き方でも4枚とも全部出ました。中身の伝わり方は、まったく同じです。
差が出たのは、最後の「文字なし(no text)」でした。1段落のほうは、4枚目の黒板に英語の一文が書かれています。見出しのほうは、黒板がほとんど写らず、文字は0枚。黒板(chalkboard sign)と文字なし、という少し矛盾した頼みごとで、見出しのほうが制約を守ってくれた、という結果です。4枚中1枚の差なので、毎回そうなるとは言い切れませんけど。
コツ4:photorealistic は、書いても書かなくても写真だった
公式ガイドには、写真らしくしたいときは photorealistic と書く、とあります。街の歩道で、書かない4枚と書いた4枚を作りました。
書かなかった書かなかった:A beautiful 20-year-old Japanese woman, …
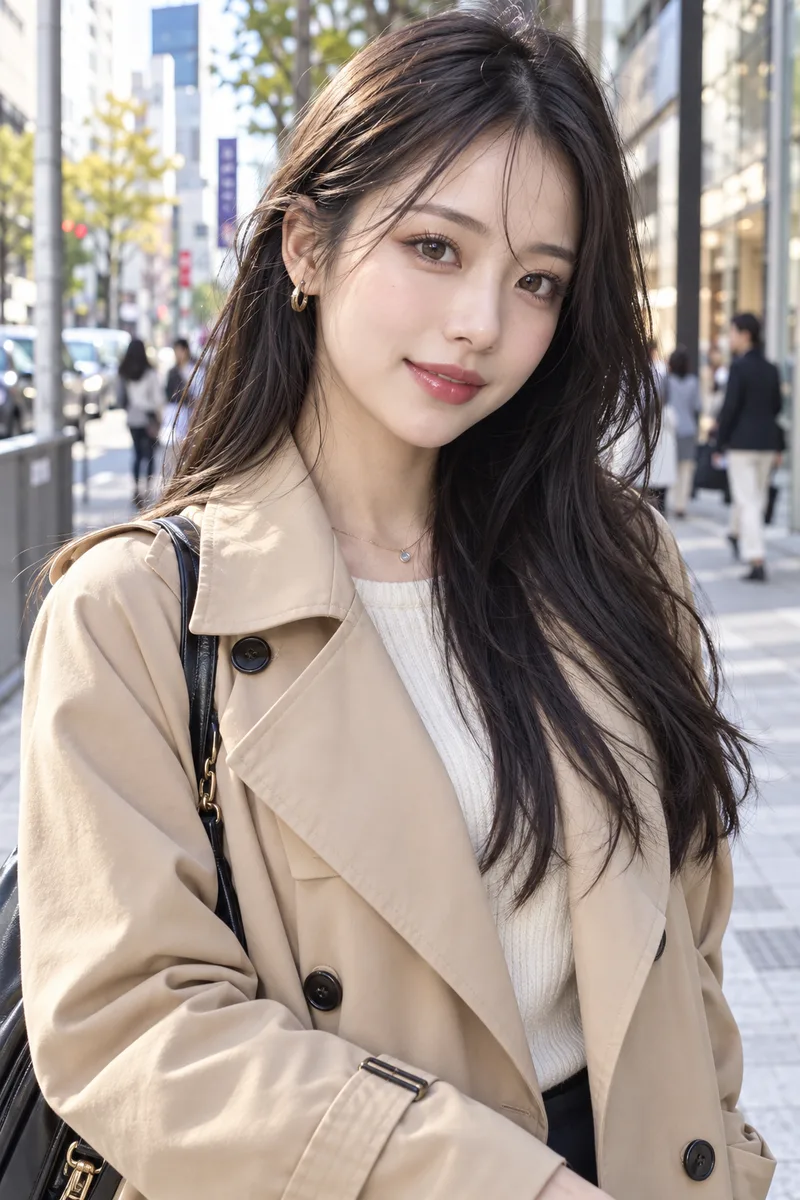
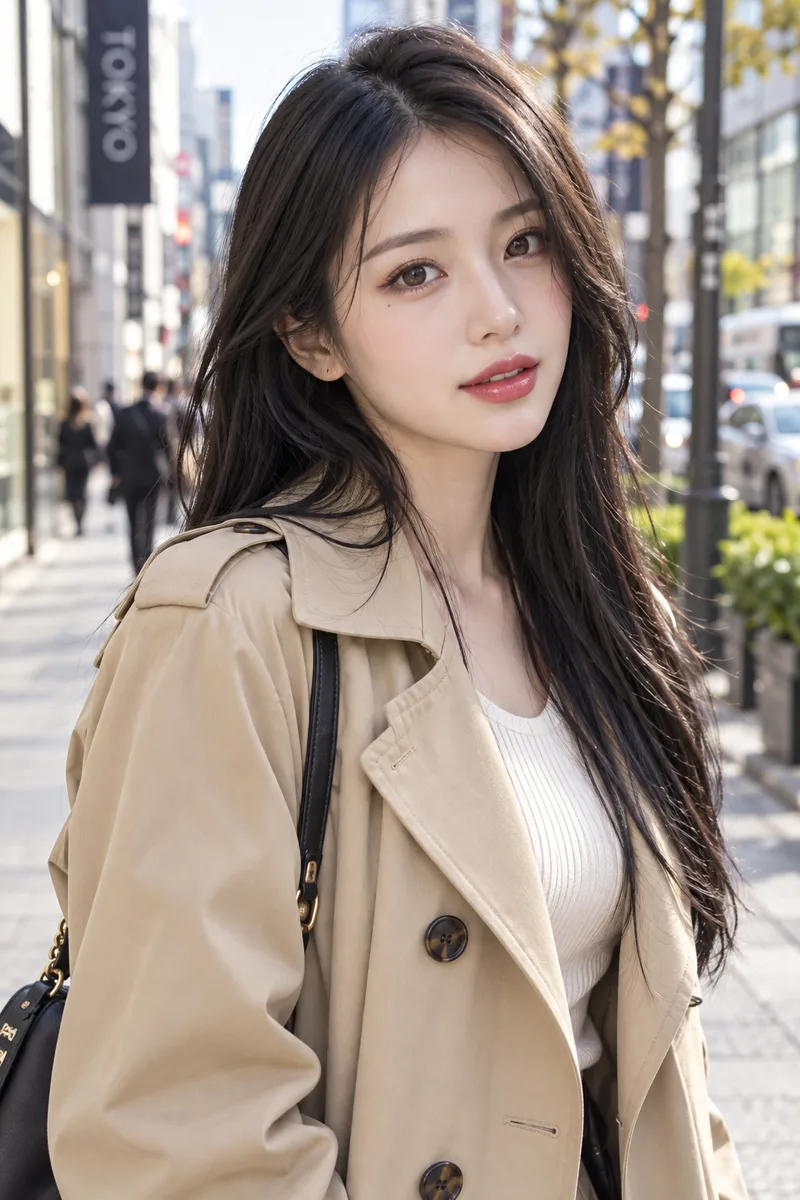
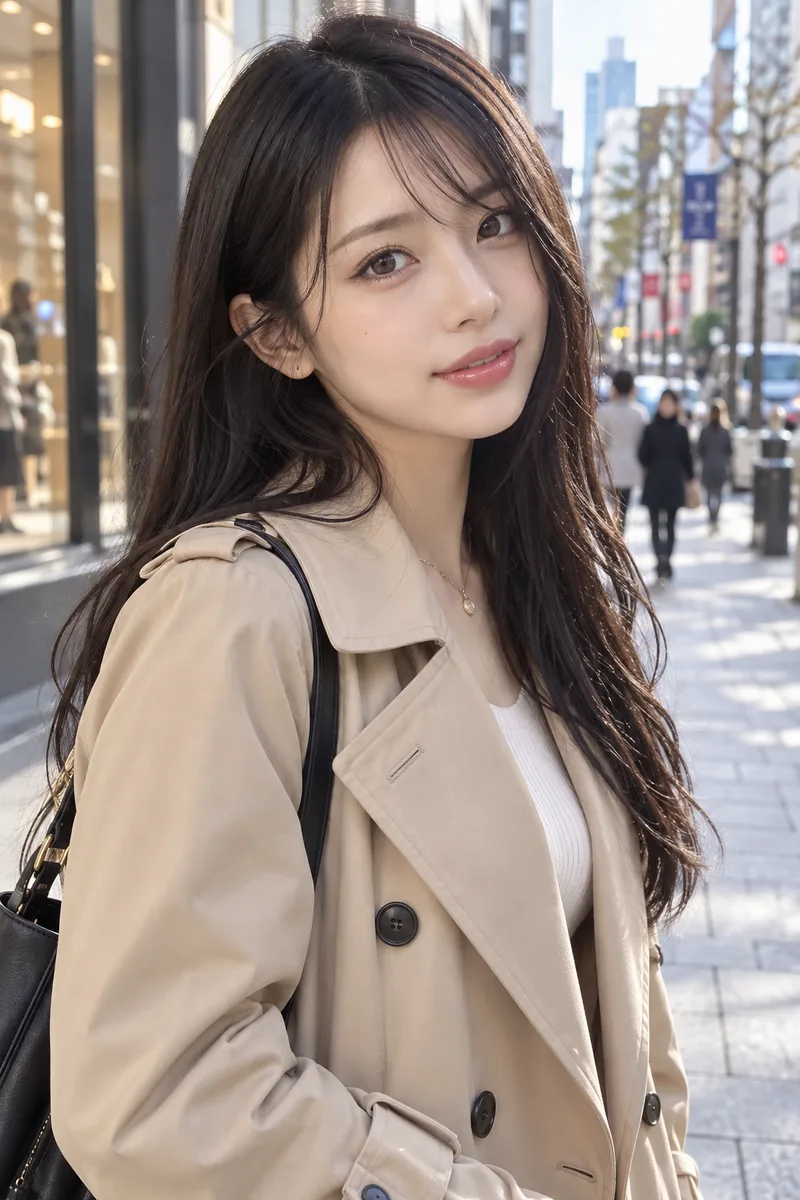
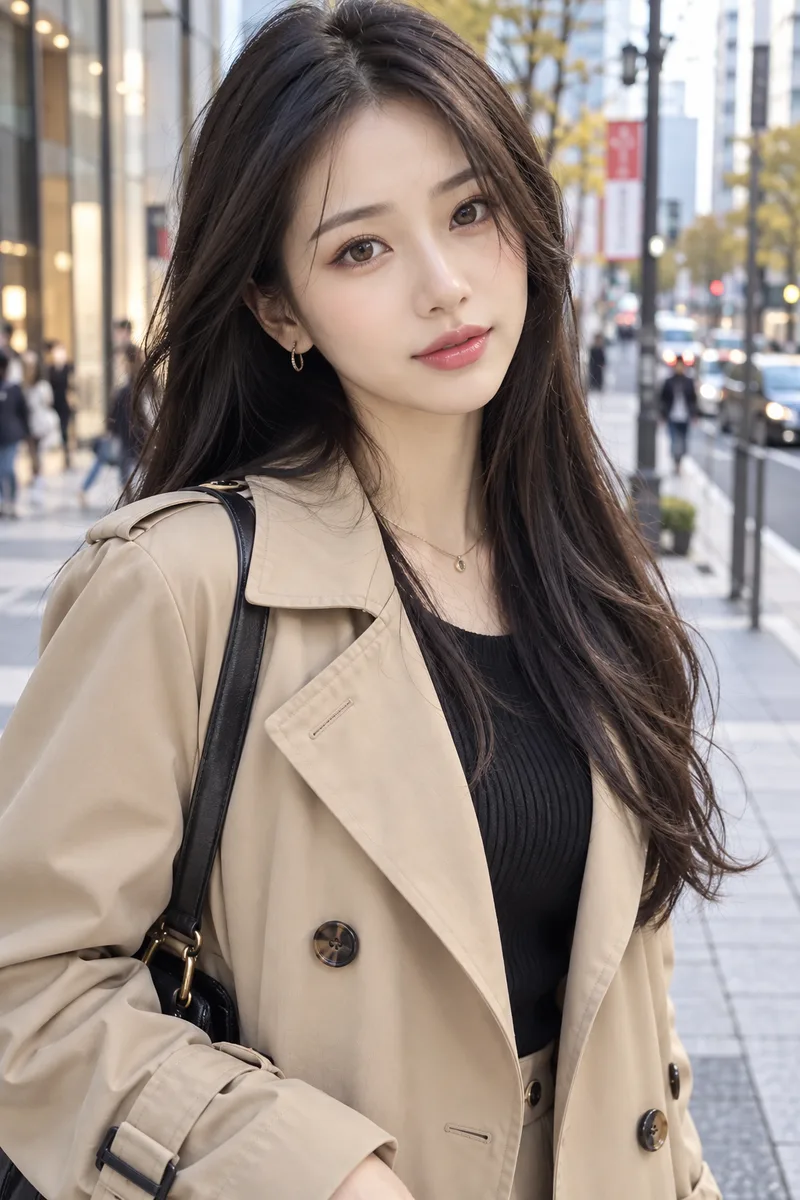
コツどおり書いた:Photorealistic photograph of …
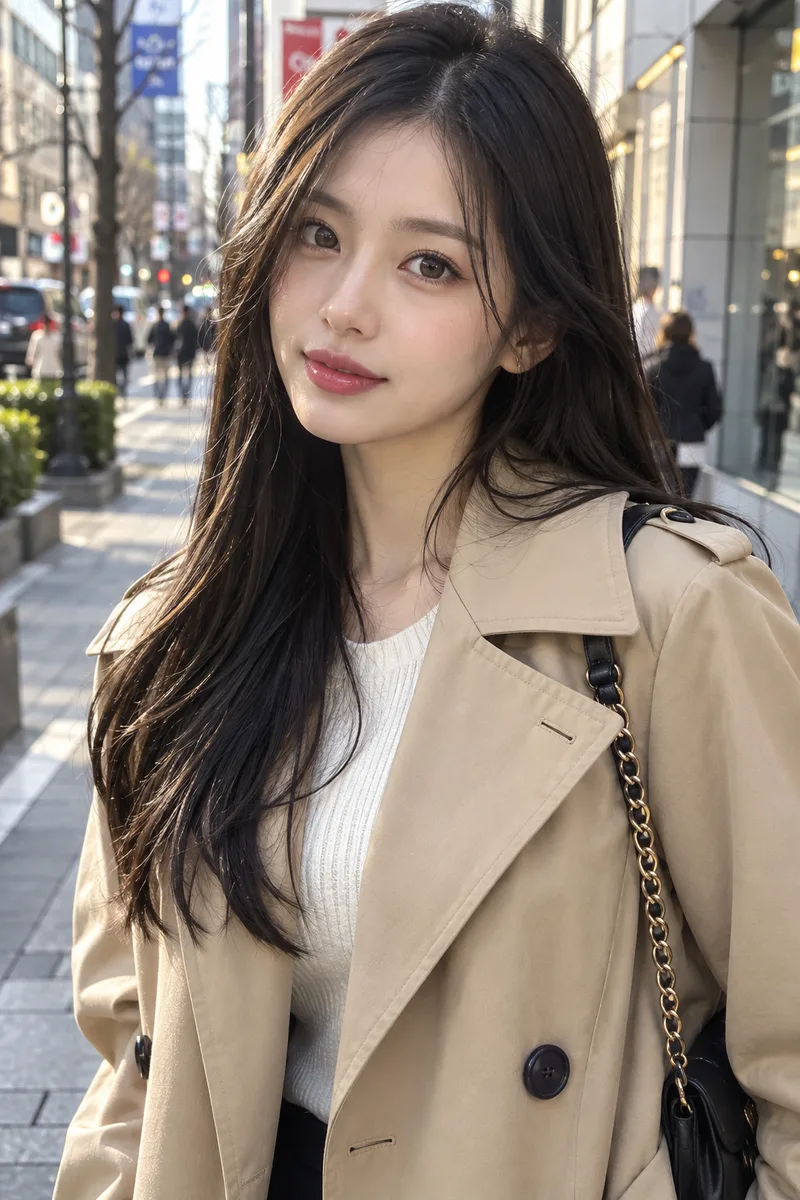
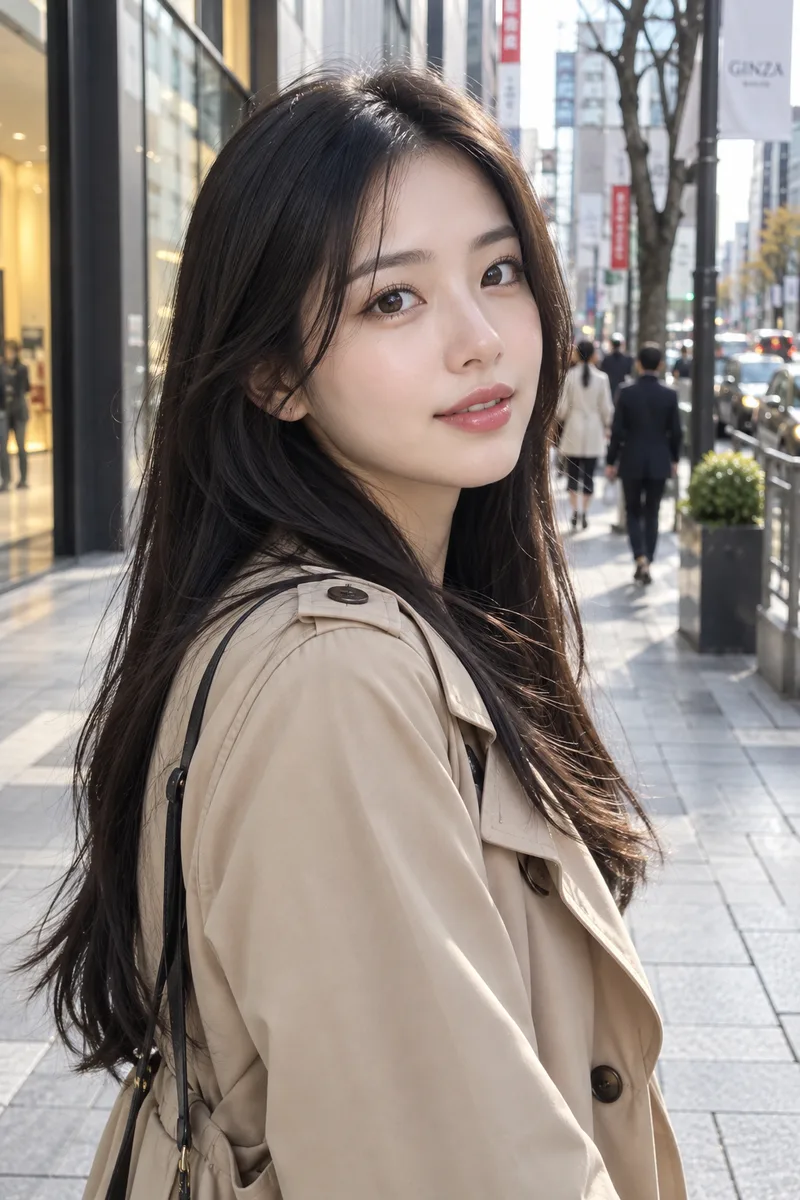
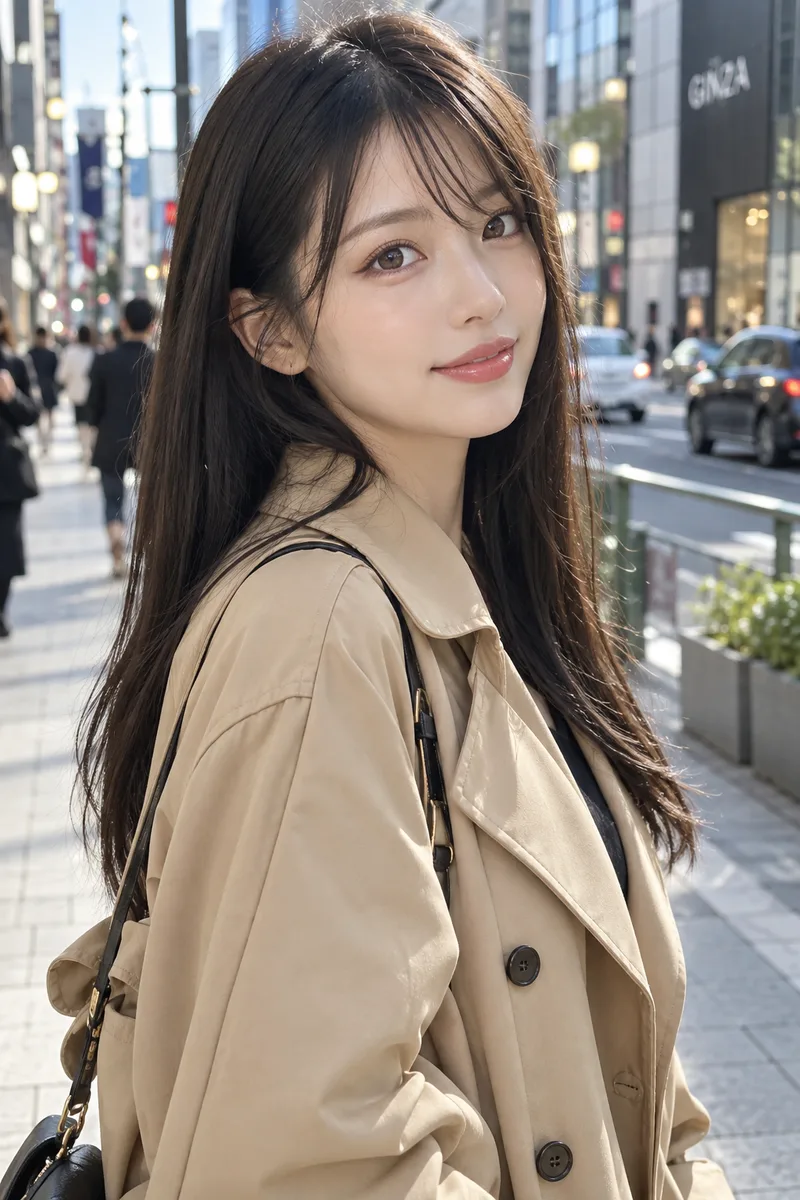
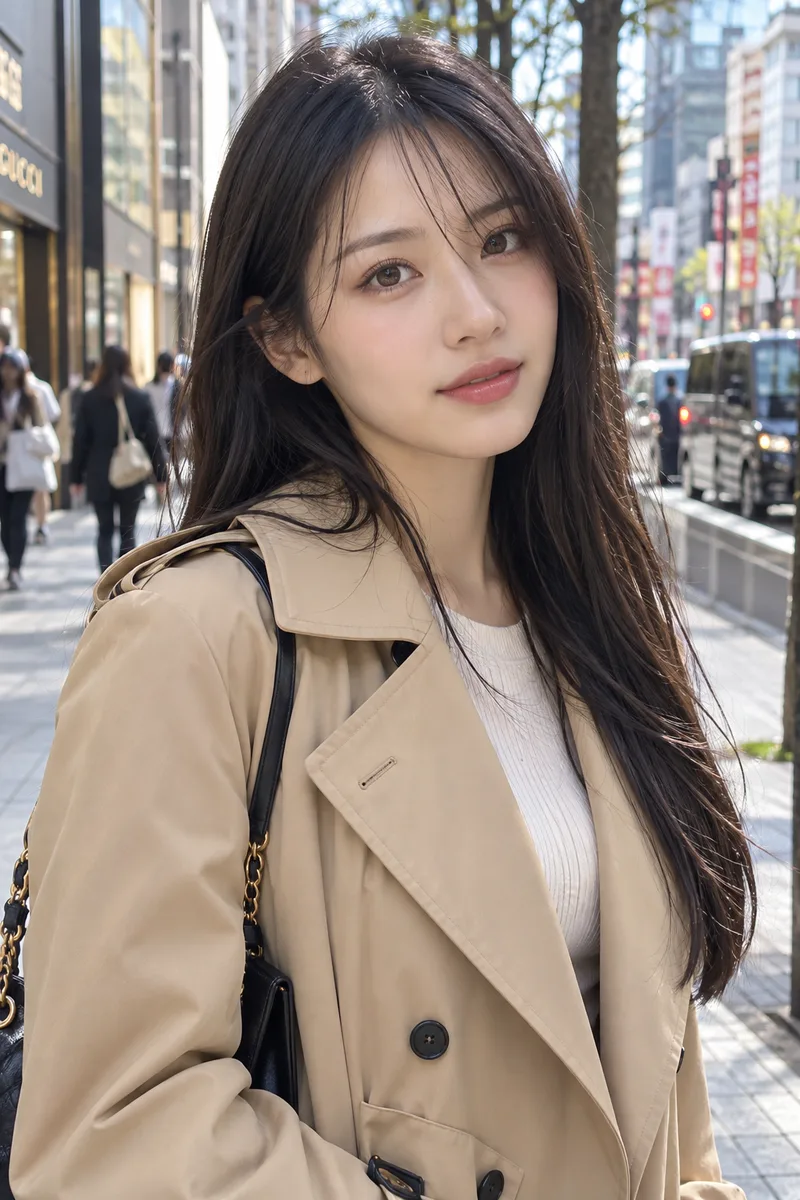
……並べても、ほぼ同じ。書かなかった4枚も、ちゃんと写真です。書いたほうが背景のぼけが少し深い気もしますが、言われなければ分かりません。今の ChatGPT は、人物を頼むと最初から写真で返すので、photorealistic は「イラストに寄ったときの保険」くらいでよさそうです。
ちなみに、書いたほうの4枚目の背景には、実在の高級ブランドの看板が写っていました。街の場面は、実在の店の看板が写り込みやすいので、使う前に背景も見ておくと安心です。
コツ5:全身は、full body だけで足先まで入った
公式ガイドは、人物は体のどこまで写すかを書くように勧めていて、例に「full body visible, feet included(全身が見えて、足も入る)」が挙がっています。赤いスニーカーで横断歩道を歩く全身で比べました。
書かなかったfull body だけ
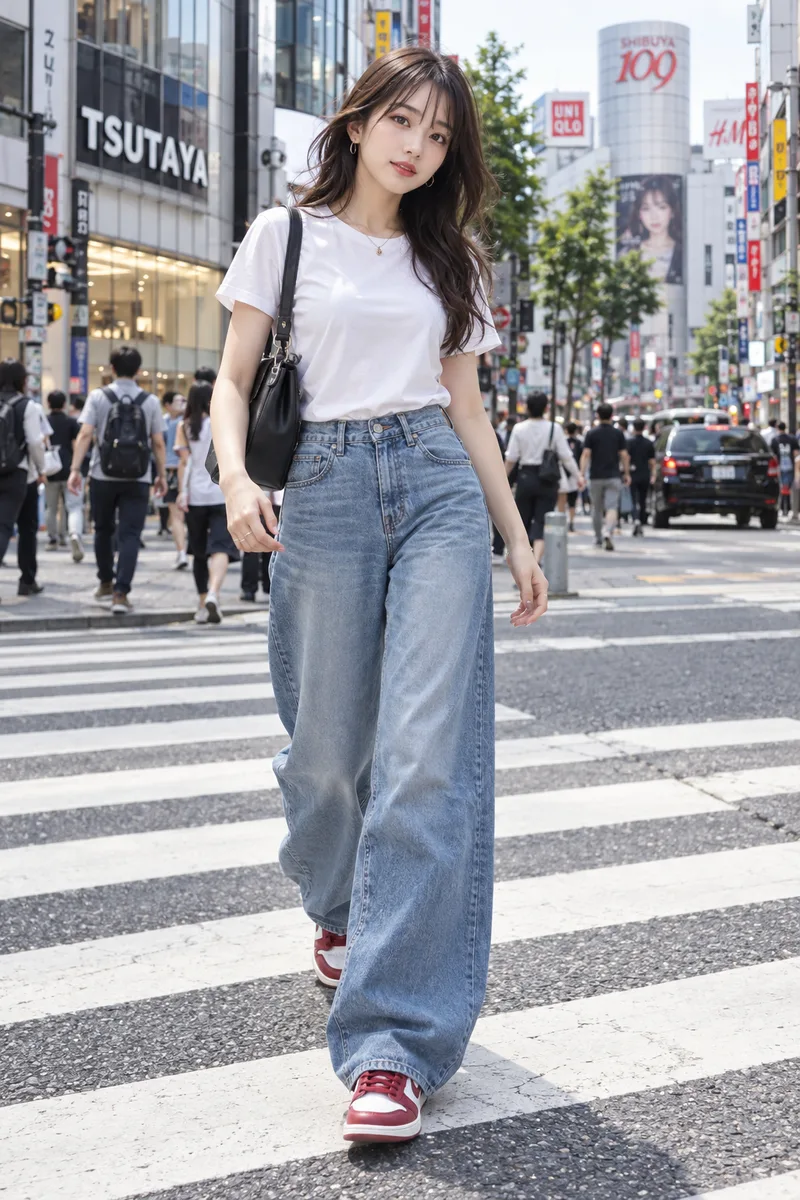
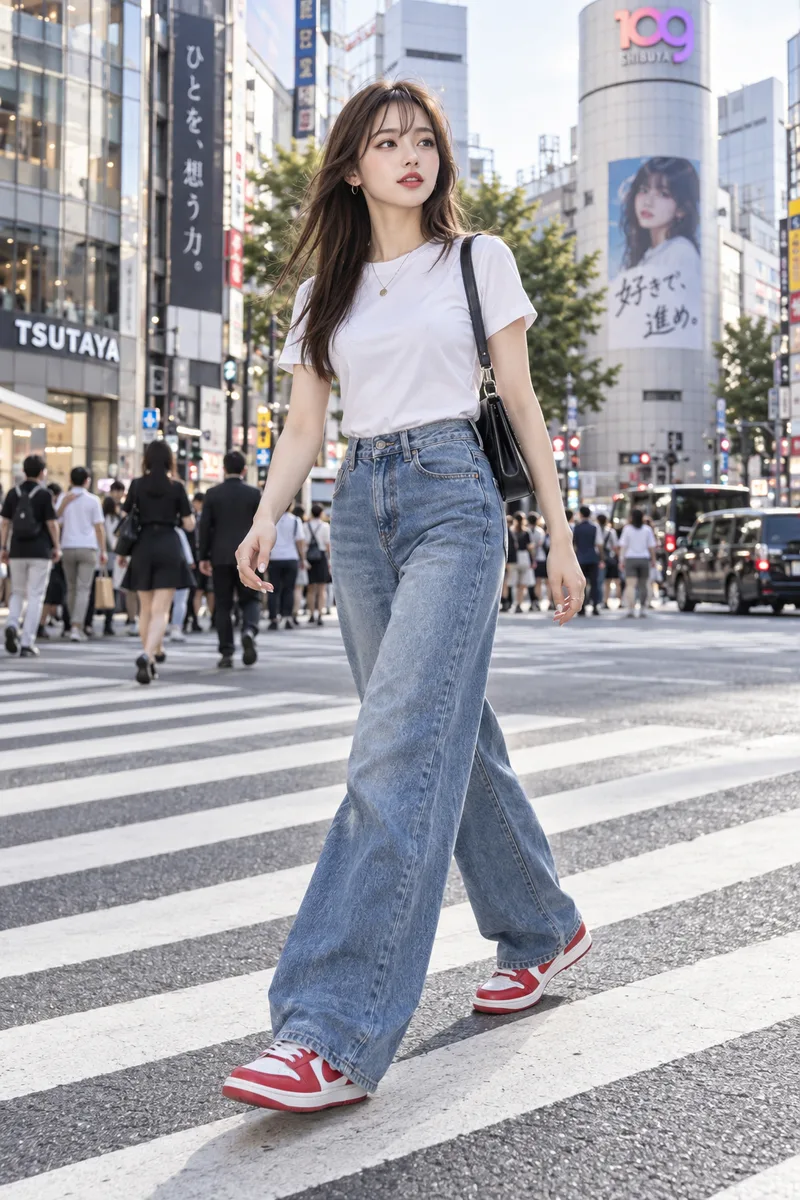
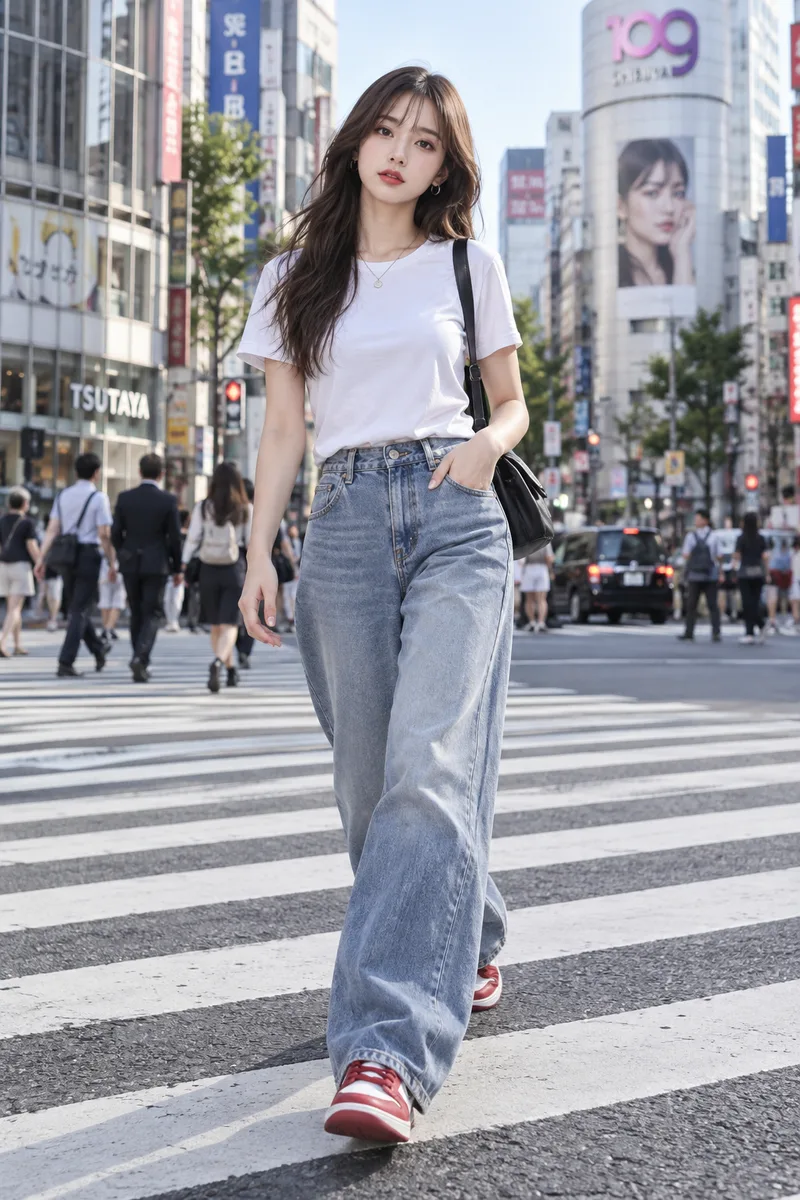
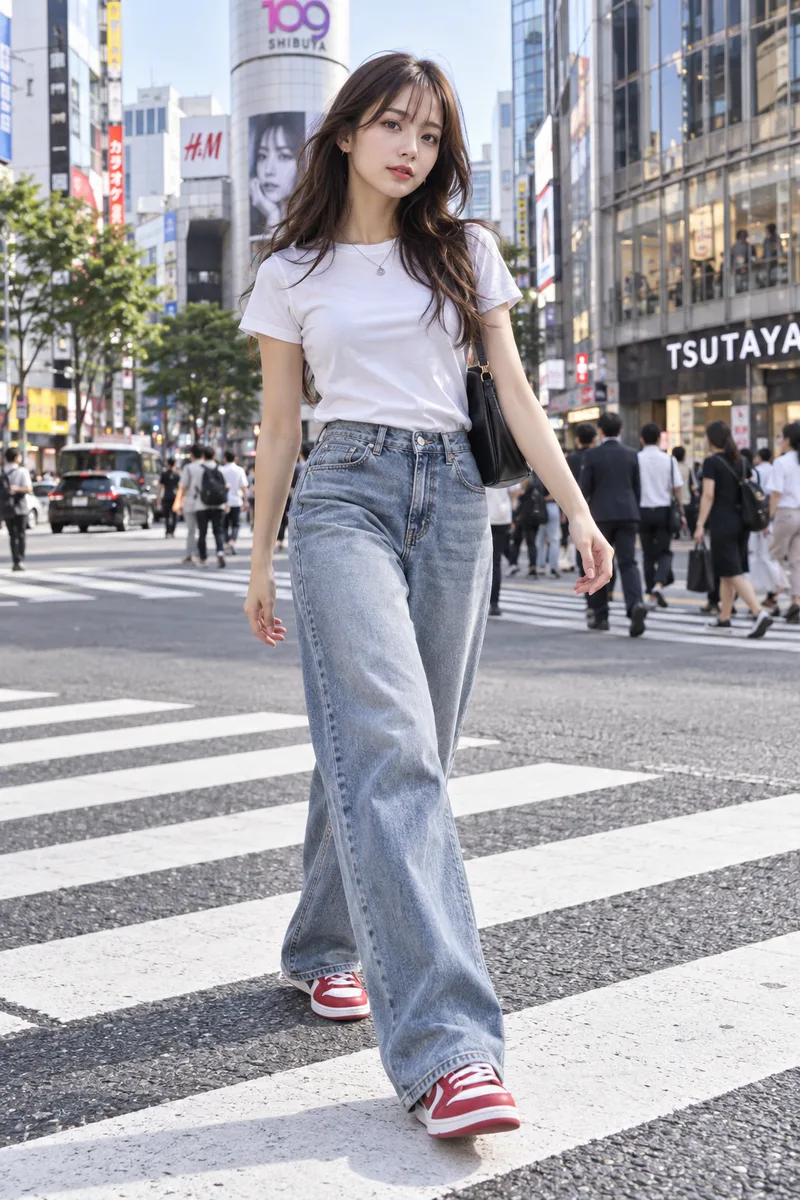
コツどおり足した言葉:full body visible, feet included
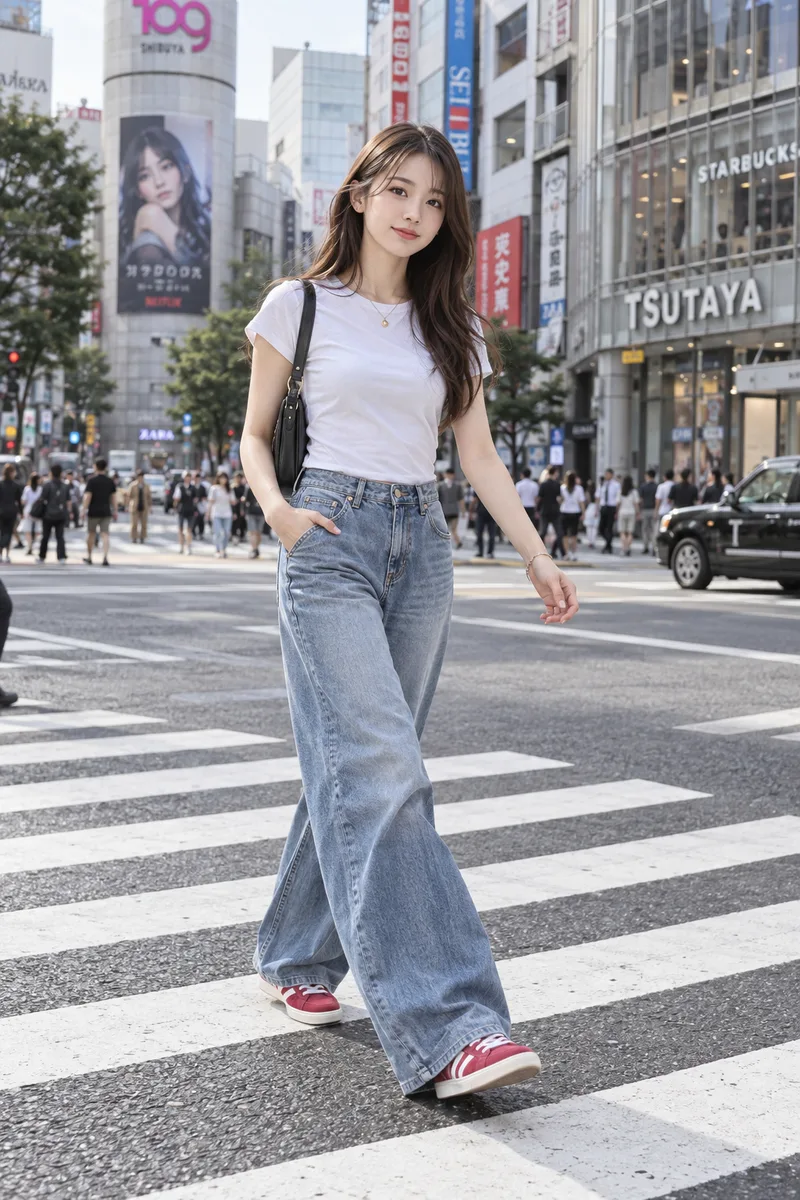
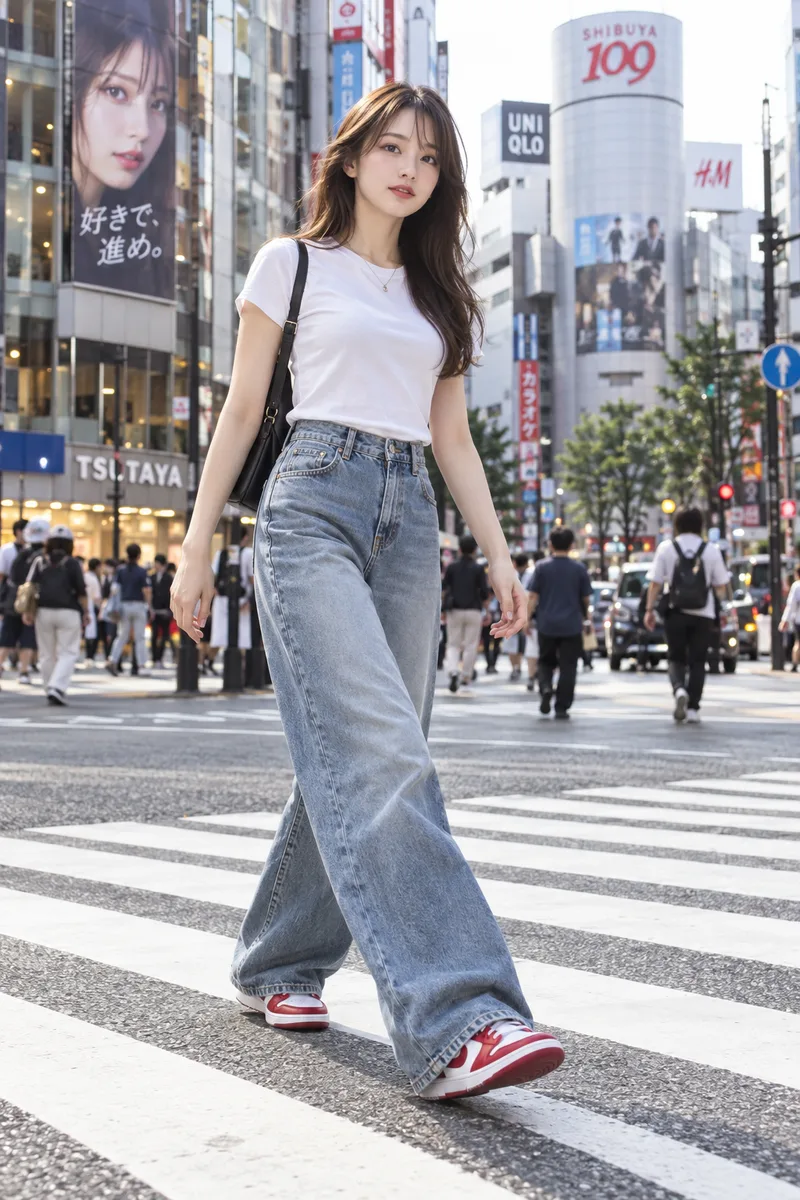
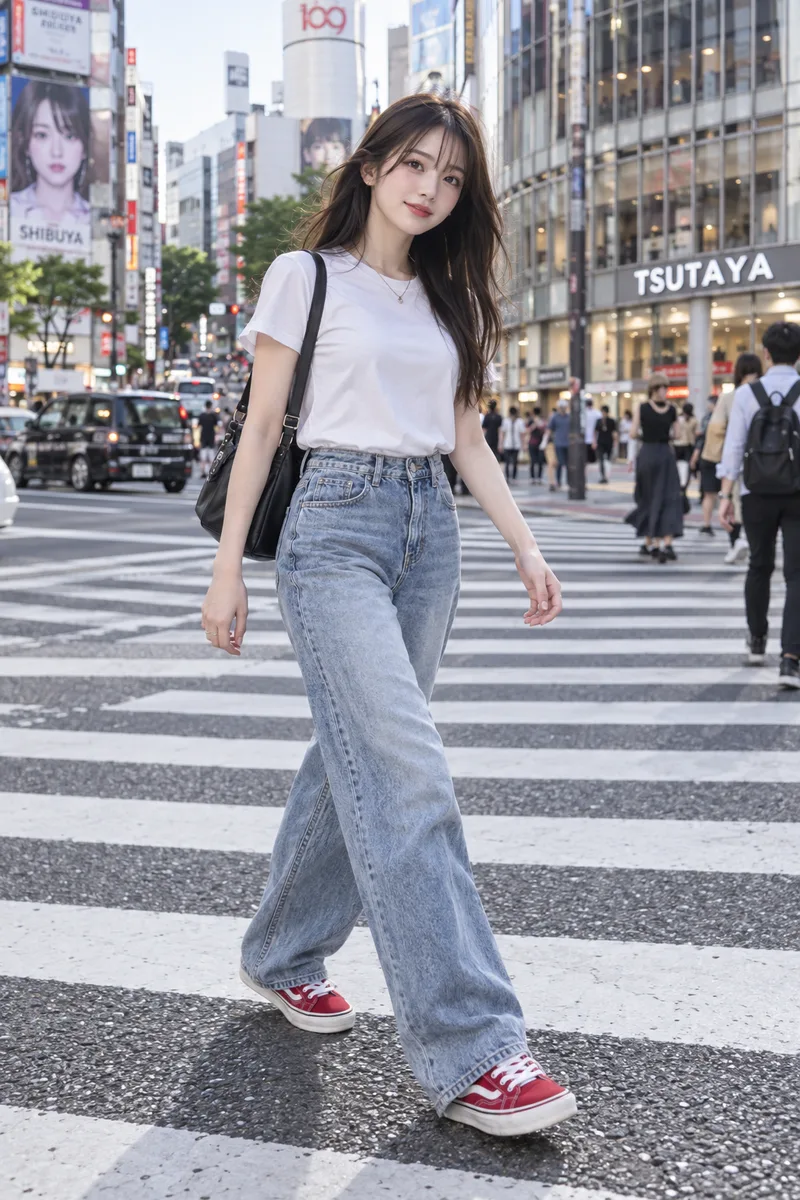
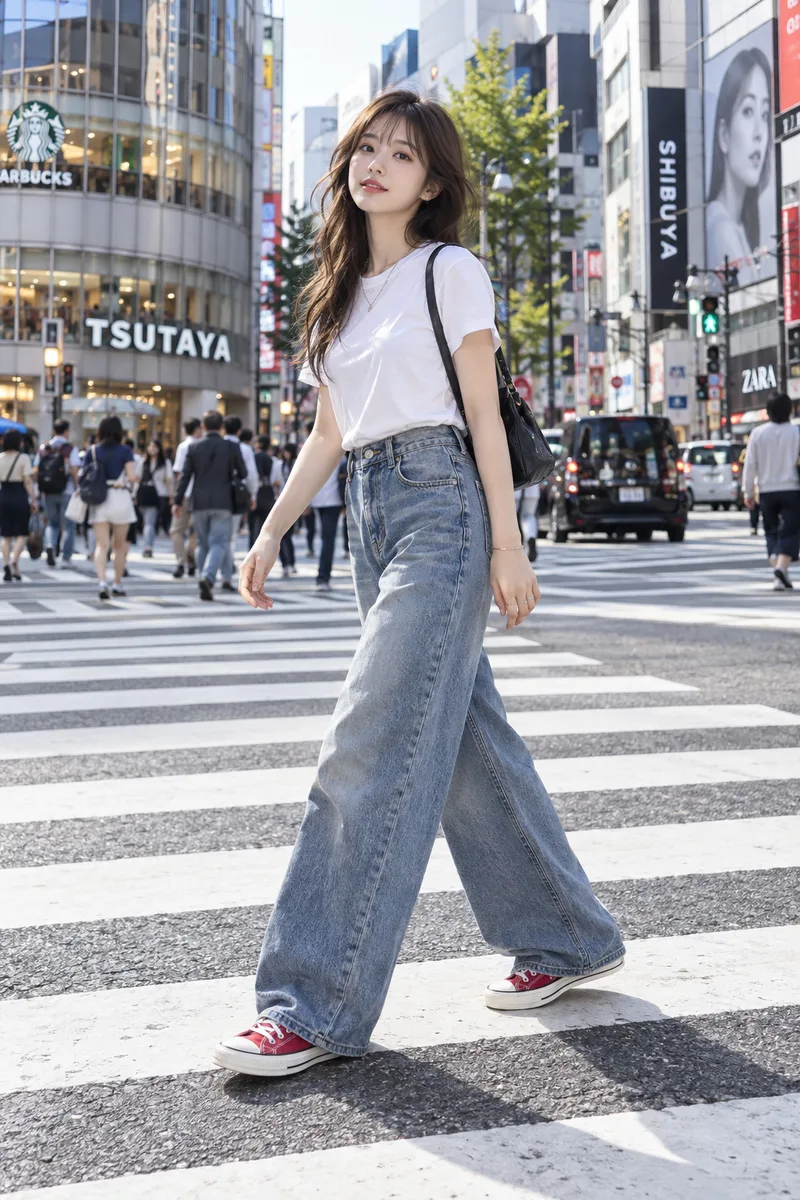
赤いスニーカーまで、full body だけで4枚とも全部入っています。feet included を足しても、何も変わりませんでした。足先が切れる問題は、今の ChatGPT ではもう起きにくいみたいです。
どちらも渋谷のスクランブル交差点のような場所になり、実在の店の看板が並びました。「横断歩道」と書いただけで渋谷に行くあたり、AI の中の東京は渋谷なんでしょうね。
コツ6:直すときは「ここだけ変えて」と残すものを書く
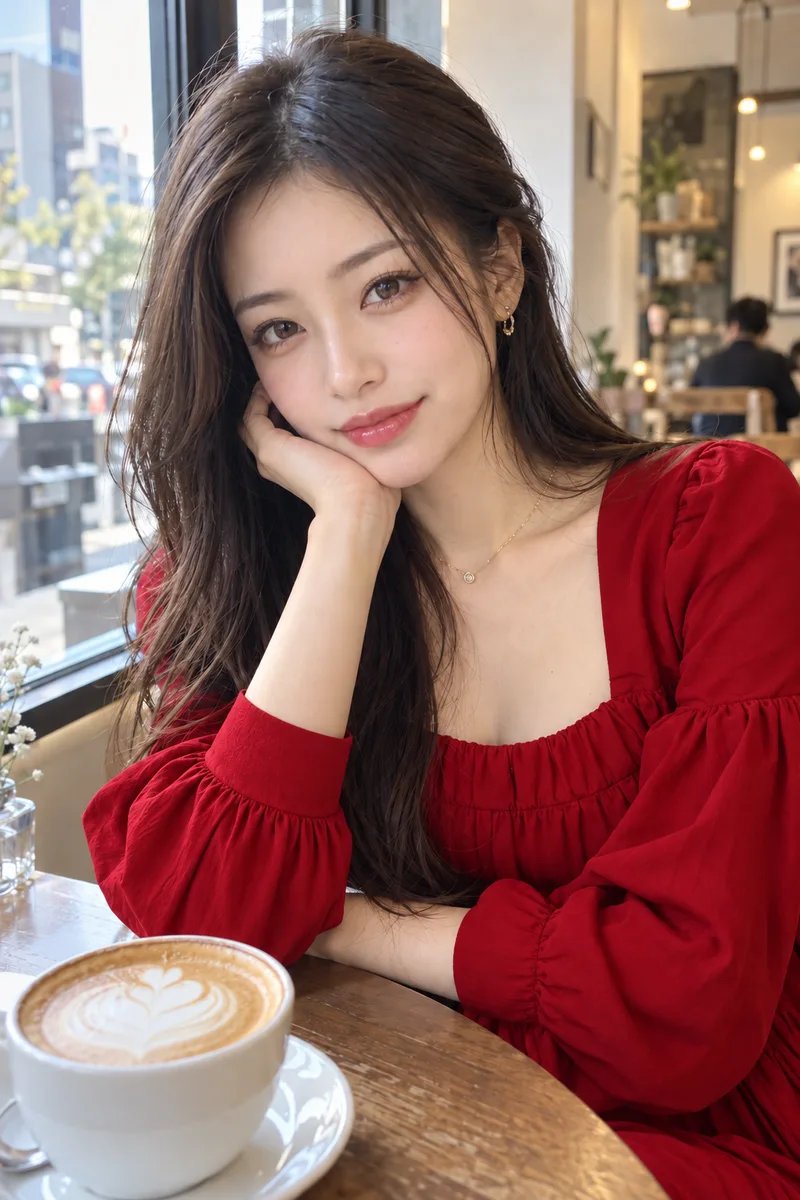
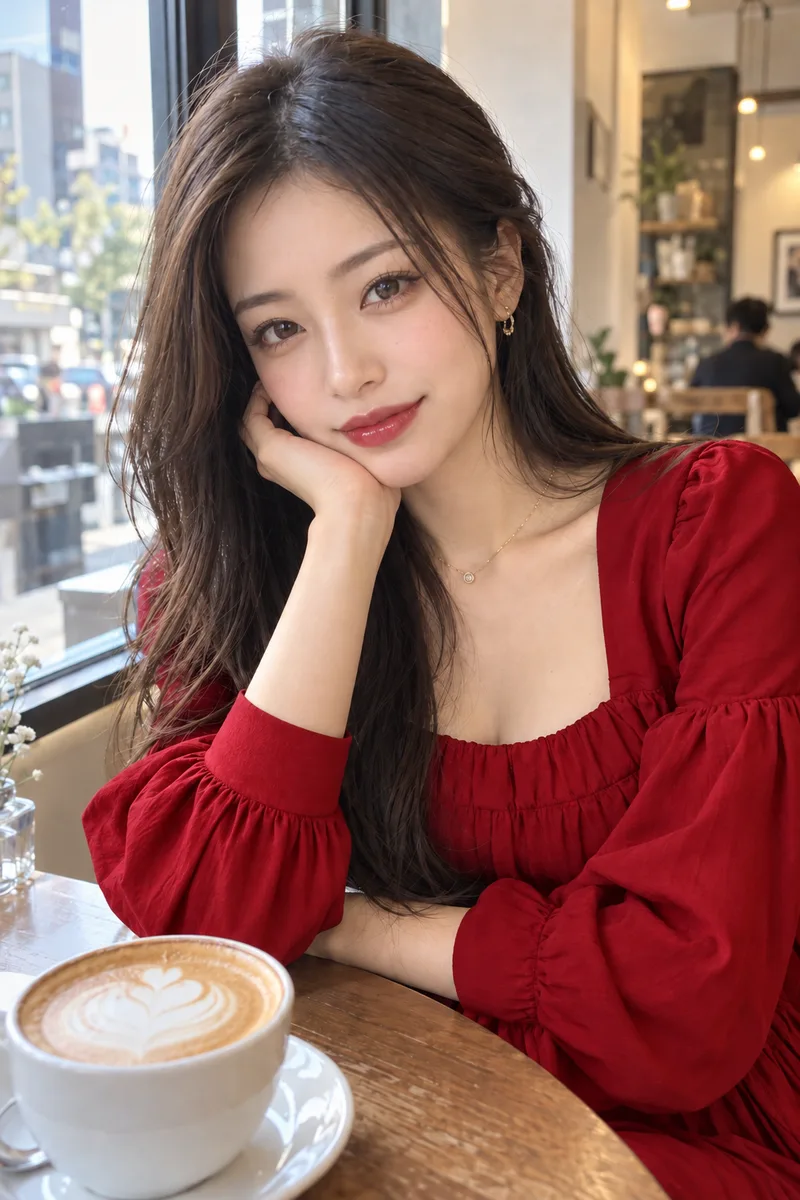
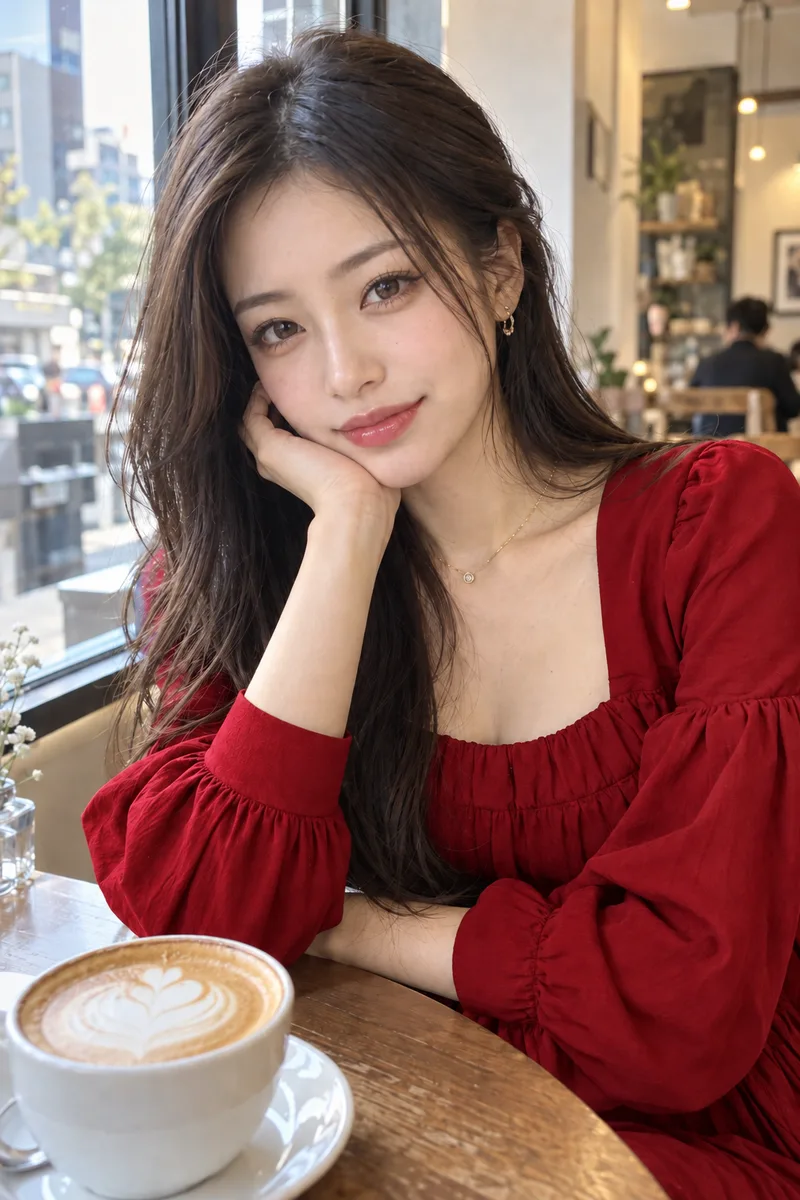
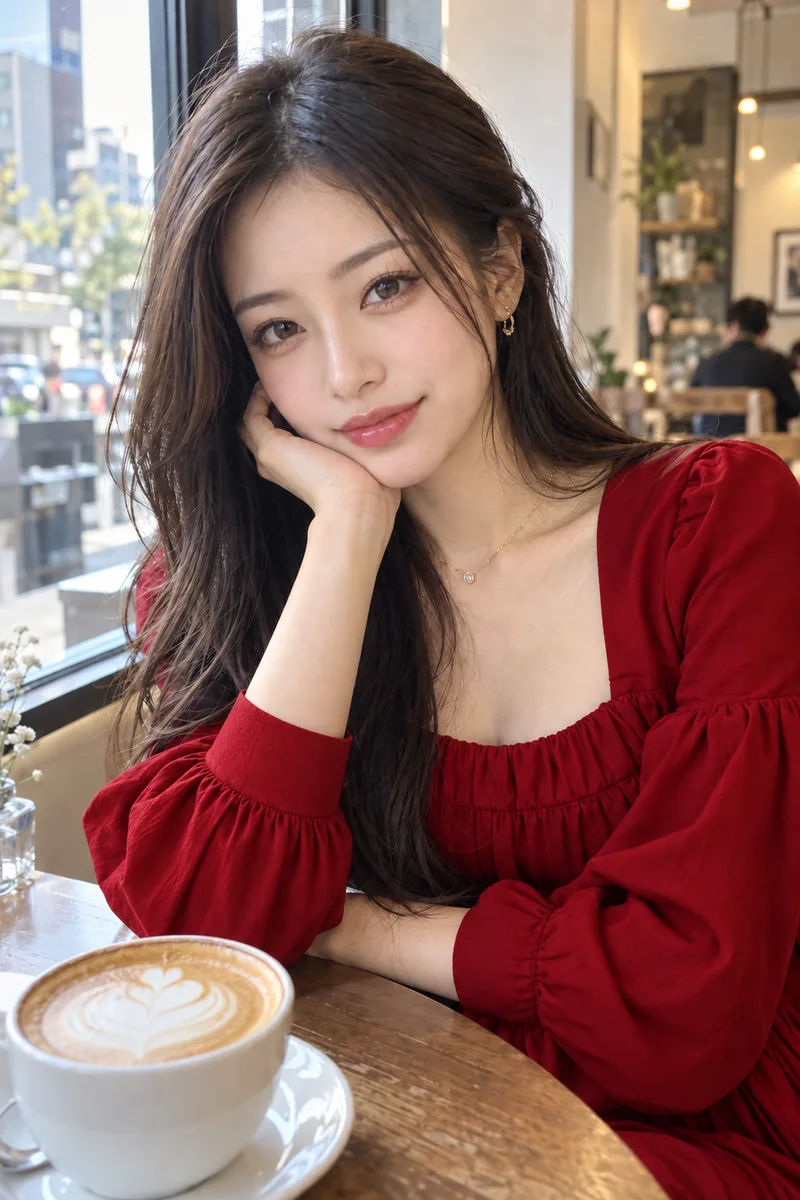
公式ガイドは、画像を直すときは「X だけを変えて(change only X)」と書き、顔・形・光など残すものを並べるように勧めています。この1枚を渡して、紺のワンピースを赤に変えてもらいました。
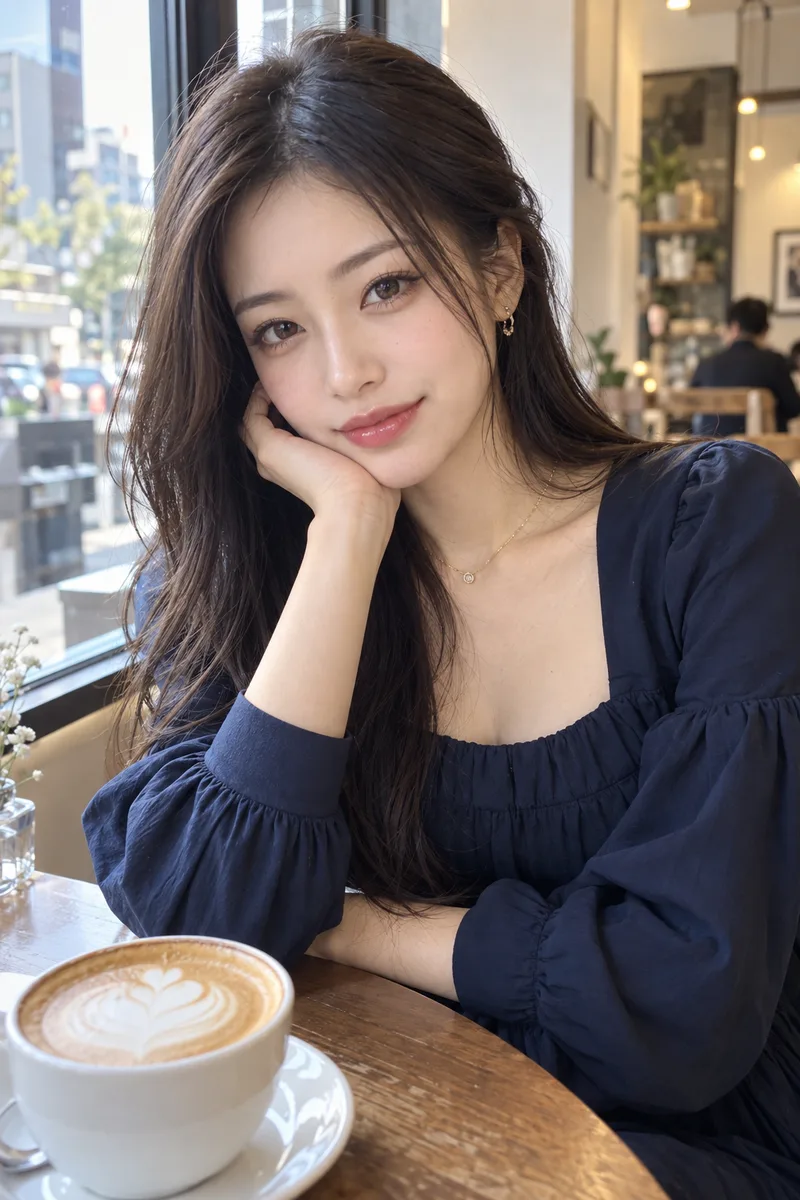
まずは、ひとことだけ。
書かなかった渡した画像と一緒に:Make her dress red.
次に、ガイドどおり、変えるものと残すものを全部書きました。
コツどおり渡した画像と一緒に:Change only the color of her dress to red. Keep her face, hairstyle …
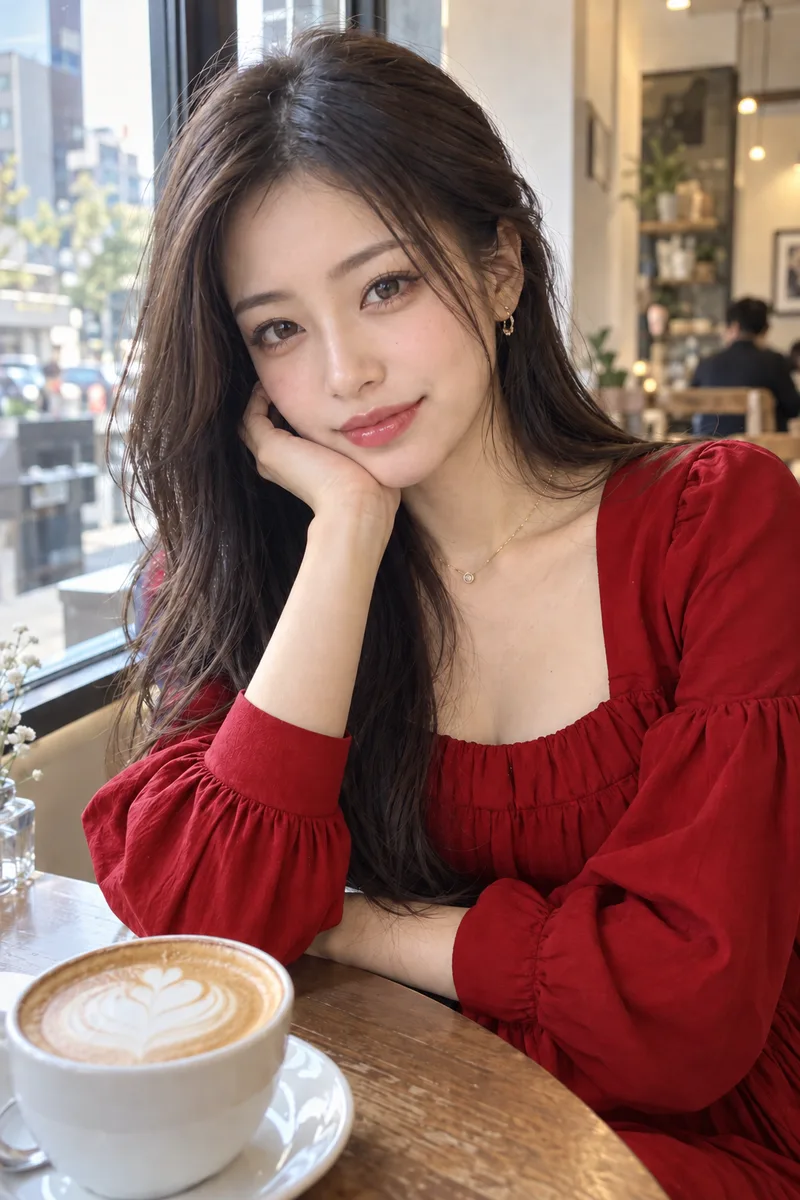
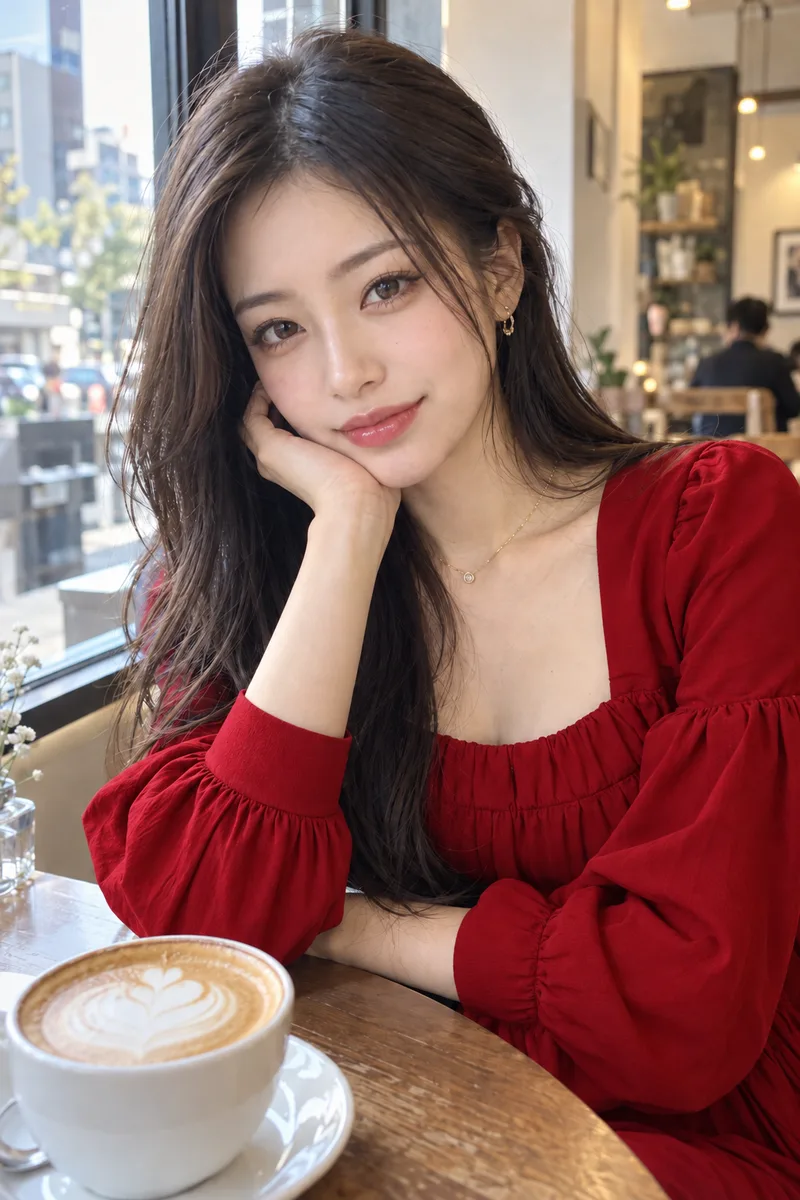
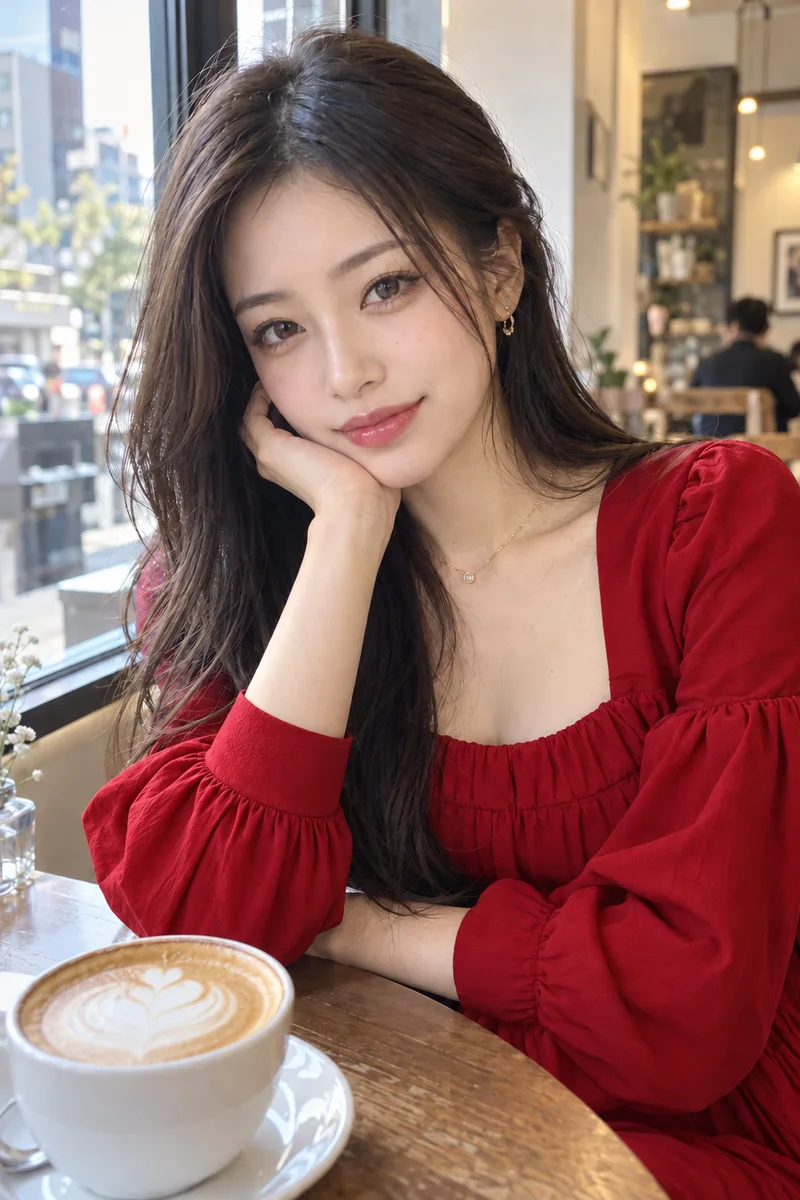
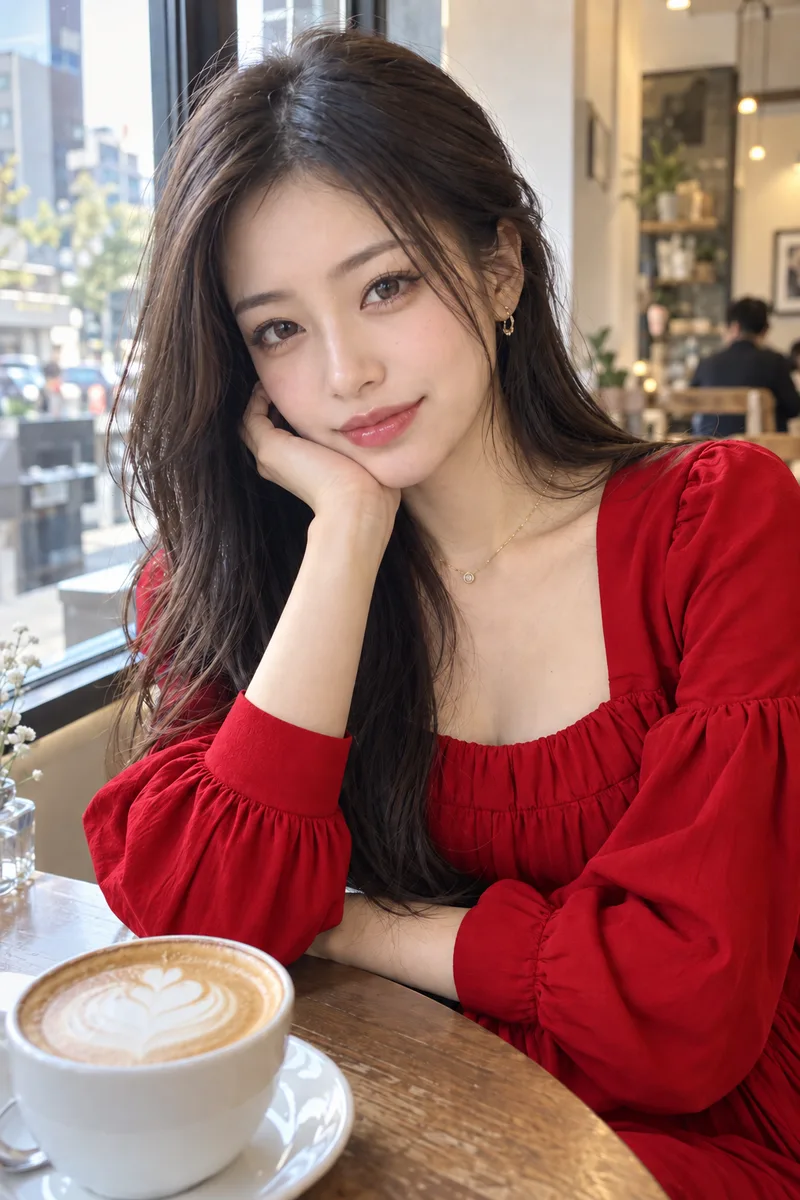
えっ、見分けがつかない。「赤にして」のひとことだけでも、顔・頬杖・ラテのハート・窓の外の街・奥のお客さんまで、元の画像のまま。服だけが赤になっています。8枚とも、それぞれ別に作った画像なのに、ほぼ同じでした。
直しの精度は、今の ChatGPT がいちばん進化したところかもしれません。ただ、ガイドは何度も直すうちに少しずつずれていく(drift)とも書いているので、2回目・3回目と重ねるときは、残すものを毎回書くのが安全だと思います。
よくある質問
日本語で書いても、コツは効きますか?
この記事は英語で試しました。夜の場面の書き込みのように「何を書くか」のコツは、日本語で書いても同じ考え方で使えます。AIっぽさを消す記事では、日本語で1つずつ足した書き方と英語の書き方で、写真らしさはほぼ同じでした。
JSON で書いたほうが効きますか?
公式ガイドは、文章・箇条書き・JSON のような形・タグのどれでも、読みやすく直しやすい形でよく、特別な書き方は要らない、としています。この記事でも、見出しで区切った書き方と1段落の書き方で、中身の伝わり方は同じでした。
画質の設定は変えたほうがいいですか?
公式ガイドの画質の設定(low〜max)は、API で使うときの話です。この記事では画質の設定には触れず、どの作例も同じ条件で作っています。
やりたいことから選ぶ書き方
| やりたいこと | 書き方 | この記事での結果 |
|---|---|---|
| 夜や雨の場面を思いどおりにしたい | 広さ・空気・色を書く(narrow side street・heavy rain・pink and cyan neon …) | 書いたものが4枚とも全部出た |
| 背景をぼかしたい | shot on a 85mm f/1.8 lens | 背景が大きくぼけた |
| 背景まではっきり写したい | shot on a 35mm lens | 後ろの木とビルまで写った |
| 「〜なし」を守らせたい | Scene・Subject・Details・Constraints の見出しで区切る | 文字なしが4枚とも守られた |
| 全身を足先まで入れたい | full body | それだけで足先まで入った |
| 服の色だけ変えたい | 画像を渡して Make her dress red. | 服以外はそのまま |
| 肌を自然にしたい | 肌の毛穴と赤みを書く(AIっぽさを消す記事) | 作り物っぽさが一番消えた |